Gemma 詳解:Gemma 3 的新變化
Note
最初發表於 Google Developers 部落格。
「Gemma 詳解」系列先前的文章詳細介紹了 Gemma 模型家族的架構。各篇文章的連結如下:
在這篇文章中,你將探索最新的模型 Gemma 3。讓我們深入了解。
Gemma 3
與先前版本相比,一項重大改變是 Gemma 3 新增了對視覺語言(vision-language)能力的支援。熟悉 PaliGemma 架構的人可能認得出 Gemma 3 使用的 SigLIP 編碼器,不過它已針對這個特定實作進行了調整。
以下是新模型的核心參數。
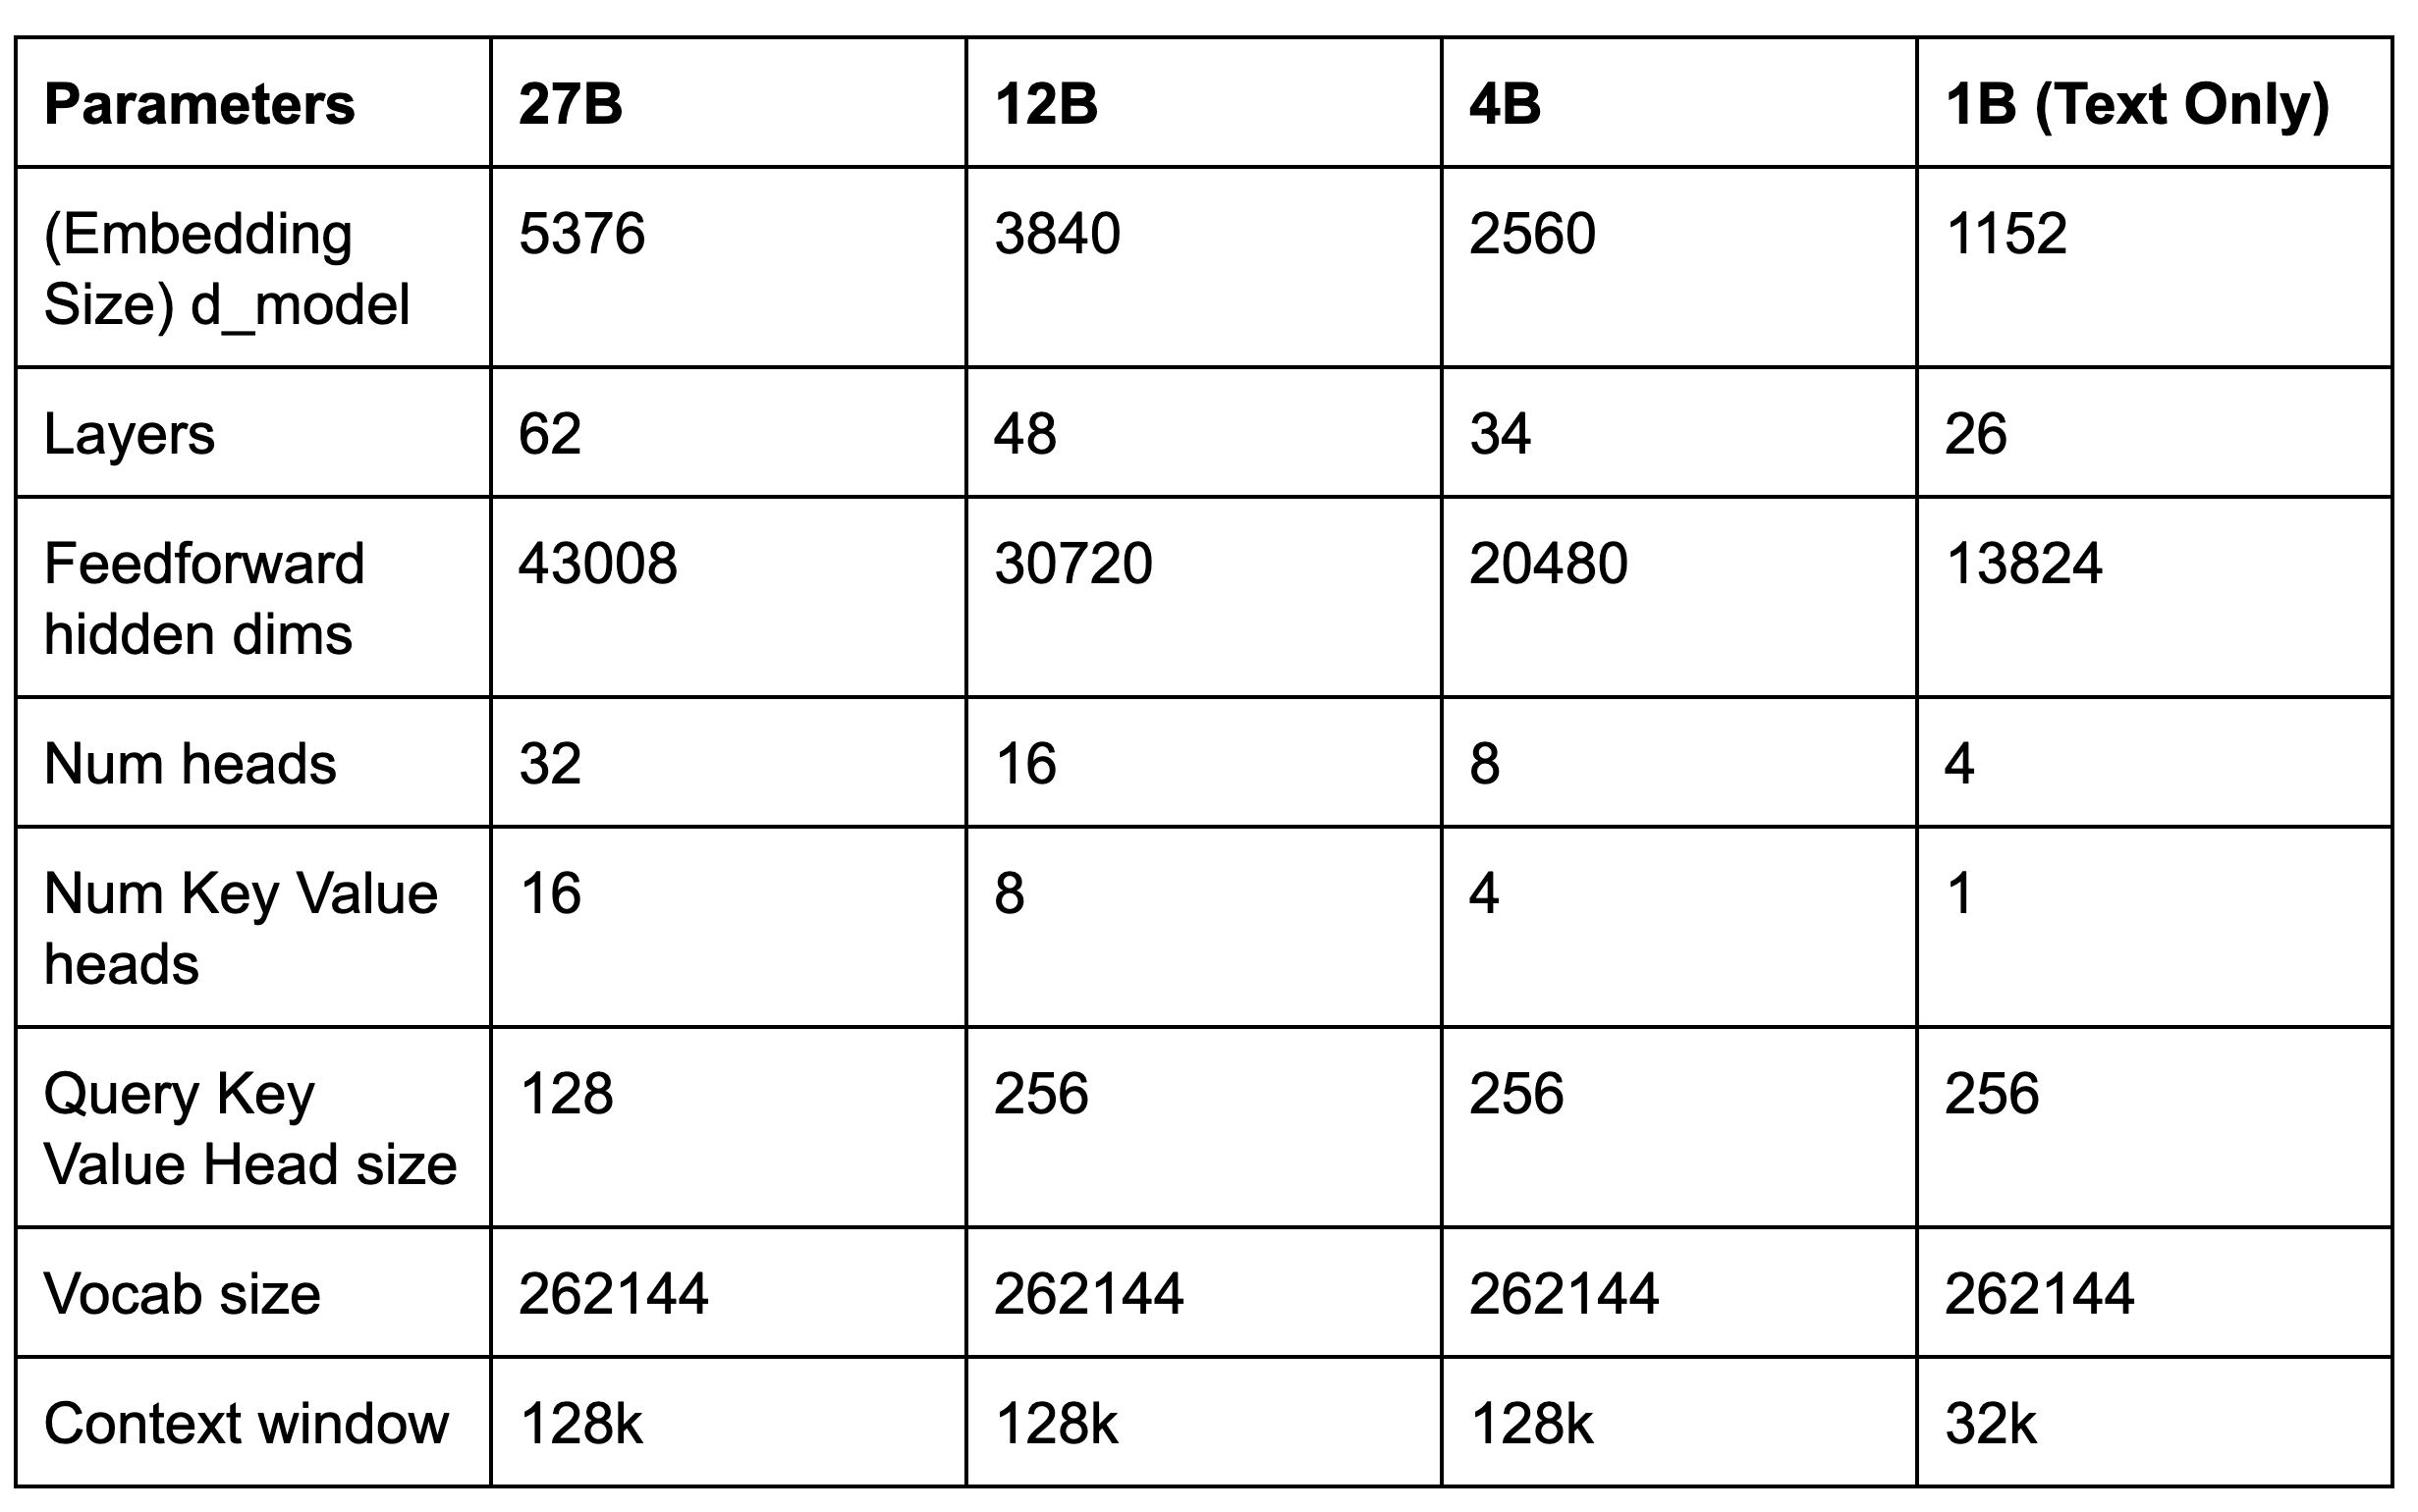
讓我們探索 Gemma 3 的主要差異與改進。
主要差異
Gemma 3 的架構雖繼承了前代的特點,但也包含了下面描述的新改良。
視覺語言支援
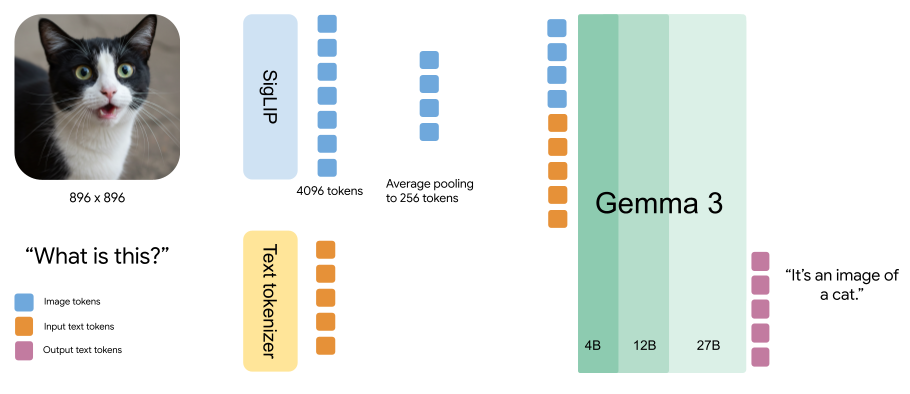
Gemma 3 的一項重大增強是其全新的視覺語言理解能力。4B、12B 與 27B 模型採用了客製化的 SigLIP 視覺編碼器,使模型能夠解讀視覺輸入。
視覺編碼器處理固定 896x896 的方形影像。為了處理不同長寬比或高解析度的影像,採用了一種「Pan&Scan」演算法:適應性地裁切影像,將每個裁切區塊縮放到 896x896,然後編碼。這種方法雖然能提升效能(特別是在細節資訊至關重要的情況下),但會增加推論時的運算開銷。
此外,Gemma 3 將影像視為由 MultiModalProjector 產生的緊湊「軟詞元」(soft tokens)序列。透過以固定數量的 256 個向量來表示視覺資料,這項技術大幅削減了影像處理所需的推論資源。
在繼續之前,你可能會想:「我該使用 Gemma 3 還是 PaliGemma 2?」
PaliGemma 2 的強項在於 Gemma 3 沒有的功能,如影像分割與物件偵測。然而,Gemma 3 整合並延伸了 PaliGemma 的技術,提供多輪對話與強大的零樣本效能,可直接處理各種視覺任務。
最終決策還應考慮你的可用運算資源,以及進階功能(如更長的上下文或多語言支援)的重要性——這些都是 Gemma 3 帶來顯著增強的面向。
提升記憶體效率的架構變更
架構經過修改以減少 KV-cache 的記憶體使用量,而 KV-cache 會隨著上下文變長而傾向於增加。
5 對 1 交錯注意力
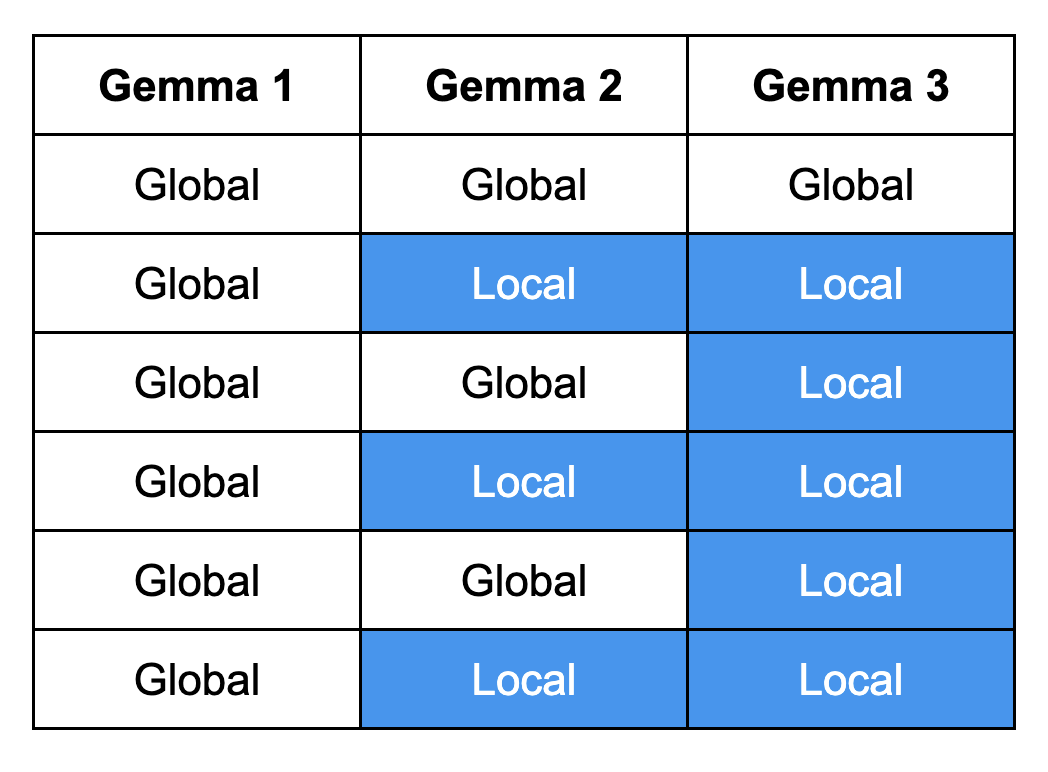
更新後的模型架構由重複的交錯區塊組成,每個區塊包含 5 層滑動視窗為 1024 的區域注意力層與 1 層全域注意力層。這種設計讓模型能同時捕捉短程與長程依賴,產出更準確、更符合上下文的回應。
Note
Gemma 1 完全依賴全域注意力,而 Gemma 2 以交替使用區域與全域注意力層引入了混合方法。Gemma 3 則整合了 5 層專用的區域注意力層,讓回應更精準且更符合上下文。
不再使用軟上限(No softcapping)
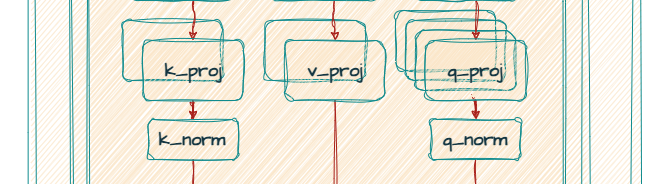
Gemma 2 與 Gemma 3 都使用分組查詢注意力(GQA),並以 RMSNorm 做前正規化與後正規化。然而,Gemma 3 以 QK-norm 取代 Gemma 2 的軟上限機制,同時獲得了更高的準確度與更快的處理速度。
更長的上下文
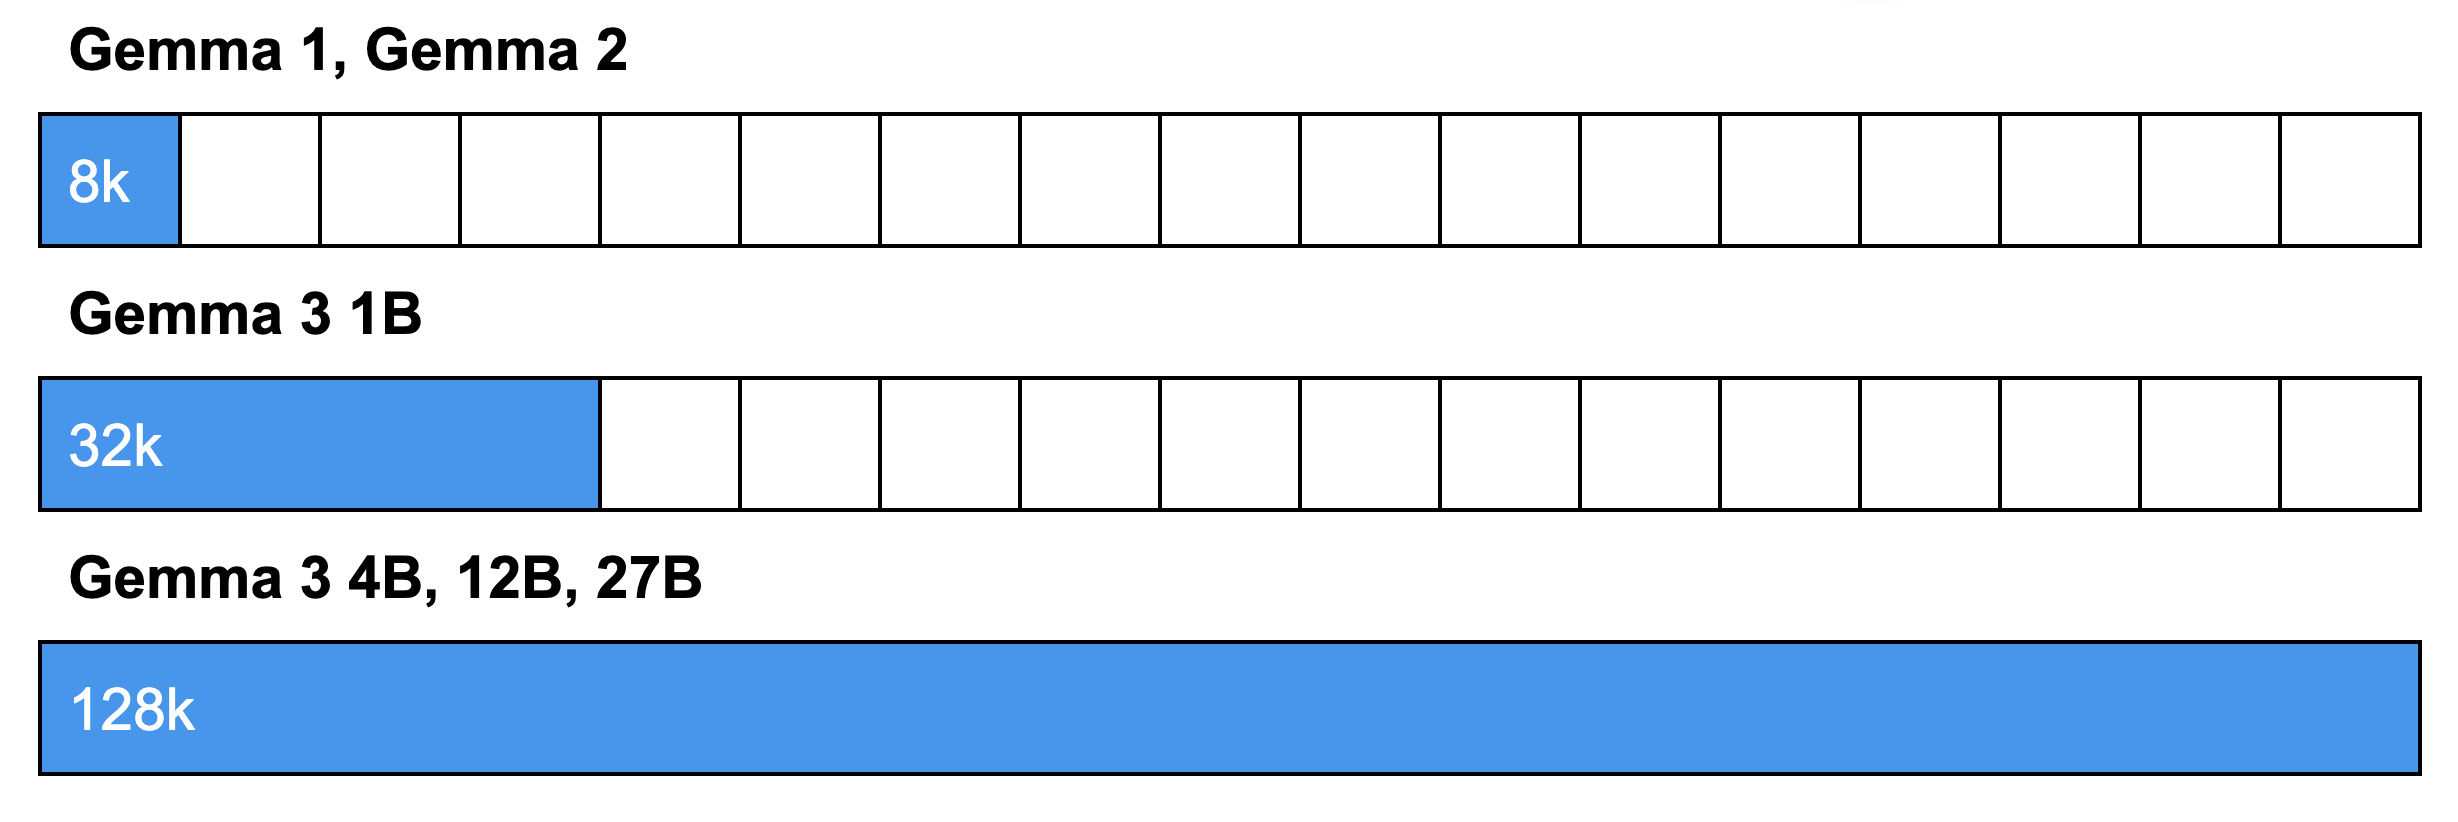
由於上述架構變更,Gemma 3 利用交錯注意力降低記憶體需求,從而支援更長的上下文長度。這使得分析更長的文件與對話時不會失去上下文。具體來說,1B 模型可處理 32k 詞元,較大的模型則可處理 128k 詞元。
Note
128k 詞元的上下文視窗讓模型能處理相當於一部典型小說(約 80k 單字)的文字量。這個視窗大小約等於 96k 單字、198 頁、500 張影像,或 1 fps 下 8 分鐘以上的影片。
視覺編碼器與處理
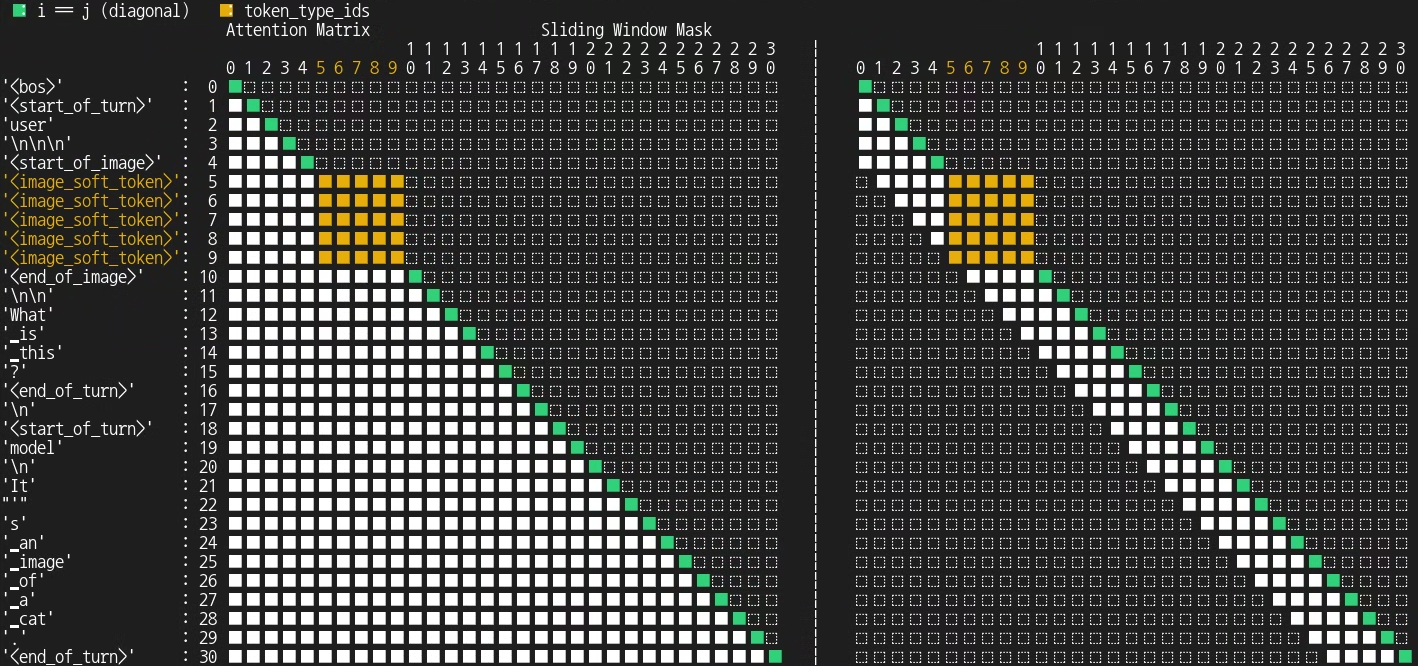
Gemma 3 對影像輸入僅使用雙向注意力。
一般注意力(又稱單向注意力)就像閱讀。想像你在讀書:你透過考慮之前的詞彙來理解每個詞。這就是語言模型中典型注意力的工作方式:它是序列式的,向後回顧以建立上下文。
另一方面,雙向注意力就像在看拼圖。把影像想成拼圖:「影像詞元」(Image Tokens)就像是單片拼圖。意思是每片拼圖都會「看」並連接影像中的每一片拼圖,無論它們的位置在哪。它一次考慮整張圖,而不是一個序列。這讓理解更完整,因為每個部分都與其他每個部分相關。
那為什麼不總是使用雙向注意力呢?雖然雙向注意力(看到完整上下文)聽起來更好,但並非總是適用於文字。這完全取決於任務:
-
理解(雙向注意力好):對於擁有完整文字且需要深入理解的任務(如 BERT 這類模型),雙向注意力非常適合。
-
預測(單向注意力更好):當任務是預測下一個詞或生成文字時,單向(自迴歸)方法更自然。預測接下來會出現什麼本質上就是序列式的,而且通常運算效率也更高。
關鍵差異在於:雙向方法用於模型不產出序列的情況。
下方的視覺化展示了 Gemma 3 的注意力機制。
程式碼:
from transformers.utils.attention_visualizer import AttentionMaskVisualizer
visualizer = AttentionMaskVisualizer("google/gemma-3-4b-it")
visualizer("<start_of_turn>user\n<img>What is this?<end_of_turn>\n<start_of_turn>model\nIt's an image of a cat.<end_of_turn>")
輸出:
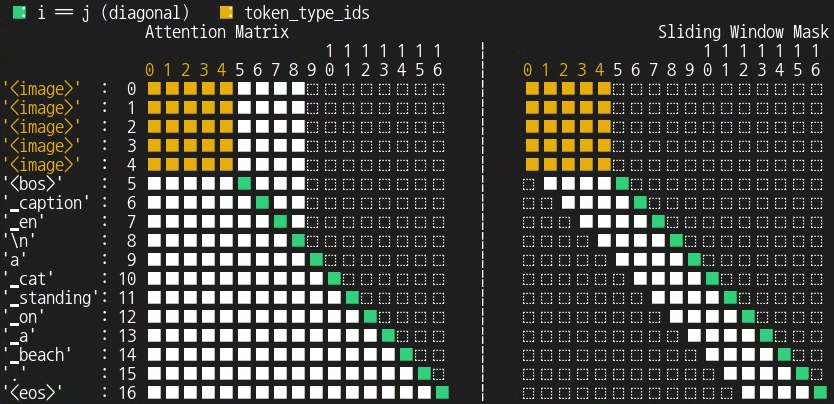
你也可以看到這種注意力機制與 PaliGemma 的差異。為了讓比較更有脈絡:PaliGemma 的運作方式是接收一張或多張影像,以及文字形式的任務描述(提示或前綴),然後以自迴歸方式產生文字字串形式的預測(答案或後綴)。
程式碼:
visualizer = AttentionMaskVisualizer("google/paligemma2-3b-mix-224")
visualizer("<img> caption en", suffix="a cat standing on a beach.")
輸出
新分詞器
Gemma 3 的多語言能力有所提升,原因是重新設計的資料混合增加了多語言資料的比例(包含單語與平行語料)。
Gemma 3 也引入了改良的分詞器。詞彙表大小改為 262k,但使用相同的 SentencePiece 分詞器。為避免錯誤,使用 Gemma 3 時請搭配新的分詞器。這是與 Gemini 相同的分詞器,對非英語語言更加平衡。
Gemma 3 27B
Gemma3ForConditionalGeneration(
  (vision_tower): SiglipVisionModel(
    (vision_model): SiglipVisionTransformer(
      (embeddings): SiglipVisionEmbeddings(
        (patch_embedding): Conv2d(3, 1152, kernel_size=(14, 14), stride=(14, 14), padding=valid)
        (position_embedding): Embedding(4096, 1152)
      )
      (encoder): SiglipEncoder(
        (layers): ModuleList(
          (0-26): 27 x SiglipEncoderLayer(
            (self_attn): SiglipSdpaAttention(
              (k_proj): Linear(in_features=1152, out_features=1152, bias=True)
              (v_proj): Linear(in_features=1152, out_features=1152, bias=True)
              (q_proj): Linear(in_features=1152, out_features=1152, bias=True)
              (out_proj): Linear(in_features=1152, out_features=1152, bias=True)
            )
            (layer_norm1): LayerNorm((1152,), eps=1e-06, elementwise_affine=True)
            (mlp): SiglipMLP(
              (activation_fn): PytorchGELUTanh()
              (fc1): Linear(in_features=1152, out_features=4304, bias=True)
              (fc2): Linear(in_features=4304, out_features=1152, bias=True)
            )
            (layer_norm2): LayerNorm((1152,), eps=1e-06, elementwise_affine=True)
          )
        )
      )
      (post_layernorm): LayerNorm((1152,), eps=1e-06, elementwise_affine=True)
    )
  )
  (multi_modal_projector): Gemma3MultiModalProjector(
    (mm_soft_emb_norm): Gemma3RMSNorm((1152,), eps=1e-06)
    (avg_pool): AvgPool2d(kernel_size=4, stride=4, padding=0)
  )
  (language_model): Gemma3ForCausalLM(
    (model): Gemma3TextModel(
      (embed_tokens): Gemma3TextScaledWordEmbedding(262208, 5376, padding_idx=0)
      (layers): ModuleList(
        (0-61): 62 x Gemma3DecoderLayer(
          (self_attn): Gemma3Attention(
            (q_proj): Linear(in_features=5376, out_features=4096, bias=False)
            (k_proj): Linear(in_features=5376, out_features=2048, bias=False)
            (v_proj): Linear(in_features=5376, out_features=2048, bias=False)
            (o_proj): Linear(in_features=4096, out_features=5376, bias=False)
            (q_norm): Gemma3RMSNorm((128,), eps=1e-06)
            (k_norm): Gemma3RMSNorm((128,), eps=1e-06)
          )
          (mlp): Gemma3MLP(
            (gate_proj): Linear(in_features=5376, out_features=21504, bias=False)
            (up_proj): Linear(in_features=5376, out_features=21504, bias=False)
            (down_proj): Linear(in_features=21504, out_features=5376, bias=False)
            (act_fn): PytorchGELUTanh()
          )
          (input_layernorm): Gemma3RMSNorm((5376,), eps=1e-06)
          (post_attention_layernorm): Gemma3RMSNorm((5376,), eps=1e-06)
          (pre_feedforward_layernorm): Gemma3RMSNorm((5376,), eps=1e-06)
          (post_feedforward_layernorm): Gemma3RMSNorm((5376,), eps=1e-06)
        )
      )
      (norm): Gemma3RMSNorm((5376,), eps=1e-06)
      (rotary_emb): Gemma3RotaryEmbedding()
      (rotary_emb_local): Gemma3RotaryEmbedding()
    )
    (lm_head): Linear(in_features=5376, out_features=262208, bias=False)
  )
)
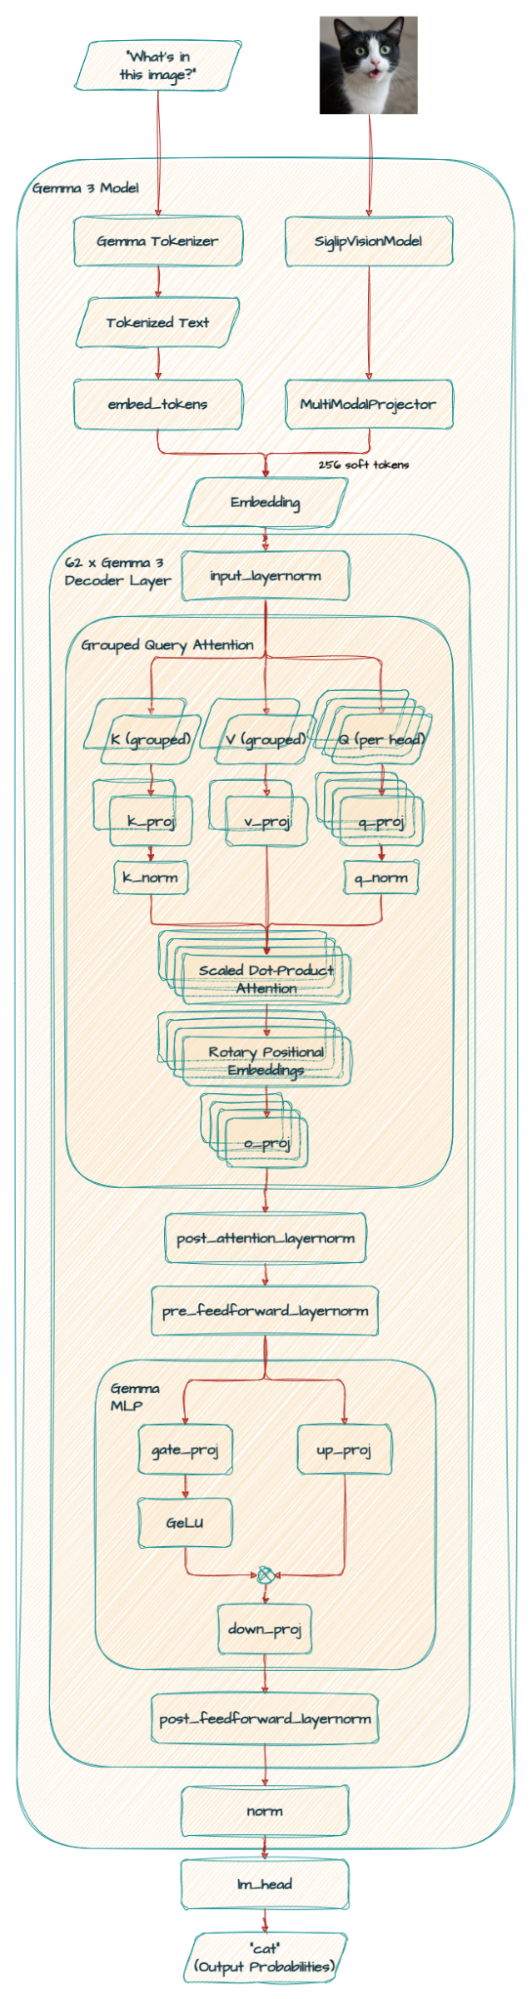
Note
嚴格來說,RoPE(旋轉位置嵌入)位於 SDPA(縮放點積注意力)內部,但我們在這張圖中將其簡化了。精確的架構細節請參閱程式碼。
Gemma 3 1B
Gemma3ForCausalLM(
  (model): Gemma3TextModel(
    (embed_tokens): Gemma3TextScaledWordEmbedding(262144, 1152, padding_idx=0)
    (layers): ModuleList(
      (0-25): 26 x Gemma3DecoderLayer(
        (self_attn): Gemma3Attention(
          (q_proj): Linear(in_features=1152, out_features=1024, bias=False)
          (k_proj): Linear(in_features=1152, out_features=256, bias=False)
          (v_proj): Linear(in_features=1152, out_features=256, bias=False)
          (o_proj): Linear(in_features=1024, out_features=1152, bias=False)
          (q_norm): Gemma3RMSNorm((256,), eps=1e-06)
          (k_norm): Gemma3RMSNorm((256,), eps=1e-06)
        )
        (mlp): Gemma3MLP(
          (gate_proj): Linear(in_features=1152, out_features=6912, bias=False)
          (up_proj): Linear(in_features=1152, out_features=6912, bias=False)
          (down_proj): Linear(in_features=6912, out_features=1152, bias=False)
          (act_fn): PytorchGELUTanh()
        )
        (input_layernorm): Gemma3RMSNorm((1152,), eps=1e-06)
        (post_attention_layernorm): Gemma3RMSNorm((1152,), eps=1e-06)
        (pre_feedforward_layernorm): Gemma3RMSNorm((1152,), eps=1e-06)
        (post_feedforward_layernorm): Gemma3RMSNorm((1152,), eps=1e-06)
      )
    )
    (norm): Gemma3RMSNorm((1152,), eps=1e-06)
    (rotary_emb): Gemma3RotaryEmbedding()
    (rotary_emb_local): Gemma3RotaryEmbedding()
  )
  (lm_head): Linear(in_features=1152, out_features=262144, bias=False)
)
這個純文字的 1B 模型專為裝置端使用最佳化,讓行動與嵌入式系統也能使用先進的 AI。這對可及性、隱私與效能都有顯著影響,因為 AI 應用現在即使在網路受限或無網路的情況下也能高效運作。
主要發現
我們的技術報告提供了深入的細節,以下是 Gemma 3 主要發現的快速摘要:
-
相同規模下更優異的效能:Gemma 3 模型在各種基準測試中,無論是預訓練版還是指令微調版,效能都超越 Gemma 2。它是能在單張消費級 GPU 或 TPU 主機上運行的最佳模型。截至 2025 年 4 月 12 日,Gemma 27B IT 模型在 LM Arena 名列前十,超越了體積大得多的開放模型,Elo 分數也遠高於 Gemma 2。
-
KV-cache 記憶體減少:與 Gemma 1 僅使用全域注意力、Gemma 2 使用 1:1 區域/全域比例的機制相比,Gemma 3 的架構變更有效降低了長上下文推論期間 KV cache 的記憶體開銷。
-
有效處理長上下文:Gemma 3 模型在預訓練期間經過 RoPE 重縮放後,可泛化到 128k 上下文長度。我們將全域自注意力層的 RoPE 基礎頻率從 10k 提高到 1M,區域層的頻率則維持在 10k。
-
改進的多語言能力:Gemma 3 使用與 Gemini 相同的分詞器,對非英語語言更加平衡。我們也修訂了預訓練資料混合與後訓練流程,以增強其多語言能力。
-
視覺編碼器解析度的影響:更高解析度的視覺編碼器在視覺任務上表現更好。Pan & Scan 方法進一步提升了處理非方形長寬比、高解析度影像與影像中文字讀取等任務的效能。
總結
我們探索了 Gemma 3 的架構,重點介紹了它與先前版本不同的新功能。這些架構選擇讓 Gemma 3 在更廣泛的任務上表現更好,包括改進的多語言能力與影像互動,同時也為未來更強大、更省資源的多模態語言模型鋪路,使其能運行於標準硬體上。
我們相信 Gemma 3 的創新將賦能研究人員與開發者,打造下一代高效且強大的多模態語言模型。
感謝閱讀!