DiffusionGemma 視覺導覽
Note
原刊載於 探索語言模型。
在 Gemma 4 12B 發布之後,又有一款創新的模型可以介紹給大家,那就是 DiffusionGemma!
這個模型特別令我興奮,因為它採用了一種截然不同的文字生成方式,卻同時沿用了現有「一般」LLM 的許多優點。我們將探索舊的、新的一切,以及它們如何並存。

在這份導覽中,我會談到很多內容,因為 DiffusionGemma 的特別之處實在太多了!你將學到擴散的一般概念、擴散如何用在離散文字上、DiffusionGemma 的架構,以及所有有趣的技術。
準備好了,這會是一趟很有趣的探索之旅 ;)
自迴歸模型面臨的問題
自迴歸大型語言模型一次生成一個詞元,而且在同時服務多位使用者時表現出色。為什麼?因為為單一使用者生成一個詞元的運算成本出乎意料地低。每個步驟中,生成詞元的大部分時間都花在從記憶體載入權重上,而不是真正的計算。

在解碼過程中,這些一般的 Transformer 模型是記憶體受限(memory bound)而非運算受限(compute bound)。這表示,例如,為一位使用者生成一個詞元所需的時間,和為 256 位使用者生成一個詞元的時間是一樣的。
原因在於,每個步驟只需要從記憶體載入一次權重,無論服務的使用者有多少。這表示,不管是把這些權重乘上 1 位使用者的向量,還是 256 位使用者的向量,把權重搬進記憶體的成本都一樣。把所有使用者批次處理在一起,我們就能以幾乎相同的成本完成相同的工作量。
不過這並非免費的午餐,超過某個臨界點之後(取決於晶片本身),LLM 可能會因為服務的使用者太多而轉為運算不足。你可以用屋頂線圖(roofline plot)來視覺化這個取捨:它顯示了提升晶片效能(生成詞元所需的時間)相對於晶片記憶體(從記憶體載入資料的速度)的影響。
當只服務一位使用者(批次大小為 1)時,LLM 是記憶體受限的:它載入了大量的權重,卻沒做多少實際運算。批次大小越大(記憶體載入量相同但運算量增加),就越接近「轉折點」,硬體才會被充分利用。
因此,批次處理雖然很適合同時服務多位使用者,但對個別使用者來說並沒有好處!他們收到詞元的速度還是一樣,延遲沒有任何差別。
DiffusionGemma 徹底翻轉了這個局面。
如果我們把單一使用者的運算閒置時間用起來呢?與其為 256 位使用者各生成 1 個詞元,不如一次為 1 位使用者生成 256 個詞元?
這就是 DiffusionGemma 的核心概念!模型從一串由 256 個隨機初始化詞元組成的序列(稱為畫布)開始,試著同時為整個畫布挑選更好的詞元。一次預測 256 個詞元,256 個詞元的運算預算現在集中在單一使用者身上,而不是分散給多位使用者。

當然,一次預測這麼多詞元非常困難,模型在不知道前面是什麼詞元的情況下,很難預測第 254 個詞元。注意前兩個詞元的品質很好,但越到後面就越像胡言亂語。DiffusionGemma 在畫布上的第一輪預測,通常在畫布開頭產生相當準確的詞元,但越到末尾品質越差。

那麼,與其只跑一輪,不如多跑幾輪呢?
這就是迭代精煉(iterative refinement)的登場時機。模型利用上一次的預測,再次對畫布進行掃描。正確的詞元(機率仍很高的那些)幫助模型更深入地猜測畫布後半部的內容。每一輪,模型都會改善先前機率較低或被不準確詞元包圍的詞元。經過多次迭代後,畫布會收斂成與一般 Transformer 模型品質相近的文字,只是對單一使用者來說快得非常多。主要原因是模型的前向傳播次數遠少於它生成的詞元數量。

看,我們剛剛就從一般 Transformer 模型的下一個詞元預測,進化到一次生成 256 個詞元了!
雖然兩者都用多個步驟產生輸出,但一般 Transformer 每個步驟生成一個詞元,而 DiffusionGemma 每個步驟都用來改善畫布。讓這成為可能的技術叫做擴散(diffusion),它在圖像生成領域流行起來,與迭代精煉的概念密切相關。
與記憶體受限的自迴歸 LLM 不同,擴散 LLM 是運算受限的,運算資源越多、擴展速度越快。

這就是自迴歸 LLM 與擴散 LLM 的主要差異:它們處理相同詞元的方式不同。自迴歸 LLM 每個前向傳播生成一個詞元,在服務單一使用者時是記憶體受限的;擴散 LLM 每個前向傳播生成一串詞元,是運算受限的。

接下來,讓我們更深入地探索擴散,以及 DiffusionGemma 如何把圖像生成的原理應用到文字生成上。
什麼是擴散?
擴散是一種圖像生成過程,圍繞著「雜訊」打轉。
圖像的擴散
擴散是一種圖像生成過程,核心是從圖像中去除「雜訊」。從一張隨機初始化的圖像(100%「雜訊」)開始,擴散會在每一個後續步驟中試著降低雜訊量。在圖像生成中,這個過程由提示引導。經過足夠的步驟後,最終會生成或「揭露」出一張圖像。

降低圖像雜訊量的過程叫做去噪(denoising)。從圖中可以看到,這是一個迭代且循序的過程。每一步,你都比上一步更清楚地看到圖像,到最後,完整的圖像就呈現出來。這個原理不僅是圖像擴散的核心,如你稍後會看到的,也是 DiffusionGemma 的核心。
這個去噪過程由兩大原則引導:前向擴散與反向擴散。
前向擴散
要讓模型學會如何對圖像去噪,首先需要一些訓練資料。這些資料包含圖像/文字配對。對每一組配對,你會在圖像上加上一定量的隨機(高斯)雜訊。

這個過程叫做前向擴散。它從現有資料創造新資料,為訓練過程加上一個訊號。
反向擴散
反向擴散則反過來,試著訓練模型去預測我們加到原始資料上的雜訊。這樣的訓練資料就有了一個明確的預測目標:雜訊。你實際上是在告訴模型:這裡有一張有雜訊的圖像,我要你只預測出雜訊。

那為什麼我們要在圖像裡加雜訊,然後再試著預測它?
因為我們可以把預測出的雜訊從有雜訊的圖像中減掉,讓它更接近模型訓練時的圖像。這樣迭代操作,就可以從完全的雜訊開始,慢慢去噪,直到圖像中不再有雜訊。

前向擴散(生成有雜訊的訓練資料)與反向擴散(對有雜訊的輸入資料去噪)合在一起,就構成了這個把圖像「破壞再修復」的過程。

請注意,在圖像擴散中,這個過程由提示引導,提示是額外的訊號,用來決定什麼是雜訊、什麼不是。沒有指引的話,模型根本不知道一開始該創造什麼。
負責引導這個過程的叫做編碼器,它處理輸入的查詢,並理解背後的語義含義。編碼器的輸出會傳給擴散模型,引導它生成你查詢中的圖像。沒有編碼器,擴散模型就無從知道第一步的 100% 雜訊該變成什麼。
兩者合在一起構成完整管線,由兩個主要架構組成:
- 去噪器 – 用來迭代地從有雜訊的輸入去除雜訊的模型(例如擴散模型)。
- 編碼器 – 用來處理輸入查詢的模型(例如編碼器語言模型)。

如同前面所示,擴散模型也叫做去噪器,因為它的主要工作就是從有雜訊的輸入中去除雜訊。接下來我們都會使用這個名稱,來彰顯這個模型的目的。
文字的擴散
看完圖像的擴散之後,該如何轉換到文字上呢?對像素逐一加雜訊比較容易,因為像素是連續值:你可以讓紅色像素變得少紅一點、藍一點。但要怎麼讓詞元「The」變得少「The」一點?對單一詞元來說,什麼算「雜訊」?
遮罩擴散
不要把焦點放在單一詞元上,讓我們從整體來看。在遮罩語言建模中(像是訓練 BERT 這類編碼器模型時的做法),輸入中隨機的詞元會被替換成 [MASK] 詞元。我們可以把這個 [MASK] 詞元視為「雜訊」(也叫做受損詞元)。
流程就變得和圖像擴散類似了:取一段文字、選一個雜訊量,然後依照雜訊量隨機遮罩詞元。

重複這樣做多次,就能建立訓練資料集。你取樣同一段文字(或不同的文字),加上不同量的雜訊。這讓模型學會對不同量的雜訊去噪,就像圖像擴散一樣。

這個前向擴散過程之後接著反向擴散:模型要預測 [MASK] 位置上的正確詞元。每一步,模型只對那些它有信心找到好替代方案的詞元去噪。

在單一步去噪中,模型預測畫布每個位置上最可能的詞元。然後,只有超過某個閾值的詞元會被選用。沒達到閾值的,繼續維持遮罩詞元。

這個過程會持續到所有遮罩詞元都被替換,或達到一定的步數為止。一般來說,步數越多,最終序列越準確。它不用一次決定所有詞元,而是可以用多個步驟來決定哪些詞元該放在哪裡。
就像圖像擴散一樣,我們可以用一張圖同時視覺化前向與反向的遮罩擴散過程:

很像圖像擴散,文字的擴散一般也由兩個模型(或兩種技術)搭配使用:
- 去噪器 – 用來迭代地從有雜訊的輸入去除雜訊的模型(詳見「DiffusionGemma 的架構」一節)
- 編碼器 – 用來處理輸入查詢的模型(例如編碼器語言模型)。

不過遮罩擴散有一個問題,那就是自我修正!一旦模型決定替換一個 [MASK] 詞元,就定案了。選定之後就不能再換。這阻礙了模型修正那些可能太早選定的詞元的潛力。實際上這跟自迴歸模型的行為很像:自迴歸模型同樣選定詞元後就「卡死」在那個選擇上了。

那麼,如果我們改用另一種「雜訊」來探索,會怎麼樣呢?
均勻狀態擴散
使用 [MASK] 詞元是相當「嚴格」的雜訊定義方式:非有即無,中間沒有模糊地帶。跟圖像擴散相比,這是看待文字的「布林」方式。而且,當某個詞元被選來替換 [MASK] 詞元後,就不能再被替換。
我們不必用同一種東西([MASK] 詞元)破壞詞元序列,而是可以把每個詞元替換成不同的東西(隨機詞元)。在前向擴散過程中,隨機詞元會被用作雜訊來建立資料集,做法和遮罩擴散一樣。

這個過程建立了含雜訊的資料集,但沒有明確標示雜訊在哪裡(除了有正確答案作為對照)。這和遮罩最大的不同在於,模型必須自己判斷雜訊從哪裡來,並據此調整。不管是 10% 的詞被替換還是 90%,都需要對輸入有透徹的理解。
在去噪過程(反向擴散)中,模型必須偵測哪些詞元是雜訊、哪些該更新。在每個去噪步驟,模型會為畫布中的每個位置預測一個詞元。如果某個詞元不該動,它會維持高機率。但如果它決定替換那個詞元,就會改生成另一個機率高的詞元。模型會持續為每個位置預測最佳的詞元。這也表示,某個詞元在第 1 到第 10 步機率很高,到了第 11 步可能突然因為畫布更新而機率變低。
因此,在畫布的每個位置,模型會建議一個帶有特定機率的詞元。如果達到某個閾值,它就會被放到那個位置。但如果沒達到閾值,原來在那裡的詞元會被再加噪,用隨機詞元替換。

那為什麼要對低機率詞元再加噪?
如果保留舊詞元,那它就不是一個均勻隨機的詞元了。模型在訓練中學到的是,畫布由部分受噪的詞元組成,且它們是按照均勻分布抽取的。保留舊詞元的話,模型在下一步可能會圍繞著錯誤的詞元做規劃。為了貼近訓練資料,也出於實務考量,我們會對低機率詞元再加噪。
前向擴散(生成有雜訊的文字序列)與反向擴散(對隨機詞元去噪)合在一起,就構成了這個把詞元序列「破壞再修復」的過程。

結果是,模型在把隨機詞元換成另一個詞元後並不會停下來。它仍然可以改變畫布中的任何詞元。跟遮罩擴散相比,這讓模型能在走過各個步驟時持續更新、修改畫布。

均勻狀態擴散,一般來說文字擴散,跟自迴歸模型相當不同。自迴歸是一個詞元一個詞元循序預測,擴散則是迭代地更新畫布。把兩者並排比較時,這個差異尤其明顯。

這些差異很重要,因為它們能幫你理解什麼時候該選文字擴散模型、什麼時候該選自迴歸模型,反之亦然。雖然文字擴散模型擅長為單一使用者生成大量詞元,但它們的多使用者吞吐量比自迴歸對手低。文字擴散沒有免費的午餐。以下是兩者一些基本差異的總覽:

值得注意的一個文字擴散缺點(均勻狀態擴散尤其如此)是它們很難訓練。原因是訓練目標不只要對各種雜訊程度的畫布去噪,還要先辨識出哪些詞元真的是雜訊。否則,它會把畫布裡所有詞元都當成雜訊,那就不理想了。
那要怎麼兼得均勻狀態擴散的好處,又避開訓練的缺點呢?讓我們在 DiffusionGemma 的編碼器-解碼器補丁中探索解法吧!
DiffusionGemma 的架構
DiffusionGemma 採用了我們到目前為止探索的均勻狀態擴散。但從零開始訓練的缺點依然存在。解法很簡單:不要從零訓練,改用現成的檢查點當起點,也就是 Gemma 4 26B A4B 模型。
Gemma 4 26B A4B,如同 Gemma 4 視覺導覽 所介紹的,是一個混合專家(Mixture of Experts,MoE)模型,經過了大量訓練,效能優異。不過有一個問題……
Gemma 4 26B A4B 是純解碼器模型,設計用來一個接一個生成文字,而擴散一般需要一個編碼器和一個去噪器。這時一個優雅的解法登場了:編碼器-去噪器補丁!
這個補丁是一種把單一純解碼器模型轉換成以下兩者的方法:
- 編碼器 – 用來「理解」查詢
- 去噪器 – 用來對畫布去噪
它的做法是讓單一模型(Gemma 4 26B A4B)動態地在去噪器模式與編碼器模式之間切換。
去噪器模式 - 表現得像編碼器
要把純解碼器模型(Gemma 4 26B A4B)轉換成去噪器,我們可以利用它在生成詞元時沒有直接用到的東西,也就是所有詞元的 logits!
具體來說,自迴歸 LLM 首先把文字轉成詞元嵌入(一組一維數值)。當這些詞元嵌入流經 LLM 時,會被持續處理和更新,這通常稱為模型的隱藏狀態。最終的隱藏狀態會投影到 logits,代表詞彙表中每個詞的信心分數。這表示輸入中的每個詞元都會產生一組信心分數。但只有最後一個隱藏狀態的 logits 被用來選擇預測的詞元,其他的 logits 基本上都被丟掉了!

「丟掉 logits」不一定是壞事,因為最後一個詞元的 logits 包含了前面所有詞元的資訊。之所以只用最後一個,是因為序列中的每個詞元只能關注(attend to、「看見」)它之前的詞元。所以最後一個詞元的隱藏狀態是整個序列的彙總,這正是預測下一個詞所需要的。

這帶來了一個有趣的想法:如果我們替換兩樣東西,會怎麼樣:
- 用畫布替換輸入的詞元序列
- 用雙向注意力替換因果注意力
既然模型要當去噪器,我們預期輸入的詞元是充滿雜訊的畫布。但有了因果注意力,每個位置的 logits 仍然只能關注它之前的資訊。既然我們要一次生成整個詞元序列,就不會希望某個詞元看不到它之後的詞元,不管那些詞元有沒有雜訊。我們必須把因果注意力換成雙向注意力,讓詞元可以關注序列中的所有其他詞元,不管相對位置。

有了雙向注意力,所有詞元彼此關注,我們就能用輸入的有雜訊畫布中所有詞元的 logits。對有雜訊畫布中的每個位置,選擇最匹配的詞元。如果該詞元機率高,就接受;如果機率還是很低,就再加噪、換成另一個隨機詞元。
替換注意力機制不會開箱即用。Gemma 4 26B A4B 是用因果注意力訓練的,如果突然可以用雙向注意力,它會不知所措。這是必須訓練的部分,稍後會詳談。
輸入有雜訊的畫布、加上雙向注意力,我們就能把 Gemma 4 26B A4B 當去噪器,迭代地更新畫布。但沒有輸入查詢,模型就不知道該怎麼填畫布。這就是編碼器的用武之地。
編碼器模式 - 表現得像解碼器
Gemma 4 26B A4B 的編碼器模式跟圖像擴散中的編碼器一樣,目的是處理輸入查詢,為去噪器提供上下文與指引。一般來說,你會用編碼器(雙向注意力的 LLM)來處理輸入。但 Gemma 4 26B A4B 是用因果注意力訓練的,再替換一次注意力成本相當高。我們可以改用原生的 Gemma 4 26B A4B 來做查詢處理。這個 Gemma 4 26B A4B 模型並非原樣使用,而是經過微調來支援去噪與編碼的不同任務。
在這個過程中,我們不用 LM Head,因為我們不是在生成詞元,而是生成詞元表示。這些表示一般有兩種來源:隱藏狀態或 KV 快取。
但使用隱藏狀態需要額外的交叉注意力,那又是另一個補丁。因為編碼器模式與解碼器模式共用完全相同的模型,只是注意力機制不同,DiffusionGemma 改為在編碼器模式與解碼器模式之間共用 KV 快取。

另一個原因是,即使編碼器是因果注意力的解碼器模型,它還是能對輸入查詢產生很好的表示。因此,這些 KV 快取表示會分享給去噪器(雙向注意力的 Gemma 4 26B A4B),讓它理解使用者真正想生成什麼。在去噪器的去噪步驟中,KV 快取不會更新。
DiffusionGemma 的推論
擴散模型很重要的一部分是它們如何處理推論。具體來說,畫布不是一步生成,而是迭代更新。這帶出了幾個我們還沒回答的問題:
- 模型怎麼知道上一步做了什麼預測?
- 要怎麼生成比畫布更大的序列?
- 去噪器用幾個去噪步驟?
自我條件化
我們先回答第一個問題:「模型怎麼知道上一步做了什麼預測?」。
答案幸好相當直白。去噪器跑完一步後,可以把生成的機率傳給第二步。這讓模型知道上一步想做什麼、是從哪裡來的資訊。
實務上,它的做法是把 softmax 之後的機率乘上所有詞元的嵌入,也叫做嵌入矩陣或嵌入表。這個乘法在畫布的每個位置產生一個嵌入,代表這個機率分布。如此一來,機率越高的詞元,其嵌入的權重就越大。接著它們會通過一個小的前饋神經網路(FFNN),再加到下一步的詞元嵌入上。
這實質上給了它一個記憶,記得上一步試圖做什麼,以及在預測某些位置時有多自信。
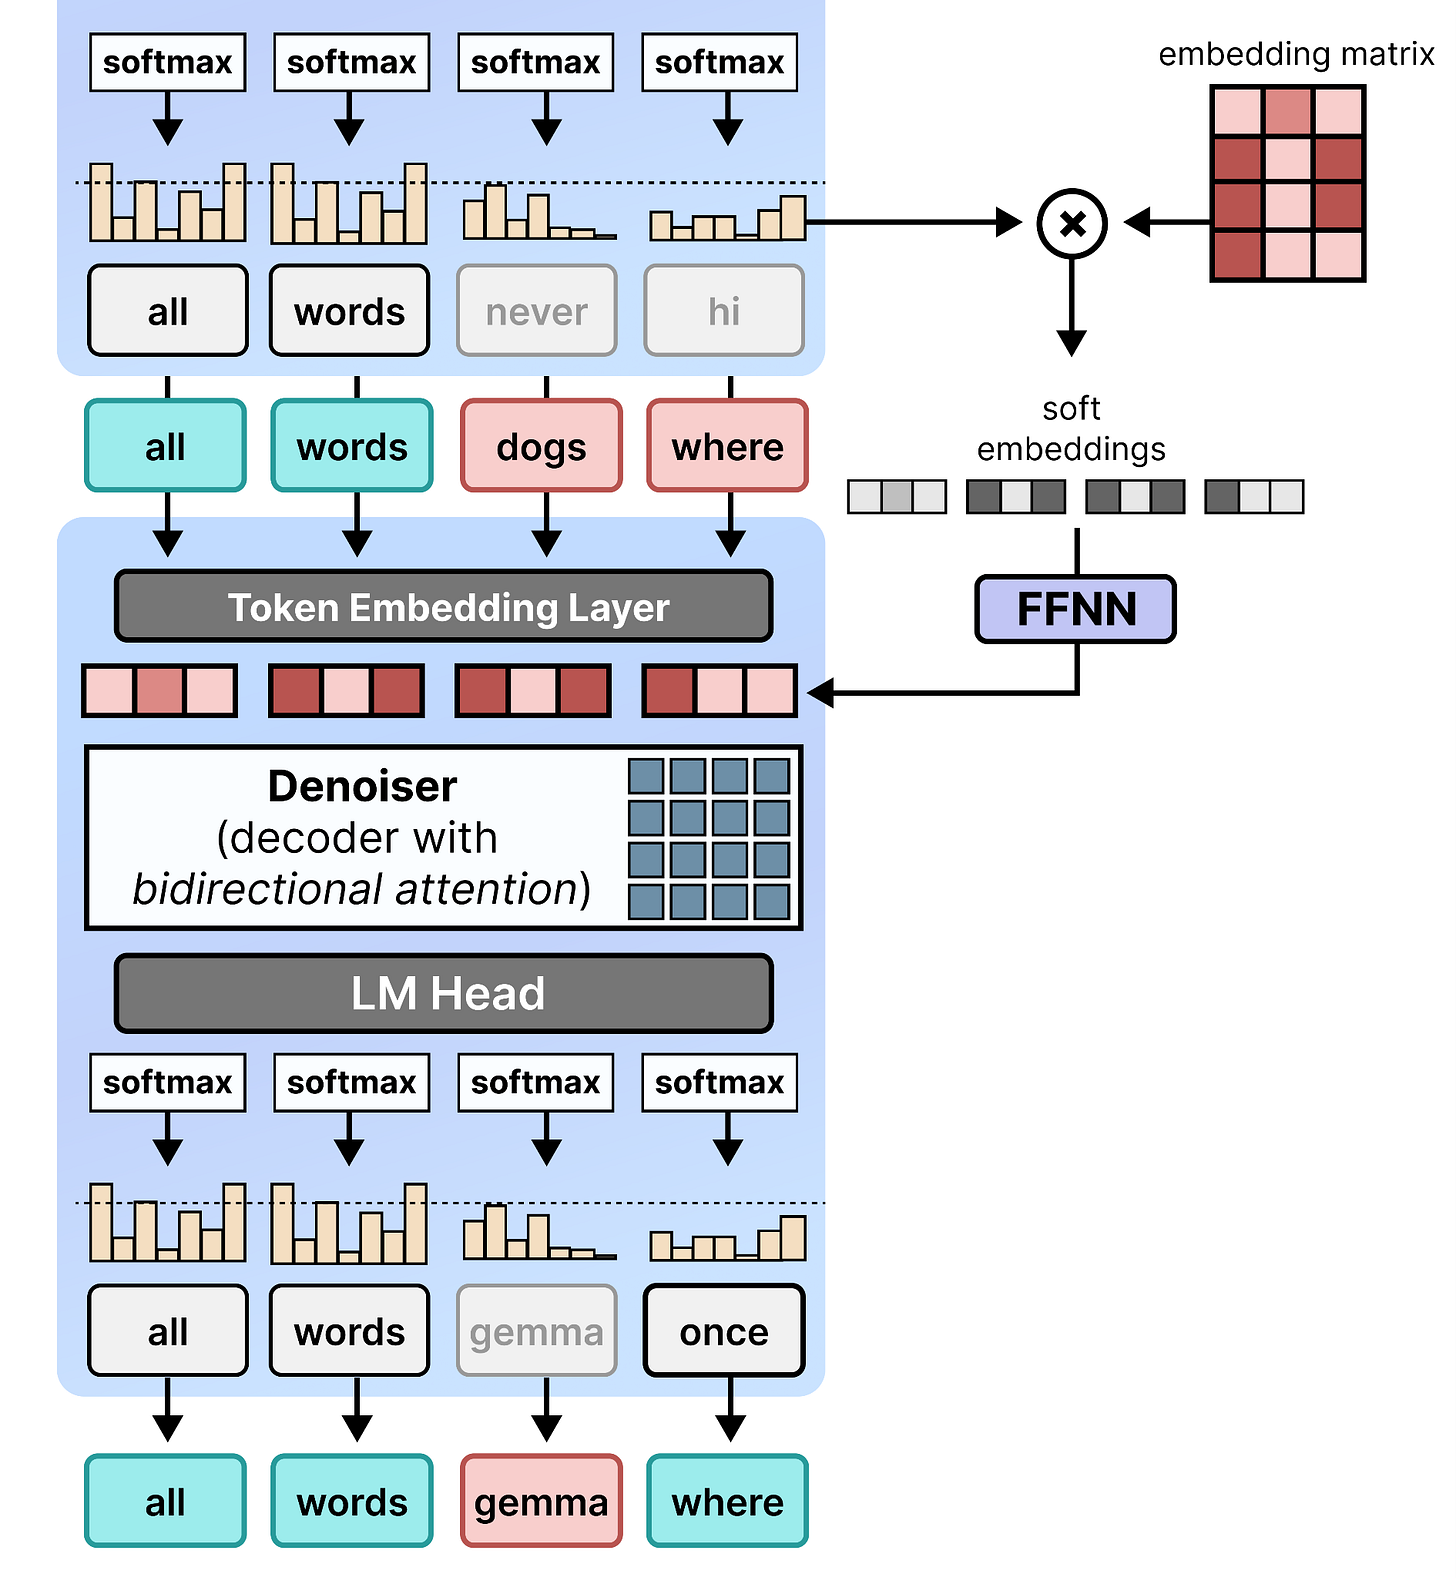
把一切組合起來,第二步跟第一步完全一樣,還會重用編碼器的 KV 快取。這種對上一步的自我條件化,可以看成一個 skip-step:把資訊傳到下一步,讓它帶著更多上下文繼續。
現在我們有了 DiffusionGemma 的完整架構總覽:

多畫布採樣(區塊擴散)
我們需要回答的第二個問題是:「要怎麼生成比畫布更大的序列?」。
DiffusionGemma 的畫布大小是 256 個詞元,其實不算大!幸好,我們可以把擴散和自迴歸混搭,擴大生成的詞元數量。
具體來說,我們先用目前為止探索的 DiffusionGemma 生成 256 個詞元。這 256 個詞元只需要通過編碼器一次來生成 KV 快取,之後去噪器走多個步驟把這個畫布填滿。填完後,提示會更新、加上新的 256 個詞元,並加入編碼器的輸入序列來擴展 KV 快取。然後去噪器繼續產生下一個 256 個詞元序列。這個過程持續到去噪器生成停止詞元為止。
因此,畫布用擴散生成,但彼此是循序拼接起來的。這表示我們在交替使用擴散與自迴歸!

回顧一下我們用來比較擴散與自迴歸的圖,現在它們被結合成一個流程:每個擴散的輸出用自迴歸的方式拼接在一起:

讓這成為可能的關鍵之一,是編碼器的 KV 快取用因果注意力計算。因為每個詞元只關注它之前的內容,所以只需要在每個「自迴歸步驟」加入的畫布上計算 KV 快取。這是相對便宜的操作,因為我們可以持續更新 KV 快取,不用重新計算。
讓這成為可能的另一個關鍵,是編碼器的 KV 快取只需要在每個「自迴歸步驟」開始時計算。在「擴散步驟」期間,KV 快取被重用、不用重算,因為在擴散結束前不會加入新詞元。
排程器
圖像擴散中的排程器控制每個去噪步驟去除多少雜訊,以及總共走幾步。在 DiffusionGemma 中,排程器是一組技術的集合,共同決定去噪的逐步過程如何運作。它「排定」去噪過程,不直接決定接受或拒絕哪些詞元。跟圖像擴散不同,DiffusionGemma 的排程器由三個獨立組件協作組成。
第一,步數。它決定去噪的最大步數。步數越多,一般輸出品質越高,但生成速度越慢。

第二,logits 排程器。模型產生原始 logits 後,會經由 softmax 轉成機率。從這些機率中,不再每次都選最可能的詞元,而是根據多項分布選詞元。這表示機率高的詞元被選中的機率更高,反之亦然。

但生成的 logits 有一個問題:它們往往比較不確定。原因是,在去噪過程的每一步,畫布裡都有雜訊詞元,會傷害每個位置的可預測性(也因此影響 logits)。
logits 排程器確保模型的預測(logits)更果斷。它的做法是把 logits 除以一個溫度值,這個值跟自迴歸 LLM 裡的溫度是一樣的。

請注意步數是倒數的,確保每個去噪步驟的溫度更低:

在每一步把 logits 除以溫度,有助於讓 logits 分布更分明、更「尖銳」。因為早期的畫布大多是雜訊,這時銳化預測沒什麼意義。只有在後期步驟,畫布比較乾淨時,我們才銳化預測。

這表示在早期步驟,模型會多探索一點,不只聚焦在最可能的詞元上。而在後期步驟,模型探索得少,更聚焦在最可能的詞元上。它在探索(早期步驟)與利用(後期步驟)之間取得平衡。

因此,跟後期步驟相比,我們可以把早期步驟看成在詞元分布上比較「雜訊」的階段。
第三,適應性停止。雖然步數已經定義了去噪過程的最大步數,但模型可能提早收斂。為此有適應性停止機制。在每一步,它會檢查:
- 穩定性 – 機率最高的詞元預測在過去 N 步中是否完全相同?
- 信心度 – 模型在畫布所有詞元上的信心度如何?
在 DiffusionGemma 的配置中,信心度閾值是 0.005,穩定性閾值是 1。信心度透過模型預測的分散程度來衡量,也就是熵。在畫布的某個位置,如果某個詞元的機率很高(例如「LLM」有 95%),就表示很有信心,熵很低。這表示如果模型在大多數詞元位置上都很有信心,而且預測的詞元跟上一步相同,那麼不管還剩多少步,模型都會停止生成。
熵界限採樣器
在圖像擴散中,採樣器控制如何把模型的預測和目前有雜訊的圖像結合,產生下一張雜訊少一點的圖像。在 DiffusionGemma 中,它控制去噪過程中的雜訊量。每個採樣器由三個組件構成:
- 畫布初始化 – 有雜訊的畫布如何建立。
- 詞元接受 – 哪些預測的詞元要保留、哪些要拒絕
- 詞元再加噪 – 被拒絕的詞元如何再加噪
預設使用的採樣器是熵界限採樣器。
畫布初始化
畫布用隨機詞元(均勻抽取)建立,本質上跟從圖像擴散的純雜訊開始是一樣的。
詞元接受
熵界限採樣器根據模型對每個詞元的信心度,決定保留哪些詞元。為了衡量信心度,它用熵來定義機率分布的分散程度。記得嗎,對畫布中的每個位置,模型會產生一個機率分布。如果這個分布大幅偏向單一詞元,表示很有信心,熵就很低。但如果分布平均分散(它不知道該選哪個詞元),熵就很高。

採樣器計算畫布中每個位置的熵值,然後從熵最低(最有信心)到最高(最沒信心)排序。因此,這個詞元清單從模型最有信心的預測開始,採樣器會逐一檢查是否可以接受。

接受標準依據以下公式:

從模型最有信心的畫布位置開始,採樣器檢查到目前為止的熵總和(減去最大熵)是否超過你事先設定的上限。如果超過,表示模型信心不足,會被拒絕。如果沒超過,表示模型夠有信心,就繼續檢查下一個最有信心的畫布位置。

因此,採樣器只會接受一組詞元,當它們各自都夠有信心、且整體不超過上限時。這讓模型更專注於接受那些它相當確定正確的詞元,而不管其他詞元位置會怎麼樣。
詞元再加噪
熵界限採樣器的畫布再加噪很直白:所有被拒絕的詞元都會再加噪!但這不表示被接受的詞元會永遠留在原位。在接下來的去噪步驟中,模型可能在生成更新後的上下文後,給它一個較低的機率。
