多詞元預測視覺化指南
Note
原文為 Gemma 4 視覺化指南(發表於 Exploring Language Models)的一部分。 關於其餘架構,請見Gemma 4 視覺化指南。
為了提升 Gemma 4 模型的推論速度,一系列自迴歸「草稿(drafter)」模型隨主力陣容一同發布(E2B、E4B、31B 與 26B A4B)。草稿模型在目標模型處理一個詞元的時間內就能預測多個詞元,而非只依賴主要的 Gemma 4 模型(稱為「目標(target)」模型)。這項技術也稱為推測性解碼(speculative decoding)。
草稿模型預測出多個草稿詞元後,目標模型只需驗證這些建議的草稿詞元。驗證以並行方式進行,大幅加快推論速度。每個詞元需要的目標模型前向傳播次數也因此減少。由於草稿模型會為驗證產生一串詞元,我們稱之為多詞元預測(Multi-Token Prediction,MTP)輸出頭。
Gemma 4 系列發布的草稿模型很小,並引入多項增強來提升草稿詞元品質、進一步加快推論,例如利用目標模型的活化值與 KV 快取來獲得更好的預測。
這些增強帶來顯著的解碼加速,同時保證相近的品質,讓這些檢查點非常適合低延遲與裝置端應用。
這裡有很多值得拆解的內容,讓我們逐一看看推測性解碼、MTP 與草稿模型!
什麼是推測性解碼?
Gemma 4 模型以自迴歸方式生成文字,一次產生一個詞元。每個詞元所需的計算量大致相同,無論該詞元有多難預測。因此,當詞元很容易預測時,這會是一個不必要的慢速過程。
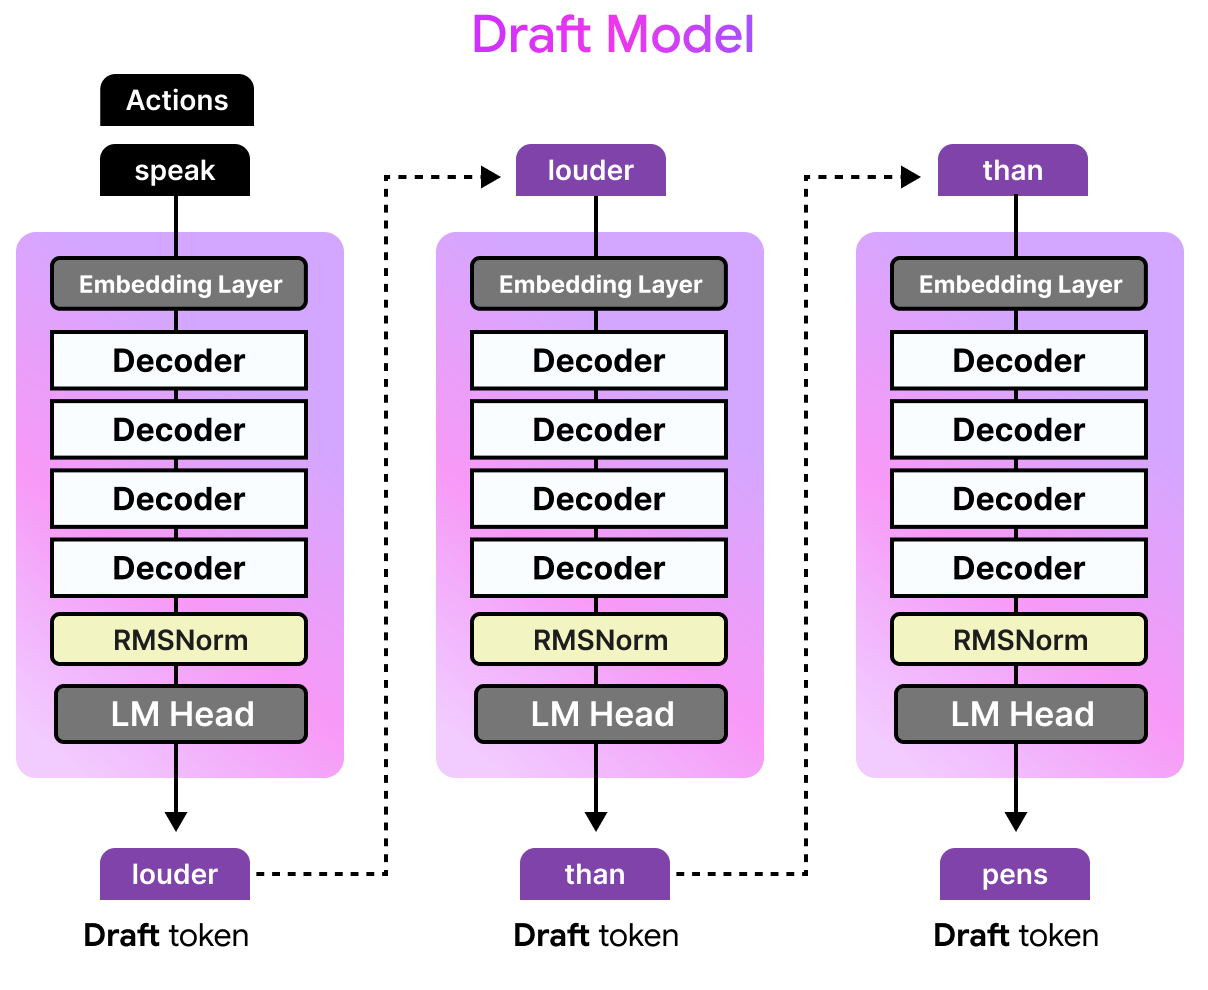
想像大型模型正在生成文字,已經產生了「Actions speak」。認出這句話開頭的人都知道,這是英文中的一句常見諺語,後面是「Actions speak *louder *than words.」。由於很常見,小型模型很可能會生成與大型模型完全相同的續寫(「louder than words」)。因此,讓大型模型逐詞元預測「louder than words」是浪費時間和算力。
有了推測性解碼,我們可以用較小的草稿模型提前預測多個詞元。草稿模型會收到同樣的輸入「Actions speak」,仍以自迴歸方式預測若干詞元,比如說四個詞元。由於草稿模型只有大型模型的一小部分,草稿詞元的生成速度遠快於大型模型。
什麼是多詞元預測?
然而,草稿詞元不一定正確,否則我們大可以直接用小模型。這些詞元會交給目標模型以並行方式驗證。由於目標模型一次前向傳播就能完成,不必為每個詞元都做一次前向傳播。草稿模型就是我們所說的多詞元預測(MTP)輸出頭。目標模型的每次前向傳播都會做一般的下一個詞元預測(NTP),並產生中間隱藏狀態。草稿模型(MTP 輸出頭)使用這些隱藏狀態,跑多次自迴歸前向傳播來生成多個詞元。因此,目標模型的單次前向傳播會產生多個詞元,而非一個:一個來自目標模型的下一個詞元預測,多個來自草稿模型(MTP 輸出頭)。
如果目標模型同意草稿模型的建議,所有詞元都會被接受。小模型只用了一小部分時間就生成了四個詞元;目標模型只需用它生成一個詞元的時間來驗證。而且,如果所有草稿詞元都被接受,目標模型還會自己再多生成一個詞元。
如果目標模型只不同意部分草稿詞元,它會接受到不同意為止。目標模型會用自己的一個詞元取代被拒絕的詞元。
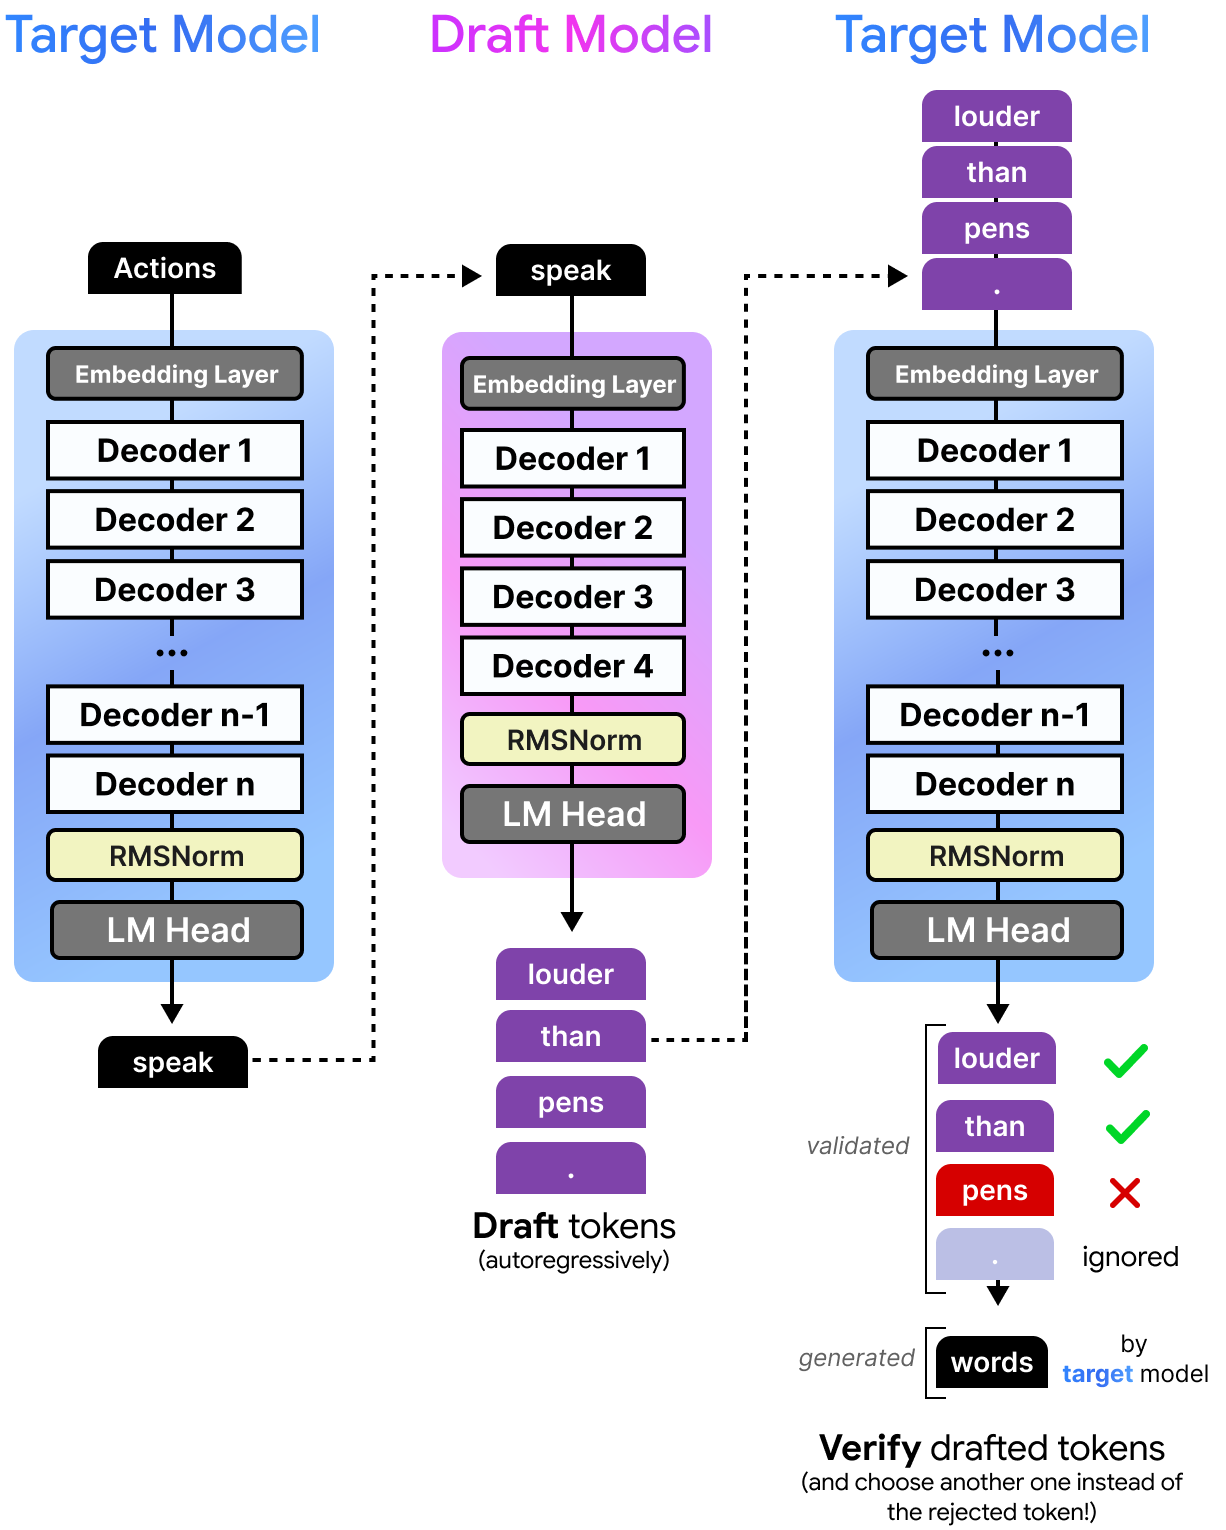
考慮到模型可以一次驗證所有草稿詞元的品質,而不必逐個驗證,這個過程其實相當快。由於草稿模型很小,預測單個詞元花的時間比目標模型少得多。這表示目標模型驗證多個詞元的時間,幾乎和生成單個詞元一樣!注意,草稿模型和大多數語言模型一樣是逐個順序生成這些詞元,但因為體積小而快得多。
目標模型認為夠好的所有詞元都會被選中。它拒絕的第一個詞元及其後的所有詞元都不會被收錄、會被捨棄。不過,由於目標模型已做過一次前向傳播,它仍能做一次下一個詞元預測。所以即使像「pens」這樣的詞元被拒絕,目標模型還是會給出被拒絕詞元的替代方案。
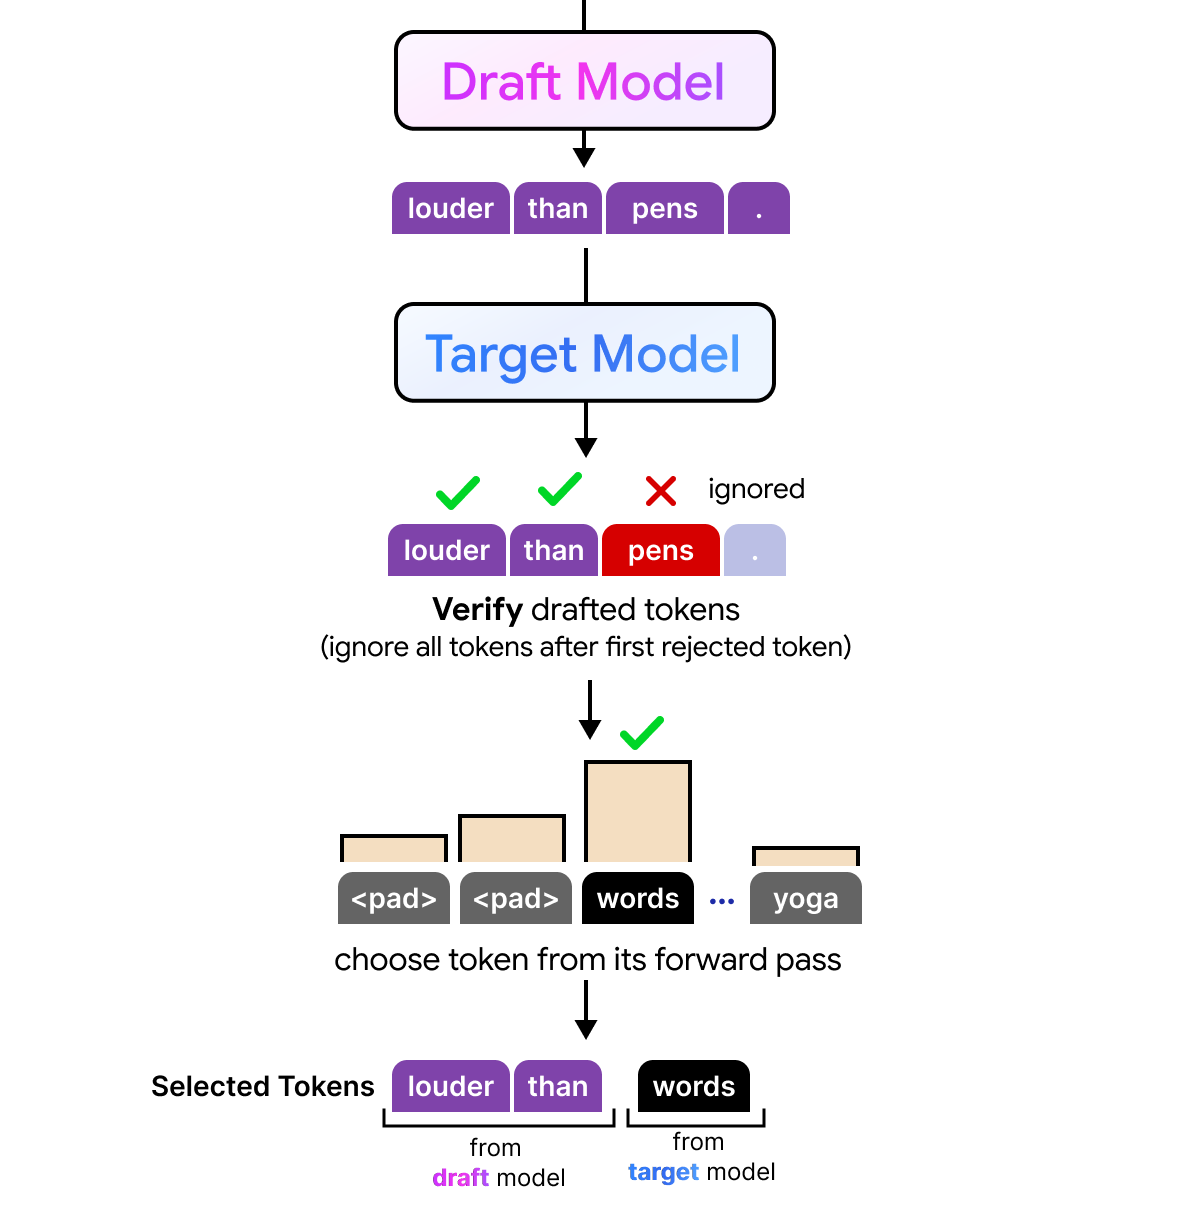
因此,目標模型可能選中任意數量的草稿詞元。整個過程用圖呈現很有意思:草稿模型以自迴歸方式處理、逐個序列生成詞元,目標模型則能以並行方式驗證所有草稿詞元。目標模型仍然是自迴歸的,但不必逐個生成這些草稿詞元,可以一次全部驗證。

Gemma 4 的 MTP
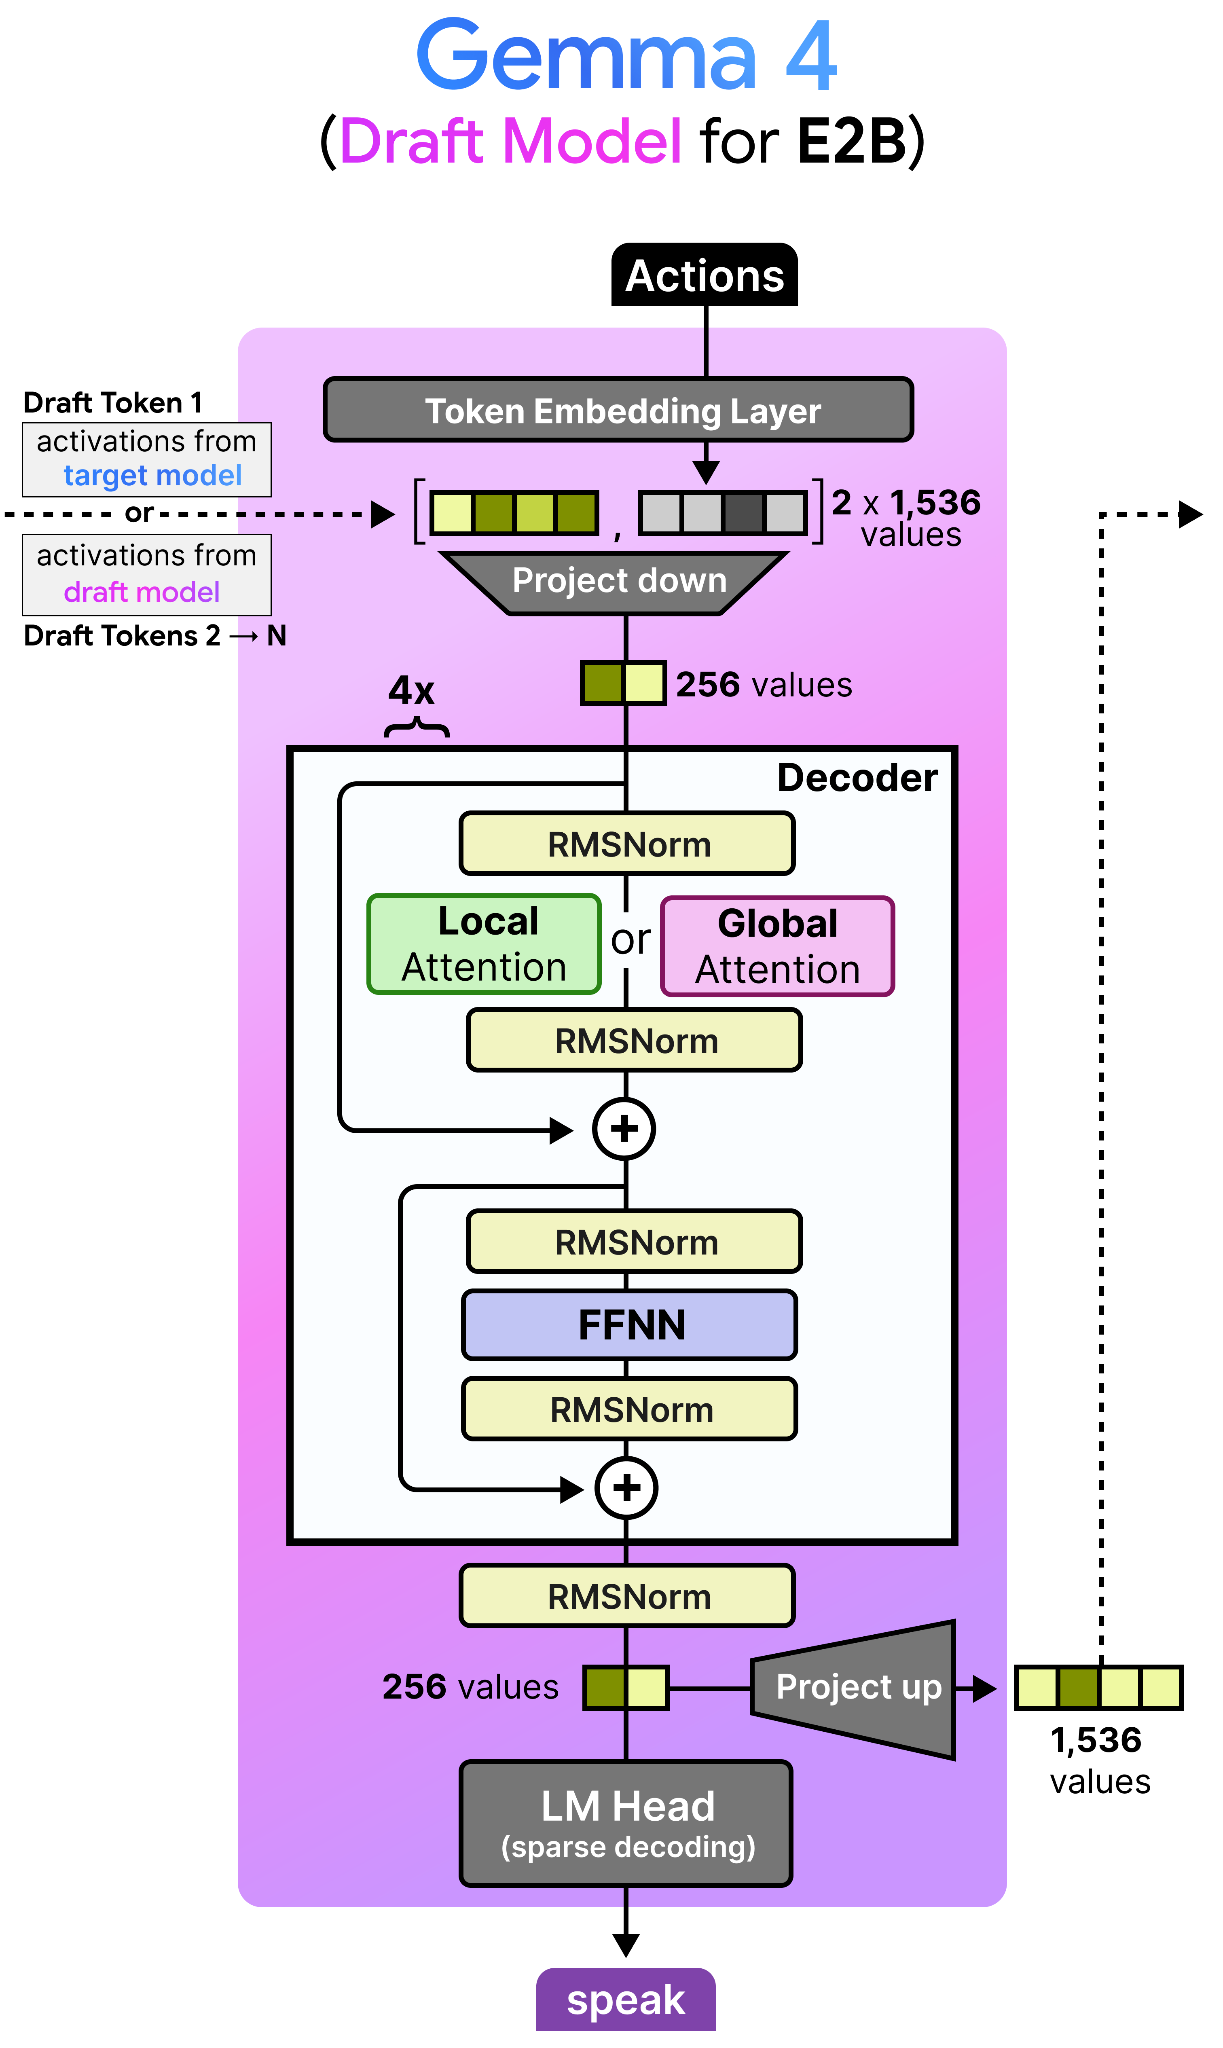
Gemma 4 系列發布的草稿模型與稠密 Gemma 4 模型最為相似,但小得多得多。事實上,Gemma 4 E2B 的草稿模型只有約 7600 萬參數、四層,輸入嵌入維度也較小(256,相較於 1536)。
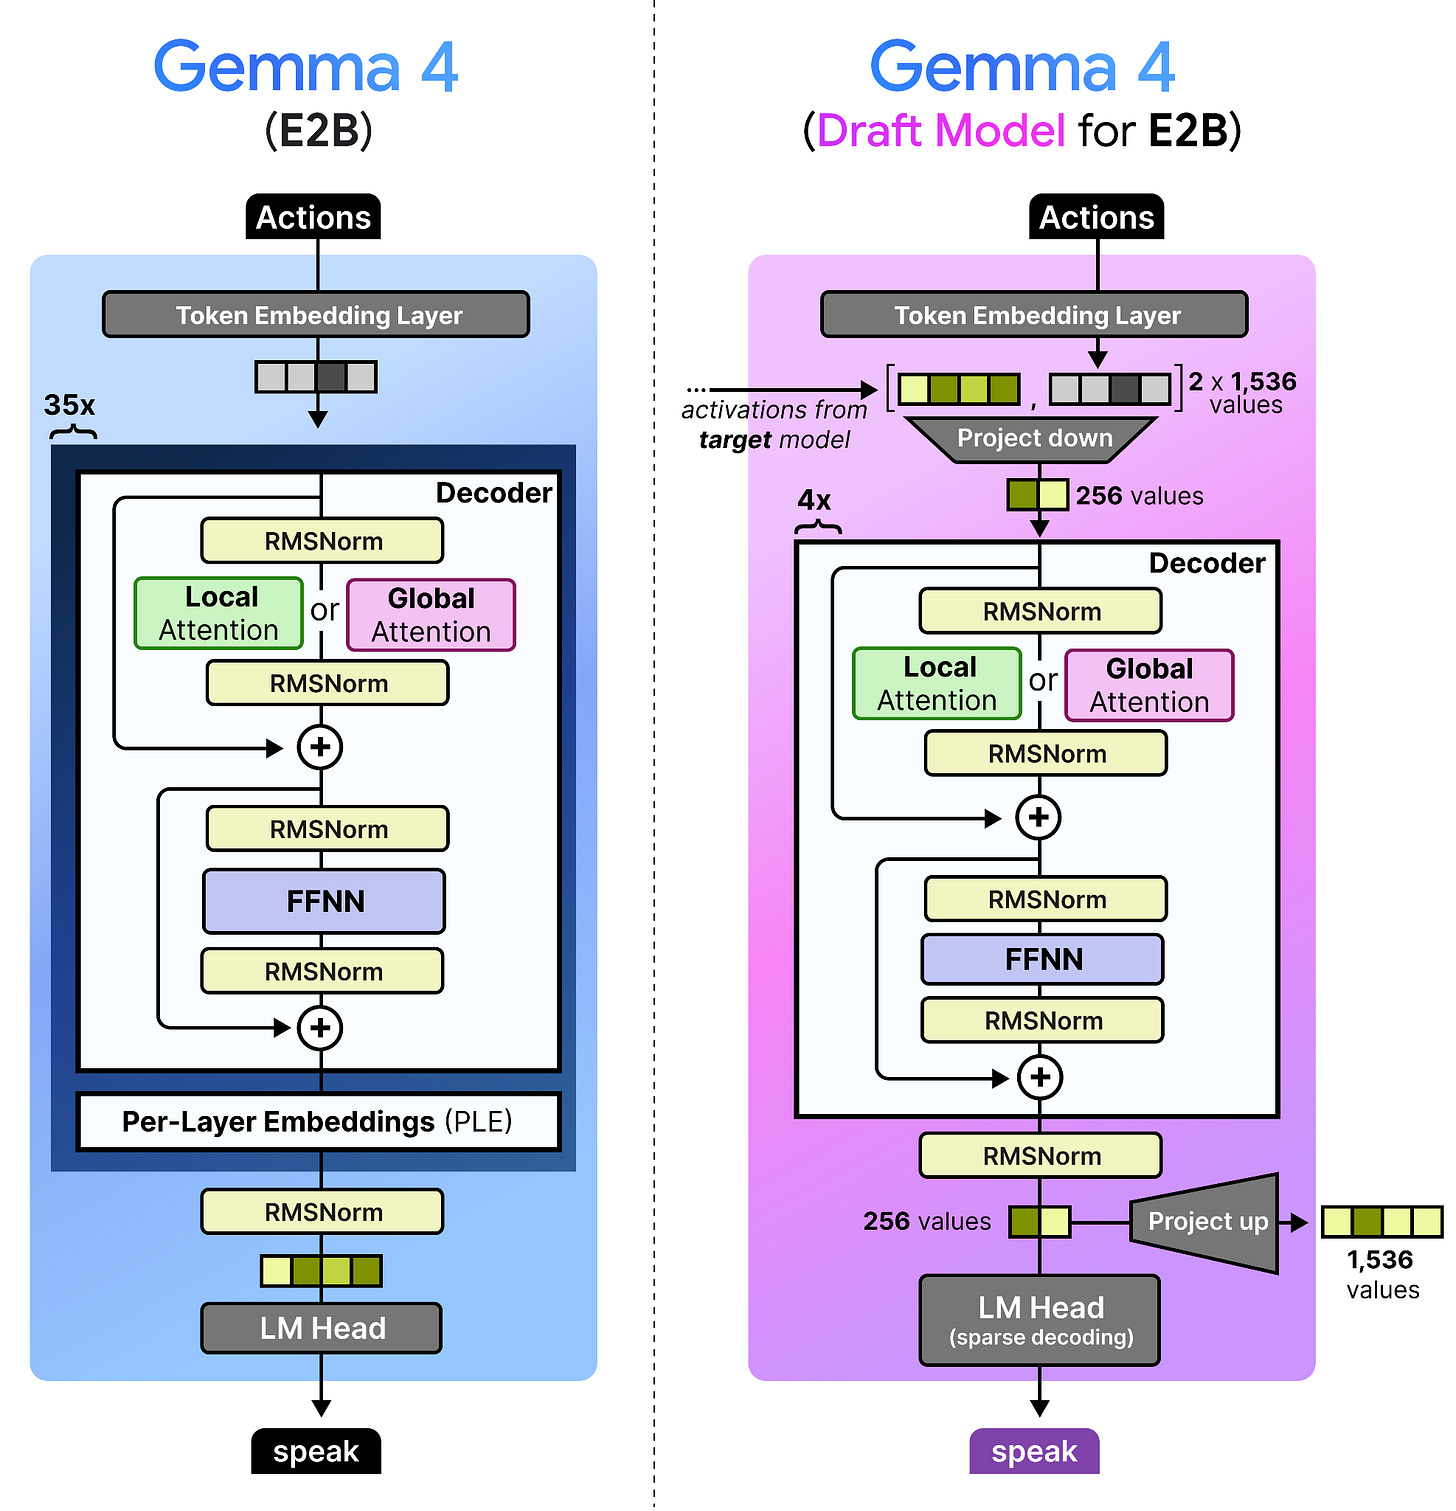
注意解碼器本身與稠密 Gemma 4 模型的解碼器相似。但解碼器前後還有很多事情發生!
草稿模型有各種增強,專門為了更有效率、進一步加快推論。同樣,也有許多有趣的技術用來提升草稿詞元的品質、降低草稿延遲。畢竟,我們希望草稿詞元盡可能準確、生成得盡可能快。
這些變更可以總結如下:
- 目標活化值(Target Activations):草稿模型使用目標模型最後一層的活化值,與詞元嵌入拼接,再下投影到草稿模型的維度。
- KV 快取共享(KV Cache Sharing):草稿模型對目標模型的 KV 快取做交叉注意力,而非自己建立。
- 高效嵌入器(Efficient Embedder):LM 輸出頭採用稀疏解碼技術,找出最可能包含預測詞元的群集(僅 E2B 與 E4B)。
讓我們逐一深入探討!
目標活化值
為了提升草稿模型生成詞元的品質,目標模型(例如 E2B)的最終活化值會餵給草稿模型。這些會與草稿模型的詞元嵌入拼接,假設是 E2B 模型,兩者都有 1,536 個值。拼接後的嵌入相當大,基於效率考量會投影到只剩 256 個值。這基本上是對大型目標模型處理後狀態與草稿模型新初始化嵌入的壓縮。既然前面的活化值都算出來了,何必浪費?
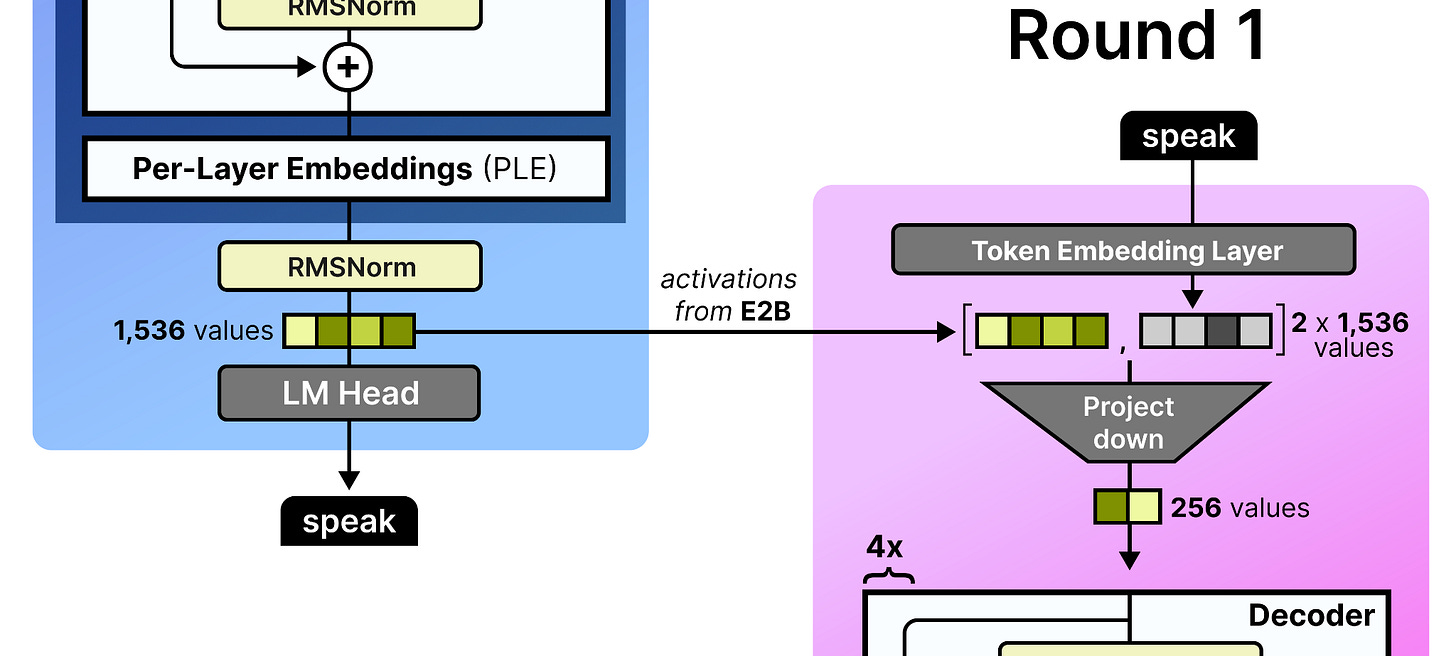
這些活化值只在第一輪處理時給草稿模型。別忘了,草稿模型在首輪之後,會把詞元回傳給自己、以自迴歸方式產生多個詞元。因此在第二輪,由於生成了新詞元,會使用草稿模型在第一輪生成的活化值。由於小型草稿模型的中間活化值只有 256 個值,會上投影以匹配其輸入嵌入表的維度(即 1,536 個值)。注意,為了進一步提升效率,輸入嵌入表在目標模型與草稿模型之間是共享的。
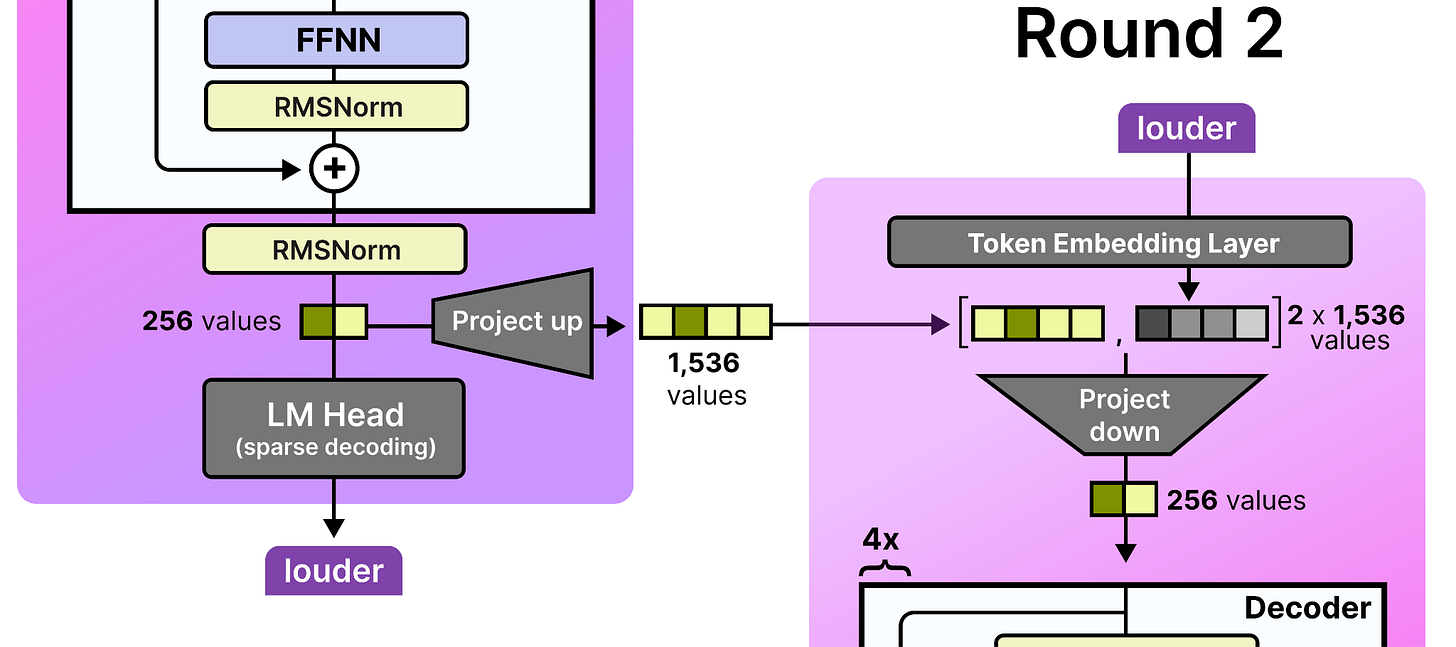
然後第三輪,草稿模型使用第二輪生成的活化值,依此類推!
KV 快取共享
KV 快取可能佔用不少空間,因為它包含序列中每個詞元、每一層的鍵與值表示。雖然 Gemma 4 已經採取許多措施來縮減(例如在全域注意力層中讓 K=V),草稿模型更進一步。
草稿模型不必處理完整提示、自己建立 KV 快取,而是對目標模型已算好的 KV 快取做交叉注意力。對於局部注意力層,草稿模型直接重用目標模型最後算出的局部 KV 快取。由於任何 Gemma 4 模型的最後一層都是全域層,該全域 KV 快取會重用於草稿模型的全域注意力層。
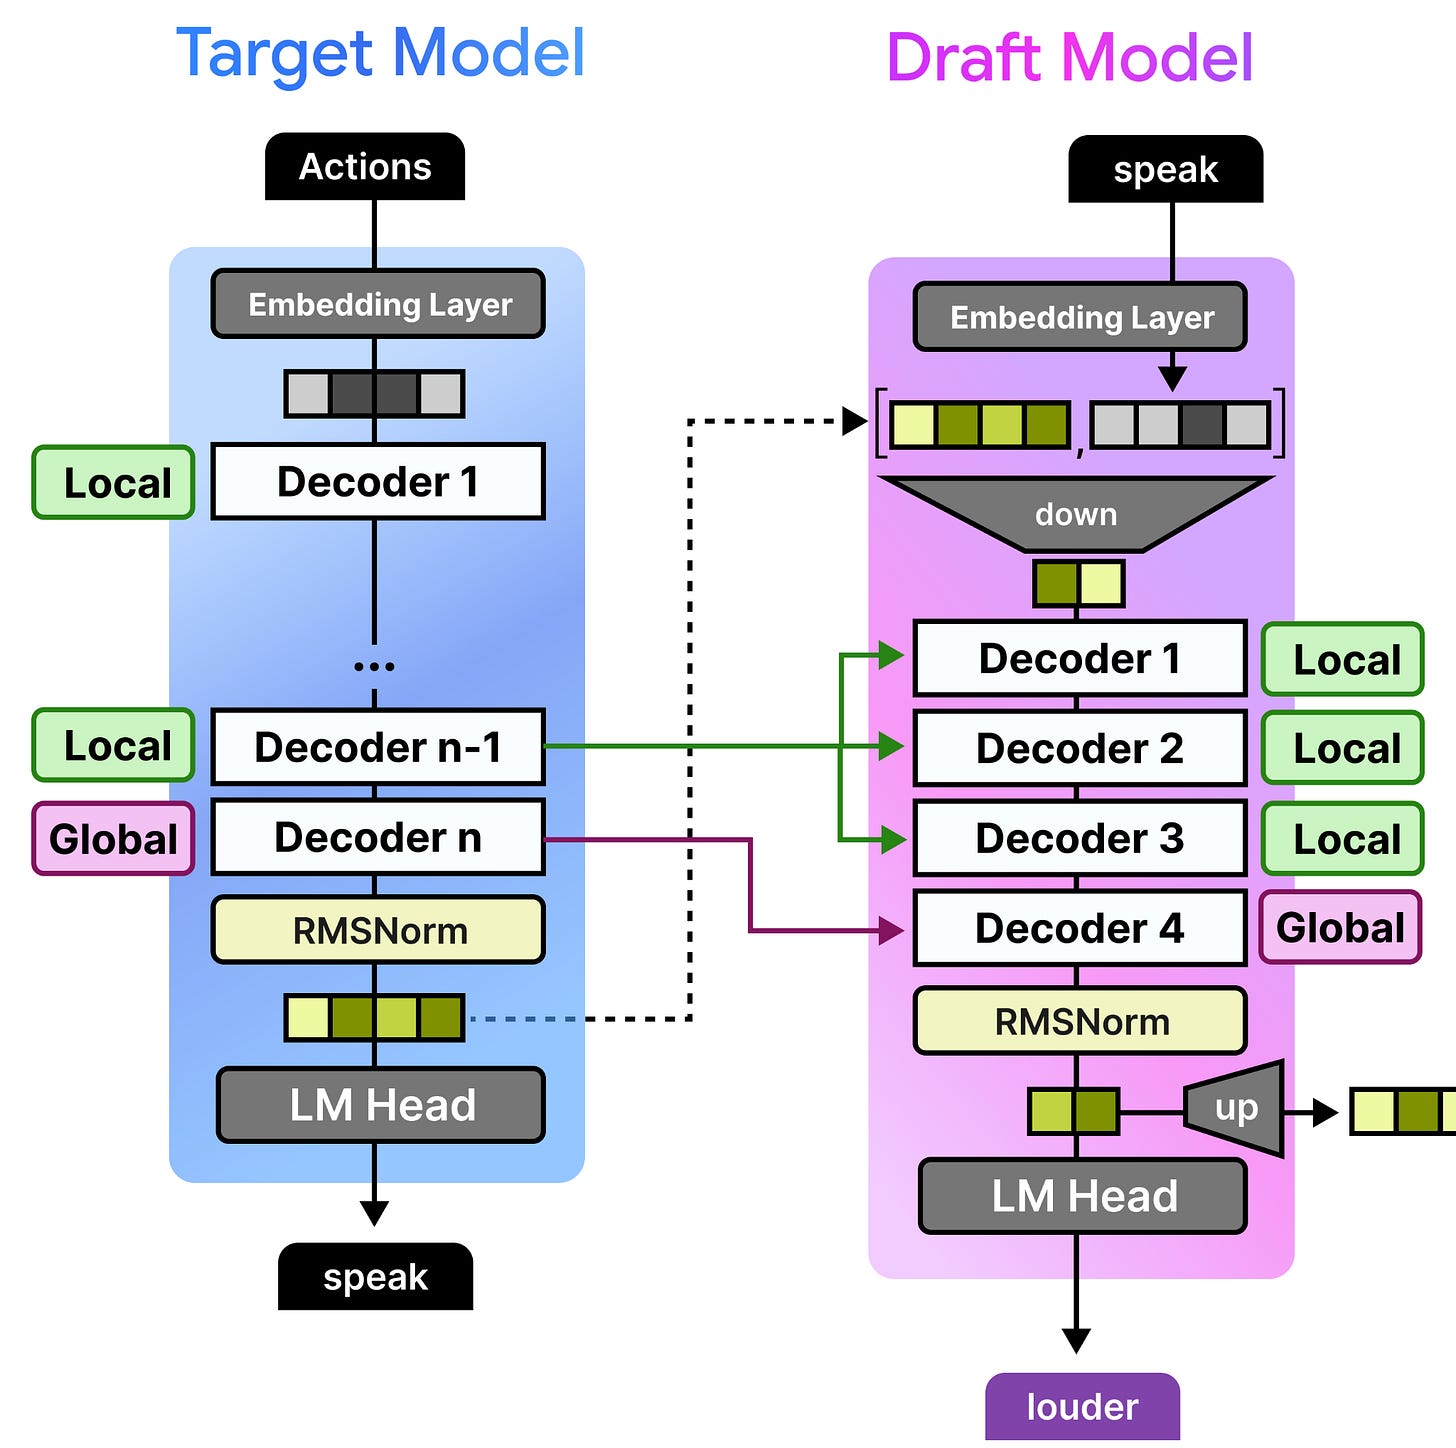
和之前一樣,既然目標模型已經做了大部分繁重的工作,丟掉就太浪費了!
高效嵌入器
最後,有一個高效嵌入器,能減少從語言模型輸出頭(LM Head)生成草稿詞元所需的計算。在傳統模型中,LM 輸出頭會把解碼器產生的隱藏狀態乘上一個大型權重矩陣(與嵌入層用的相同,也就是查詢表),轉換成對數機率(logits,詞元機率)。對這麼小的模型來說,這個過程可能相當昂貴!
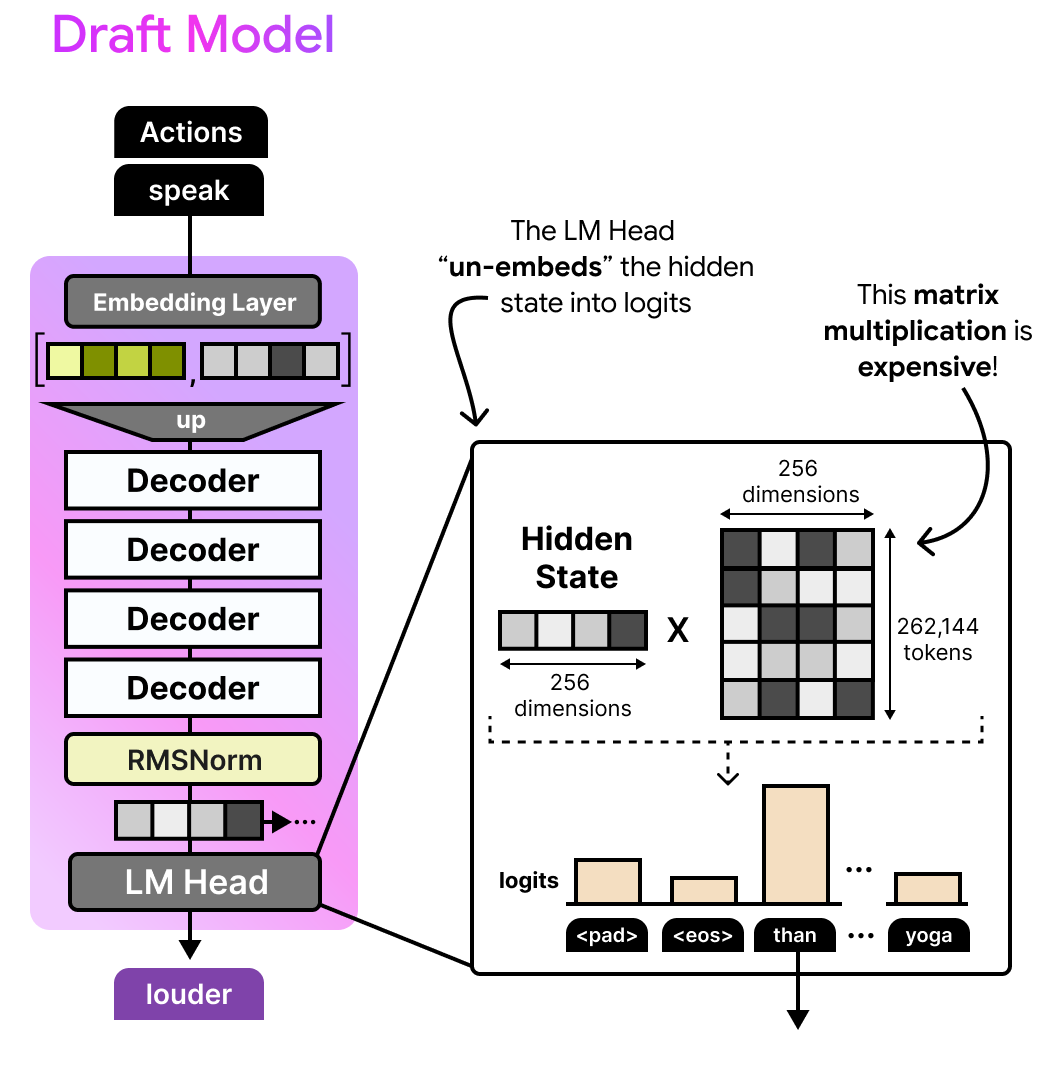
你可能會問自己:當大多數詞元都可能無關時,我們真的需要為全部 262,144 個詞元計算對數機率嗎?
在 Gemma 4 E2B 與 E4B 模型的草稿器中,這個過程透過一個經典技術——分群(clustering)——變得更有效率。所有詞元嵌入會先分別分群成語義相近的詞元大群集,然後為每個群集找出一個嵌入表示。
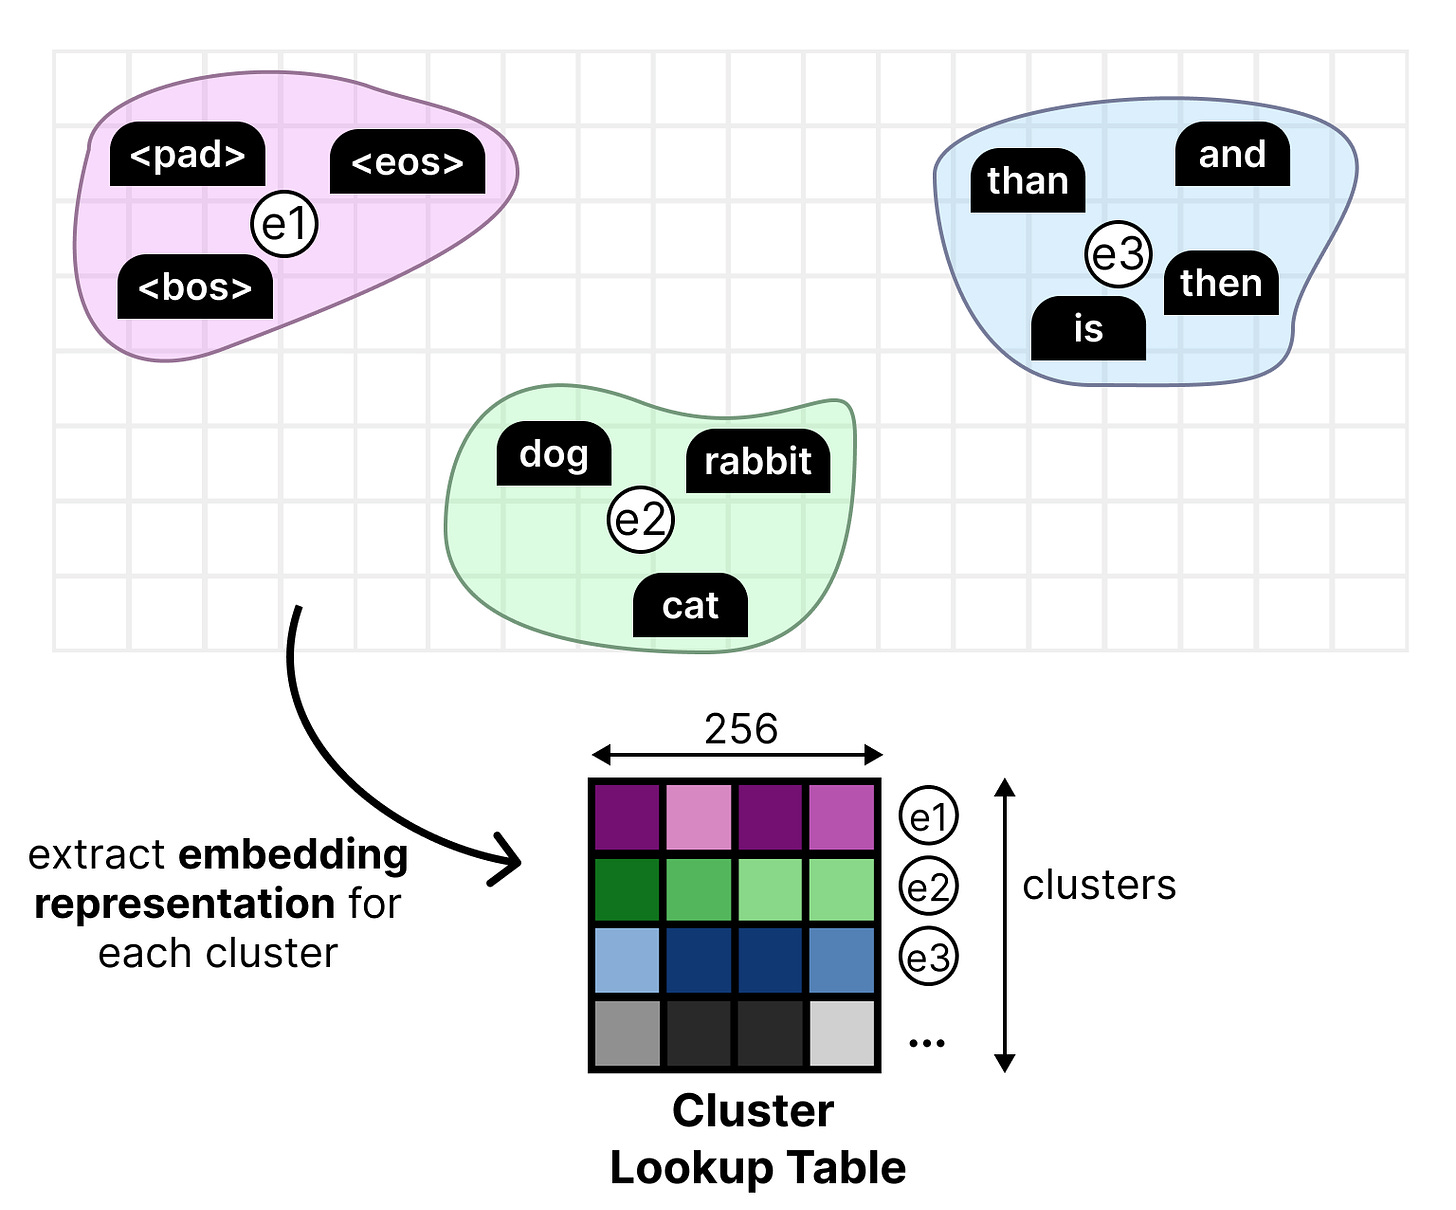
這個新的查詢表接著用於 LM 輸出頭,與隱藏狀態相乘。結果是群集對數機率,而非詞元對數機率。這表示群集對數機率告訴我們最可能包含下一個詞元的群集。選出最可能包含正確詞元的群集後,再用這些群集內的所有詞元計算最終的詞元對數機率。

這個計算簡單得多,而且告訴我們下一個詞元幾乎肯定在選出的群集中。這個高效嵌入器讓草稿模型更快!