Gemma 4 圖解指南
Note
原文發表於 Exploring Language Models。
我非常興奮地宣布 Gemma 4 系列模型問世!這正是我加入 Google DeepMind 的重要原因之一。研發頂尖的研究成果並將其分享給全世界,即使到了今天,這依然深植於他們研究團隊的文化之中。
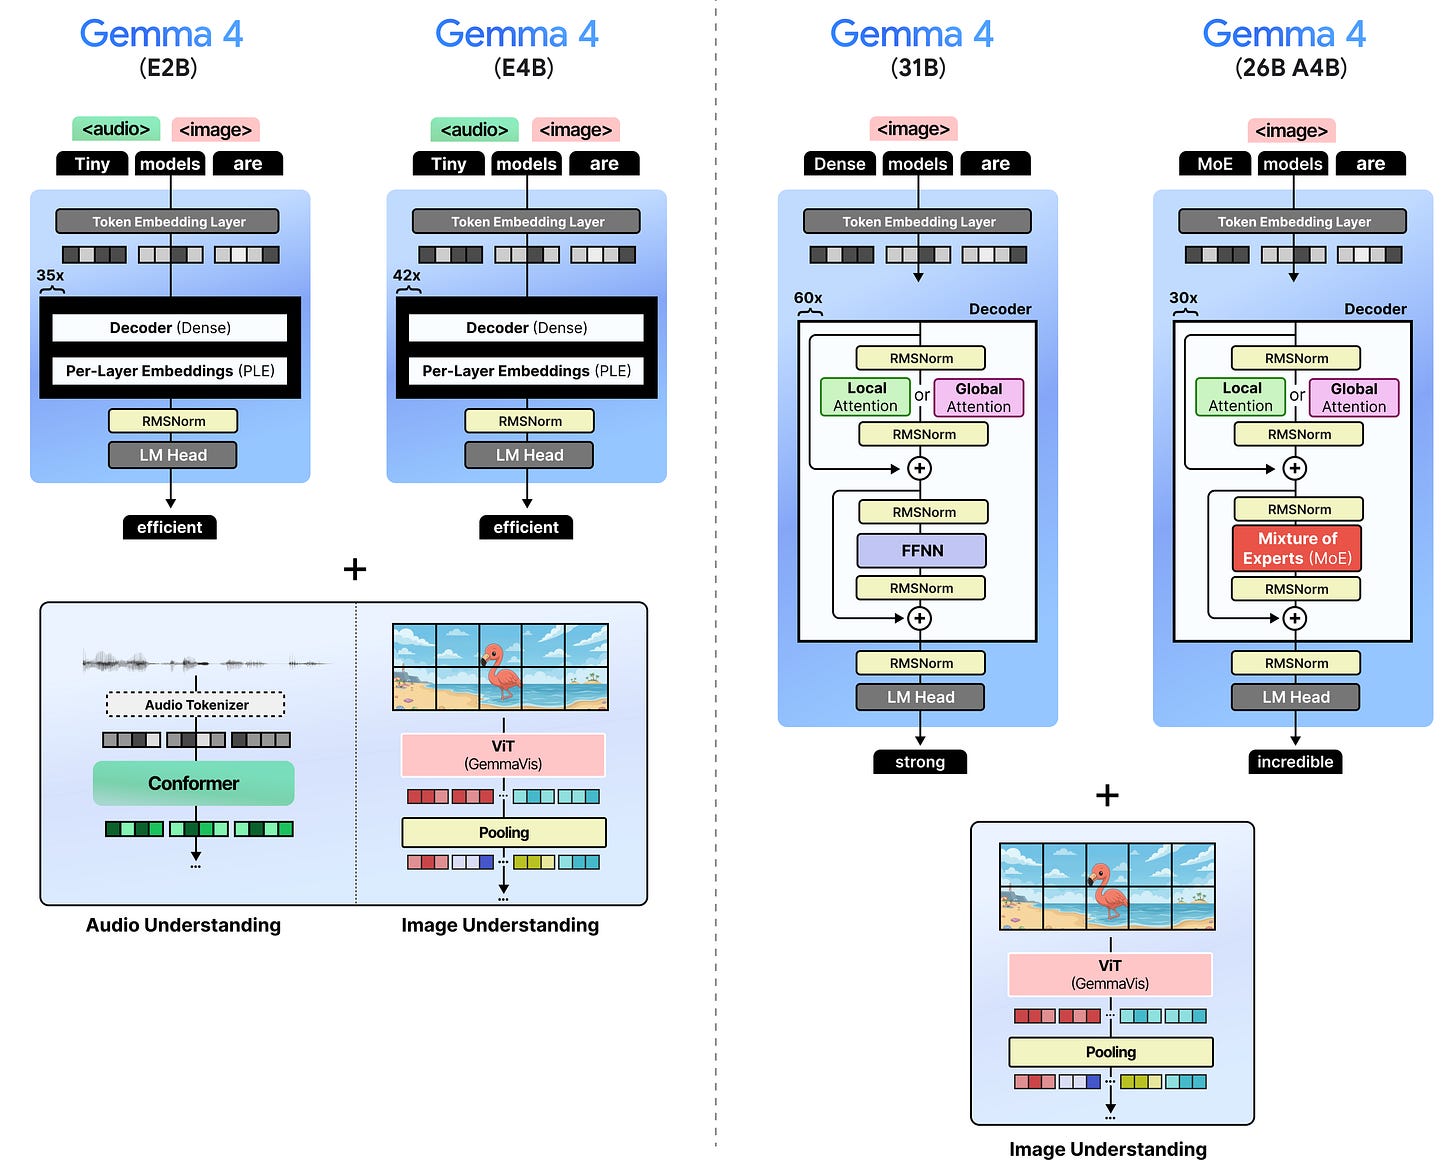
Gemma 4 系列共有四款模型:
- Gemma 4 - E2B – 採用逐層嵌入(per-layer embeddings)的密集模型,實際上相當於 20 億參數
- Gemma 4 - E4B – 採用逐層嵌入的密集模型,實際上相當於 40 億參數
- Gemma 4 - 31B– 擁有 310 億參數的密集模型
- Gemma 4 - 26B A4B – 混合專家(MoE)模型,總參數 260 億,其中推論時會啟用 40 億參數。
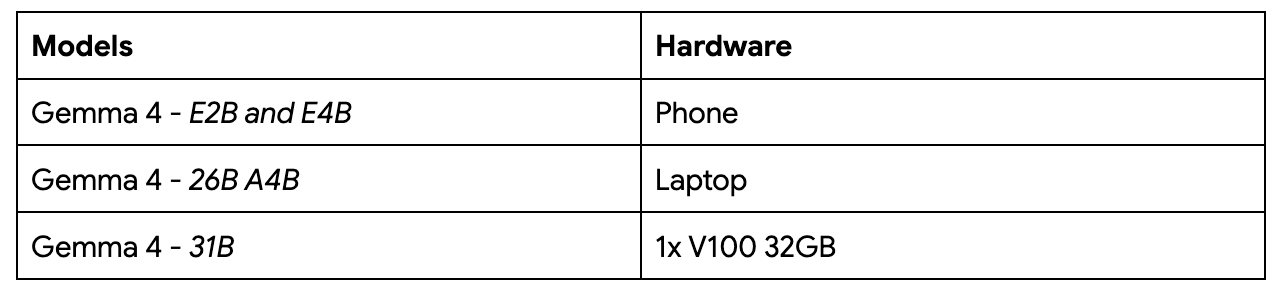
由於提供了多種模型尺寸,你可以選擇最符合使用場景的模型,並確認它真的能在你的硬體上運行:
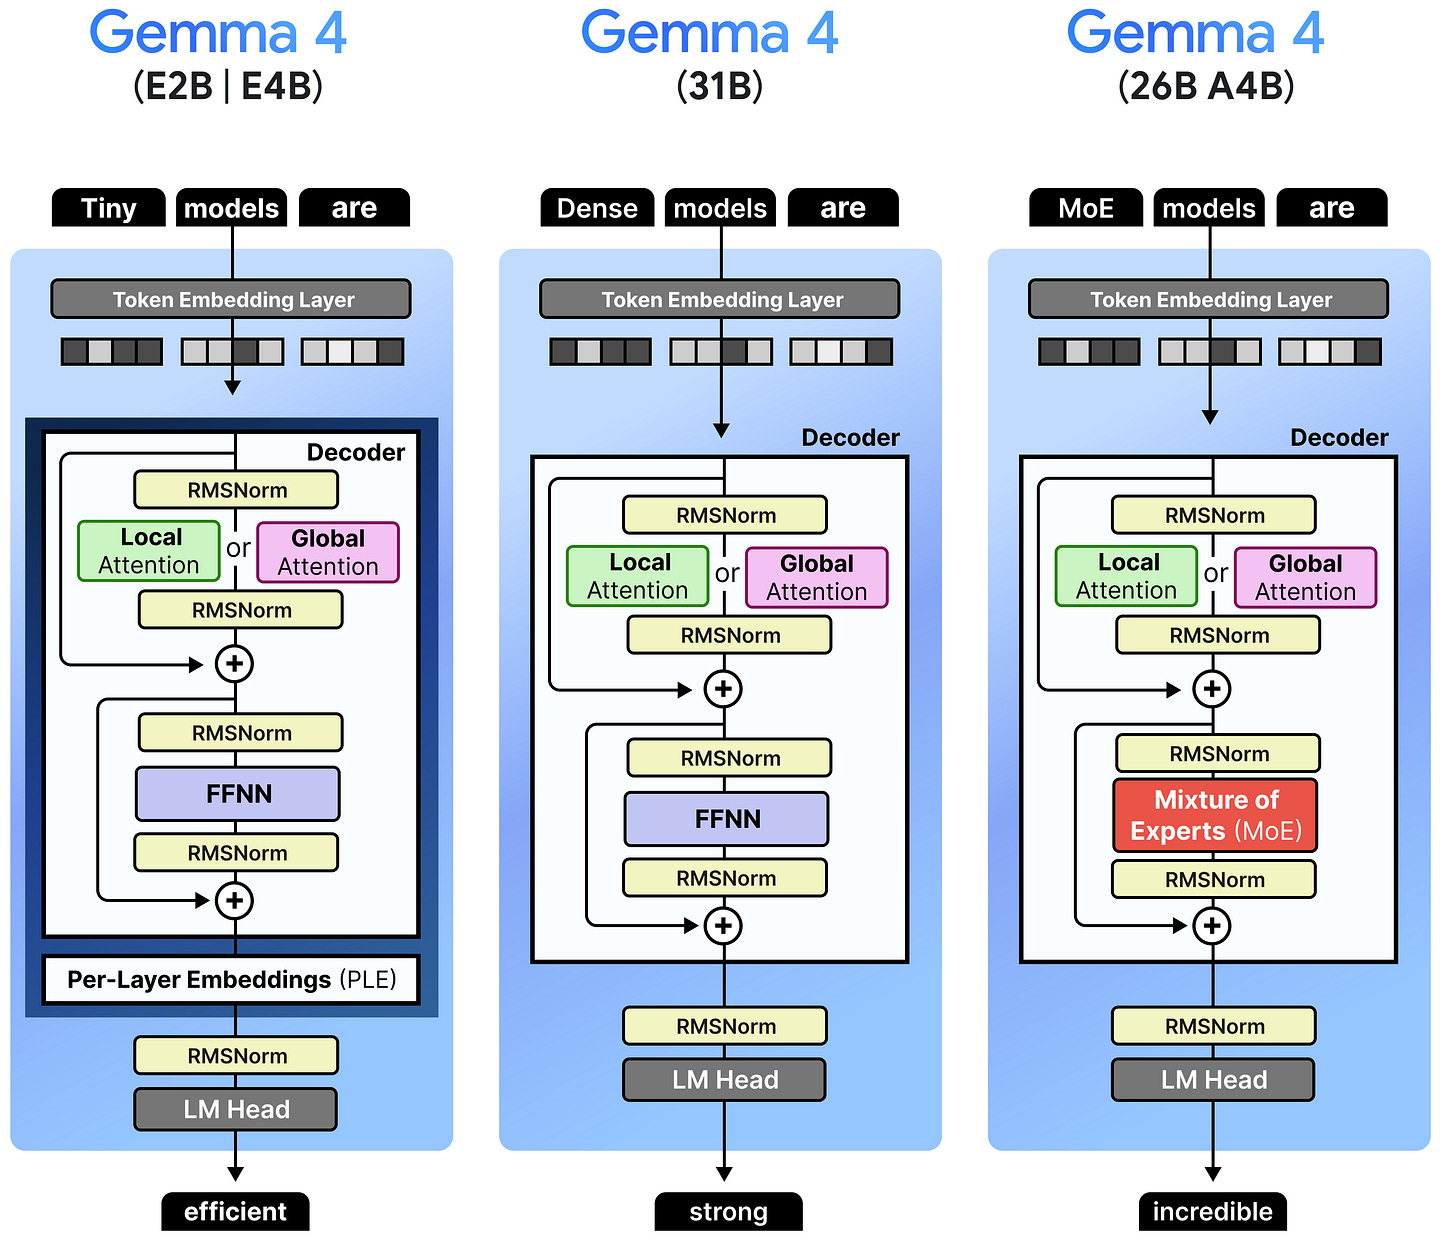
這些模型採用兩種主要的架構,分別是密集架構與混合專家架構。
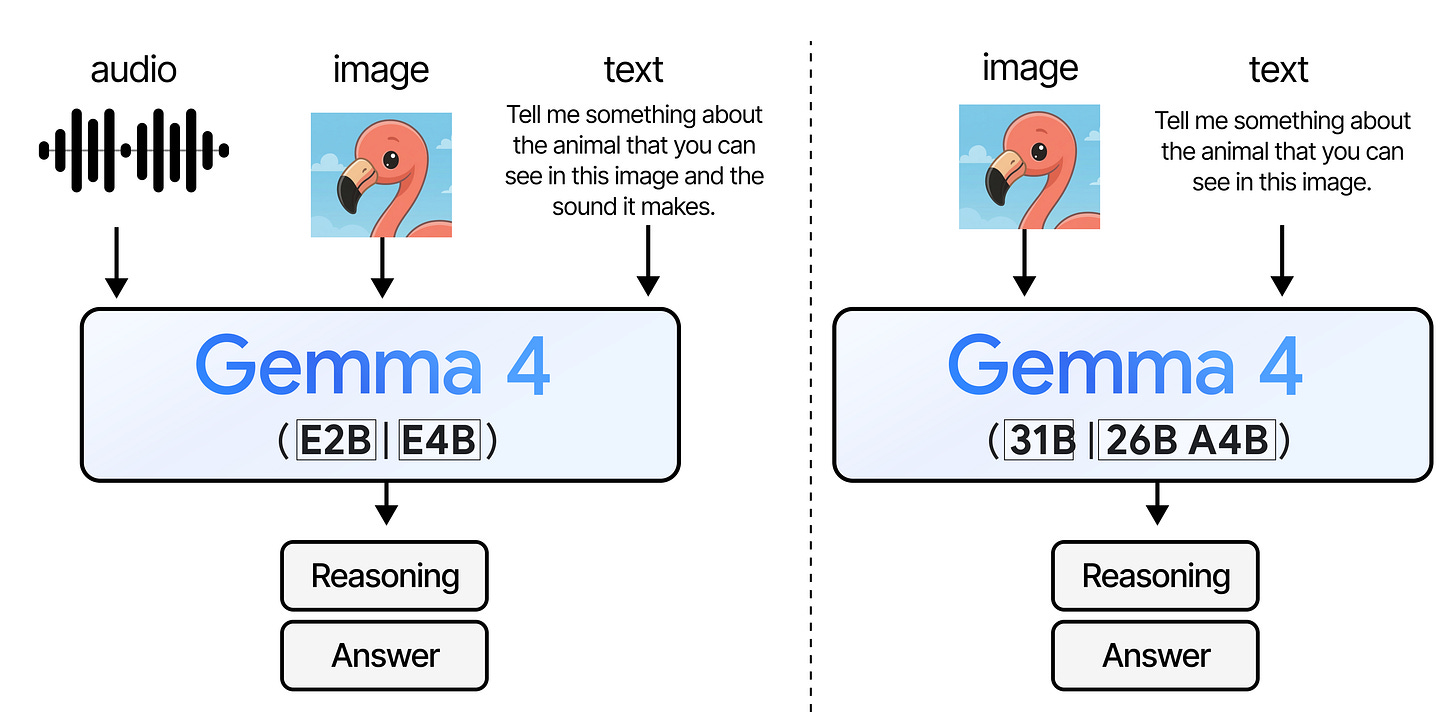
除了豐富的尺寸選擇,所有模型都是多模態的,可以推理輸入的圖像。它們經過訓練,能處理許多不同尺寸的圖像(後面會詳細介紹!)。
我特別想多嘗試一下小尺寸模型,因為它們不僅支援圖像與文字輸入,還支援音訊。
內容非常多,但在深入介紹不同尺寸與架構的細節之前,我們先來看看所有模型的共通點!
👈 點擊左側的行堆疊圖示以查看目錄(ToC)
Gemma 4 架構
Gemma 4 的架構在許多方面類似 Gemma 3 系列模型,只是有些地方做了調整。相較於 Gemma 3,所有尺寸模型都有的變更包括:
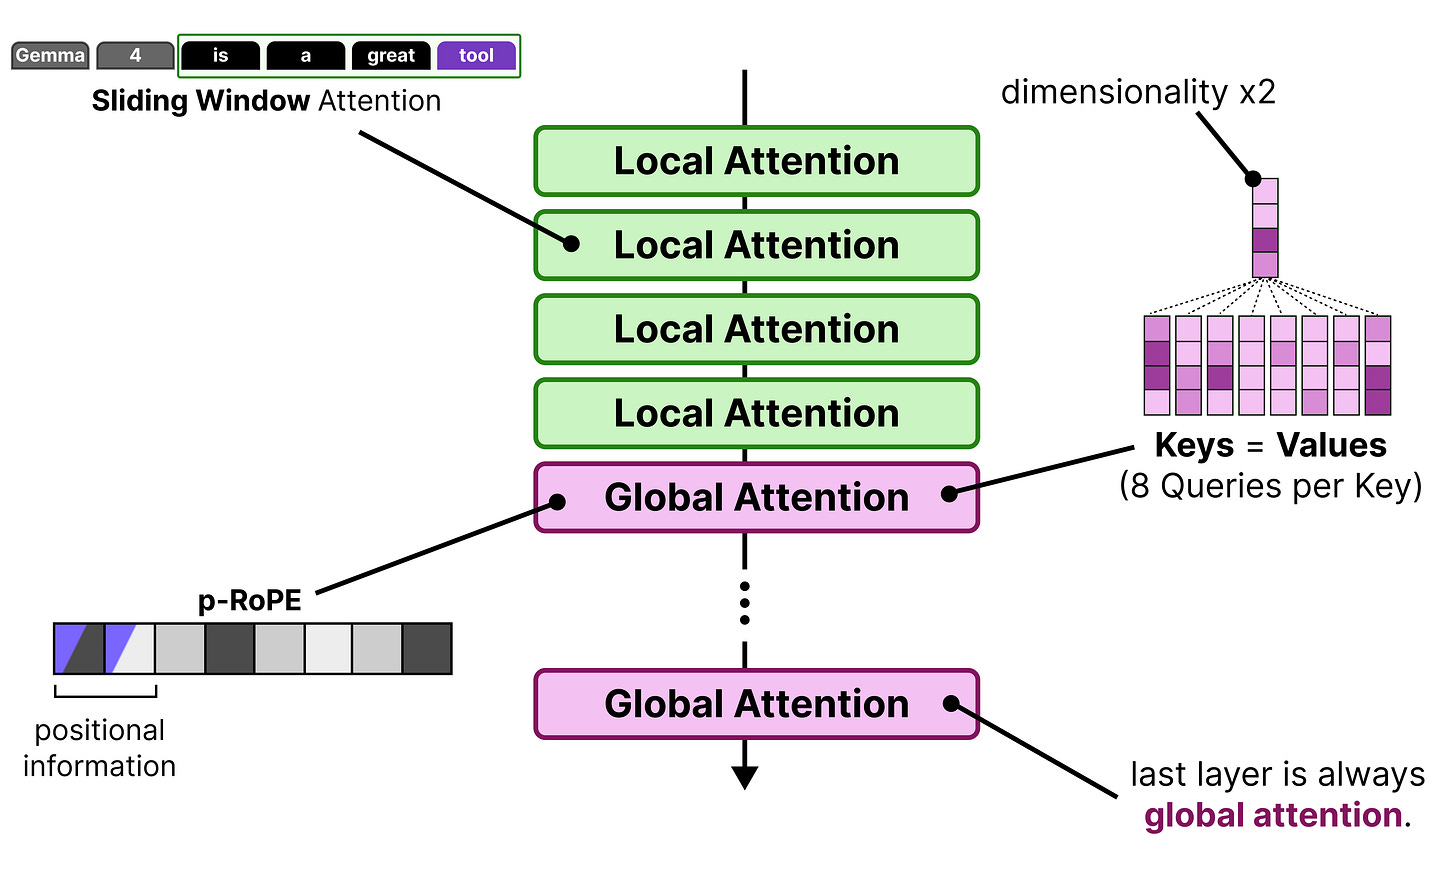
- 交錯層(Interleaving Layers) – 全域注意力(global attention)永遠是最後一層
- K=V – 僅在全域注意力中,鍵(Key)等同於值(Value)
- p-RoPE – 應用於嵌入的低頻剪枝 RoPE
有些模型與其他模型稍有不同(例如只有小模型使用逐層嵌入)。在深入介紹每個模型的細節之前,我們先更詳細地探討它們的共通點。
交錯層
與 Gemma 3 一樣,Gemma 4 交錯配置了區域注意力(也稱為「滑動視窗注意力」)層與全域注意力(即常規的「全注意力」)層。
在全域注意力中,每個詞元會關注它之前的所有詞元。而滑動視窗注意力只關注一定範圍內的詞元,這大幅減少了計算完整注意力所需的運算量。
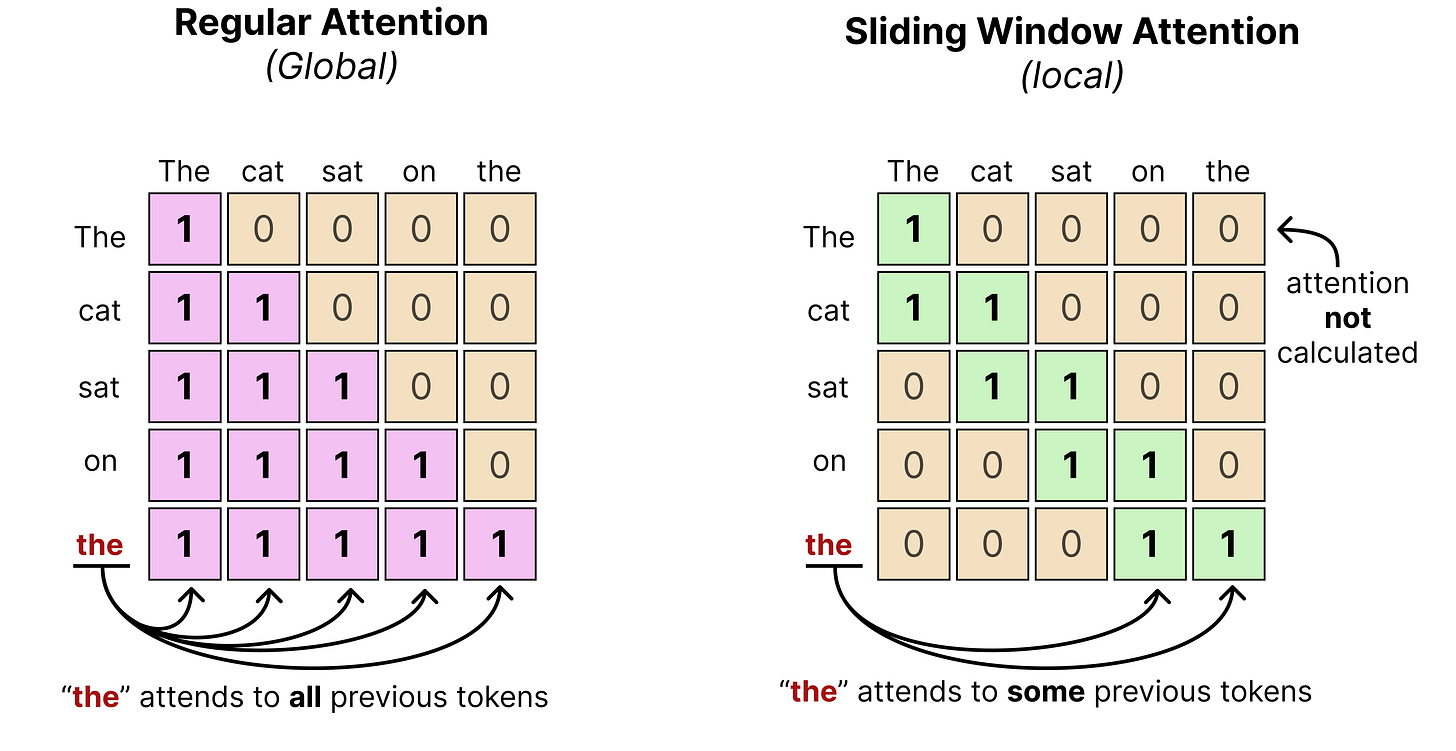
實際上,這表示當文字使用滑動視窗處理時,它可能只看到整個序列的一部分,而不是全部。所謂的「滑動」,指的是隨著詞元不斷生成,視野中的序列持續向前移動的概念。
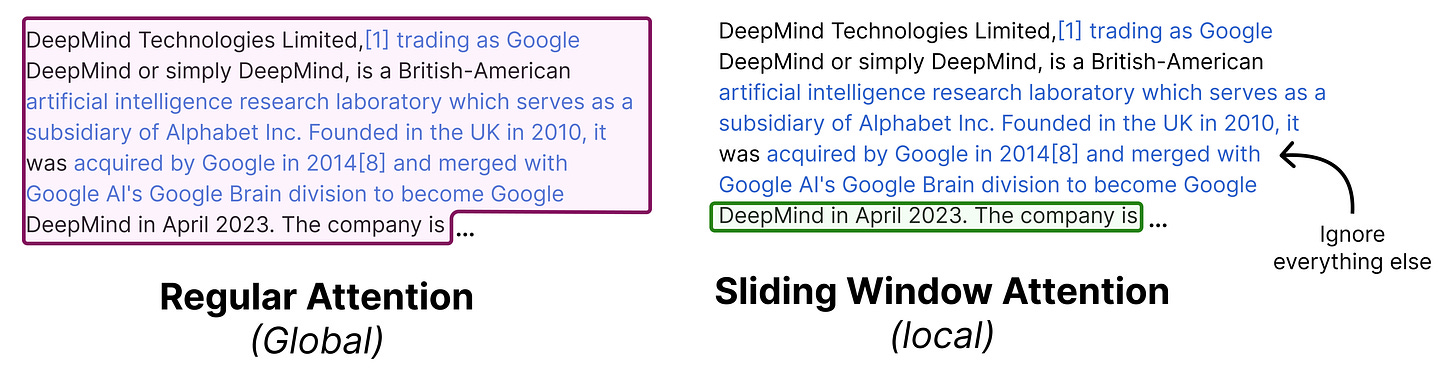
你通常會固定它能看到的詞元數量。在 Gemma 4 模型中,小模型(E2B 與 E4B)的滑動視窗為 512 個詞元,大模型(26B A4B 與 31B)的滑動視窗為 1024 個詞元。
讓我們以滑動視窗為 4 個詞元為例,看看每次生成詞元時發生了什麼:
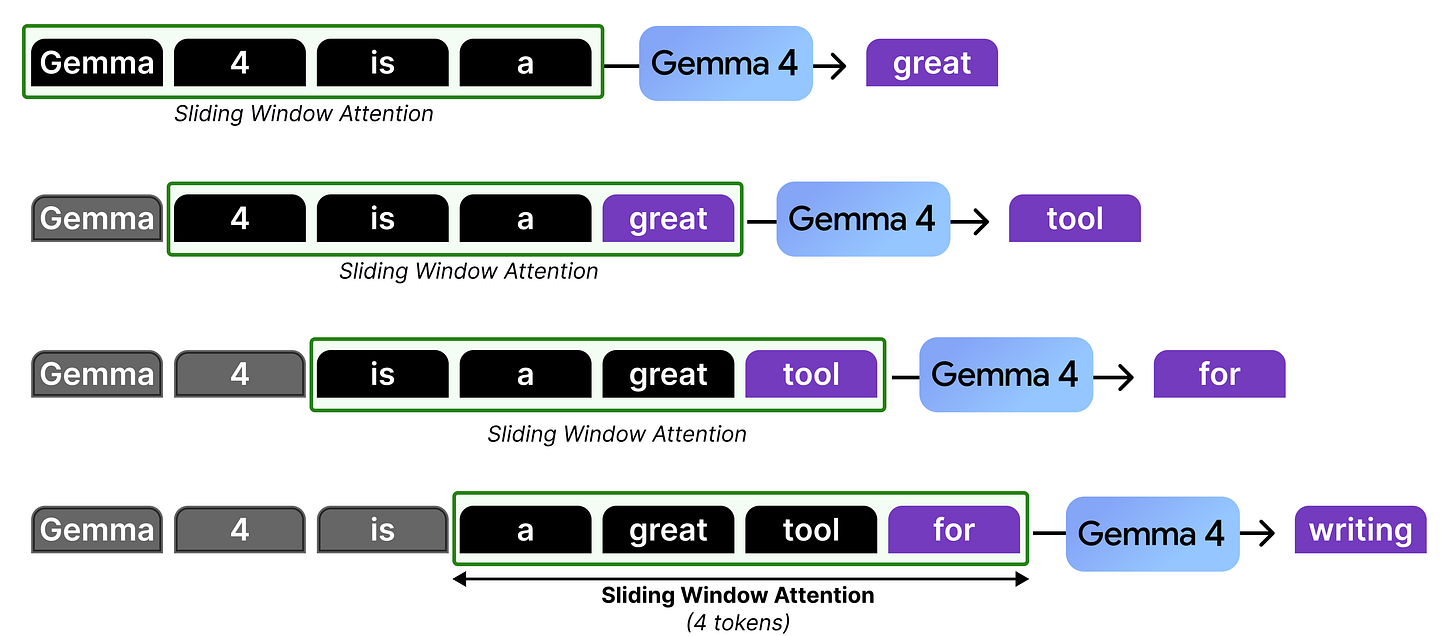
在這個例子中,注意力只給到最近的四個詞元,而在生成的某個時刻開始,「忽略」了更早的詞元。然而,它實際上並沒有忘記先前步驟中計算出的表示。隱藏狀態讓注意力得以沿著注意力機制,從先前的層與步驟一路傳遞到目前的詞元。
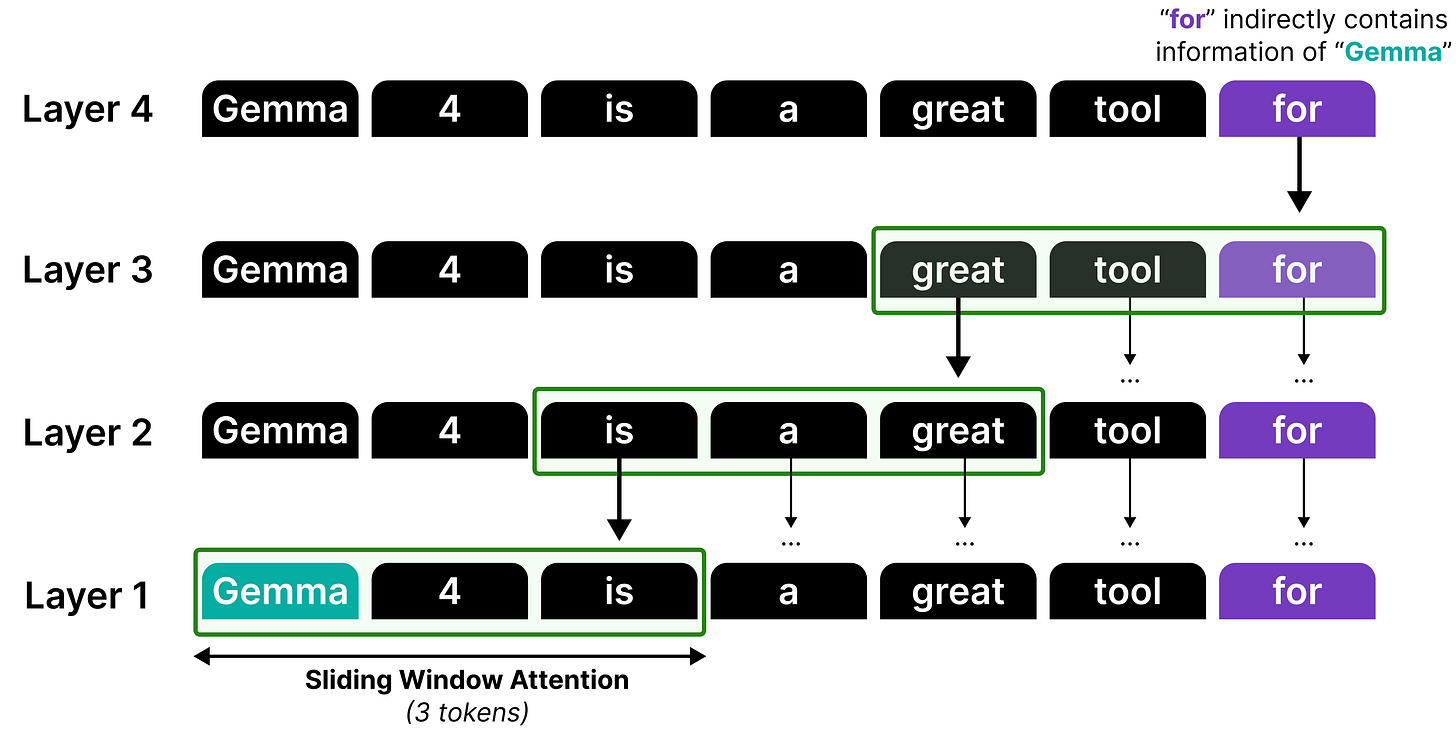
雖然堆疊滑動視窗可以傳遞資訊,但它並不是完美的記憶或注意力機制。想像它就像傳話遊戲,資訊每次經過一層就會被稀釋!
因此,就像在 Gemma 3 中一樣,區域注意力層與全域注意力層交錯配置,讓模型有時會關注完整序列,以更好地捕捉全域結構。
在 Gemma 3 中,這種交錯通常是 4:1 的模式:4 層區域注意力之後接 1 層全域注意力。然而,以 Gemma 3 - 4B 為例,它有 34 層,這意味著它的最後一層使用的是區域注意力而非全域注意力。Gemma 4 模型改變了這一點,確保最後一層永遠是全域注意力。
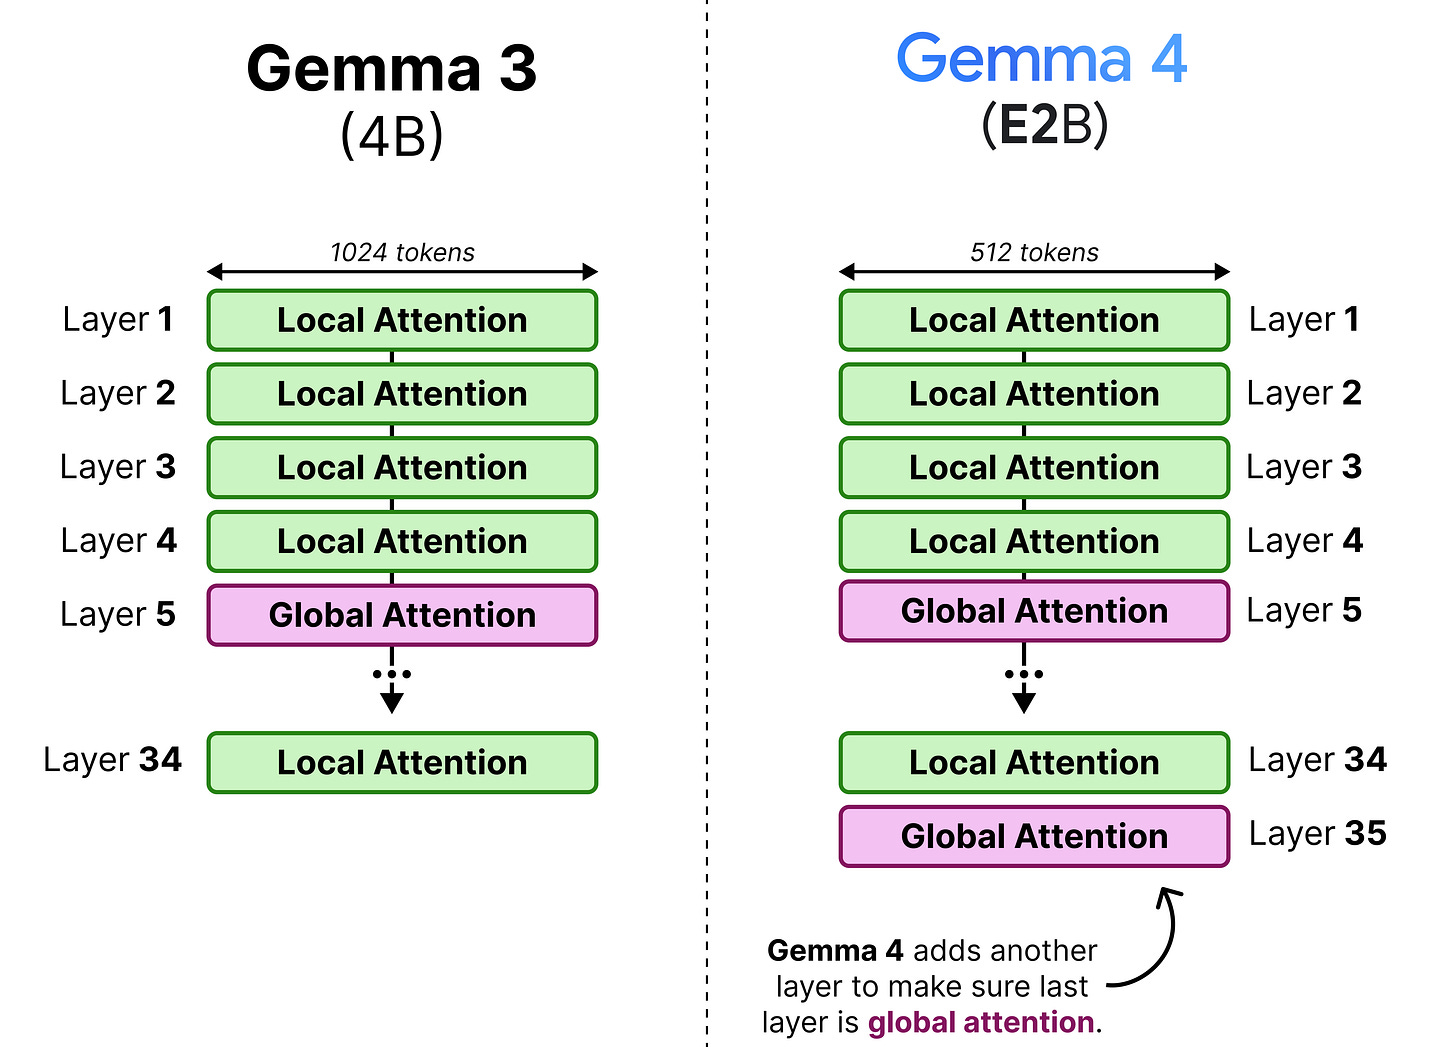
不過,4:1 的模式只適用於 E2B,其他變體都是 5:1 的模式:先是 5 層區域注意力,之後接 1 層全域注意力。我們可以將這個模式並排視覺化,同時展示這些模型的深度。
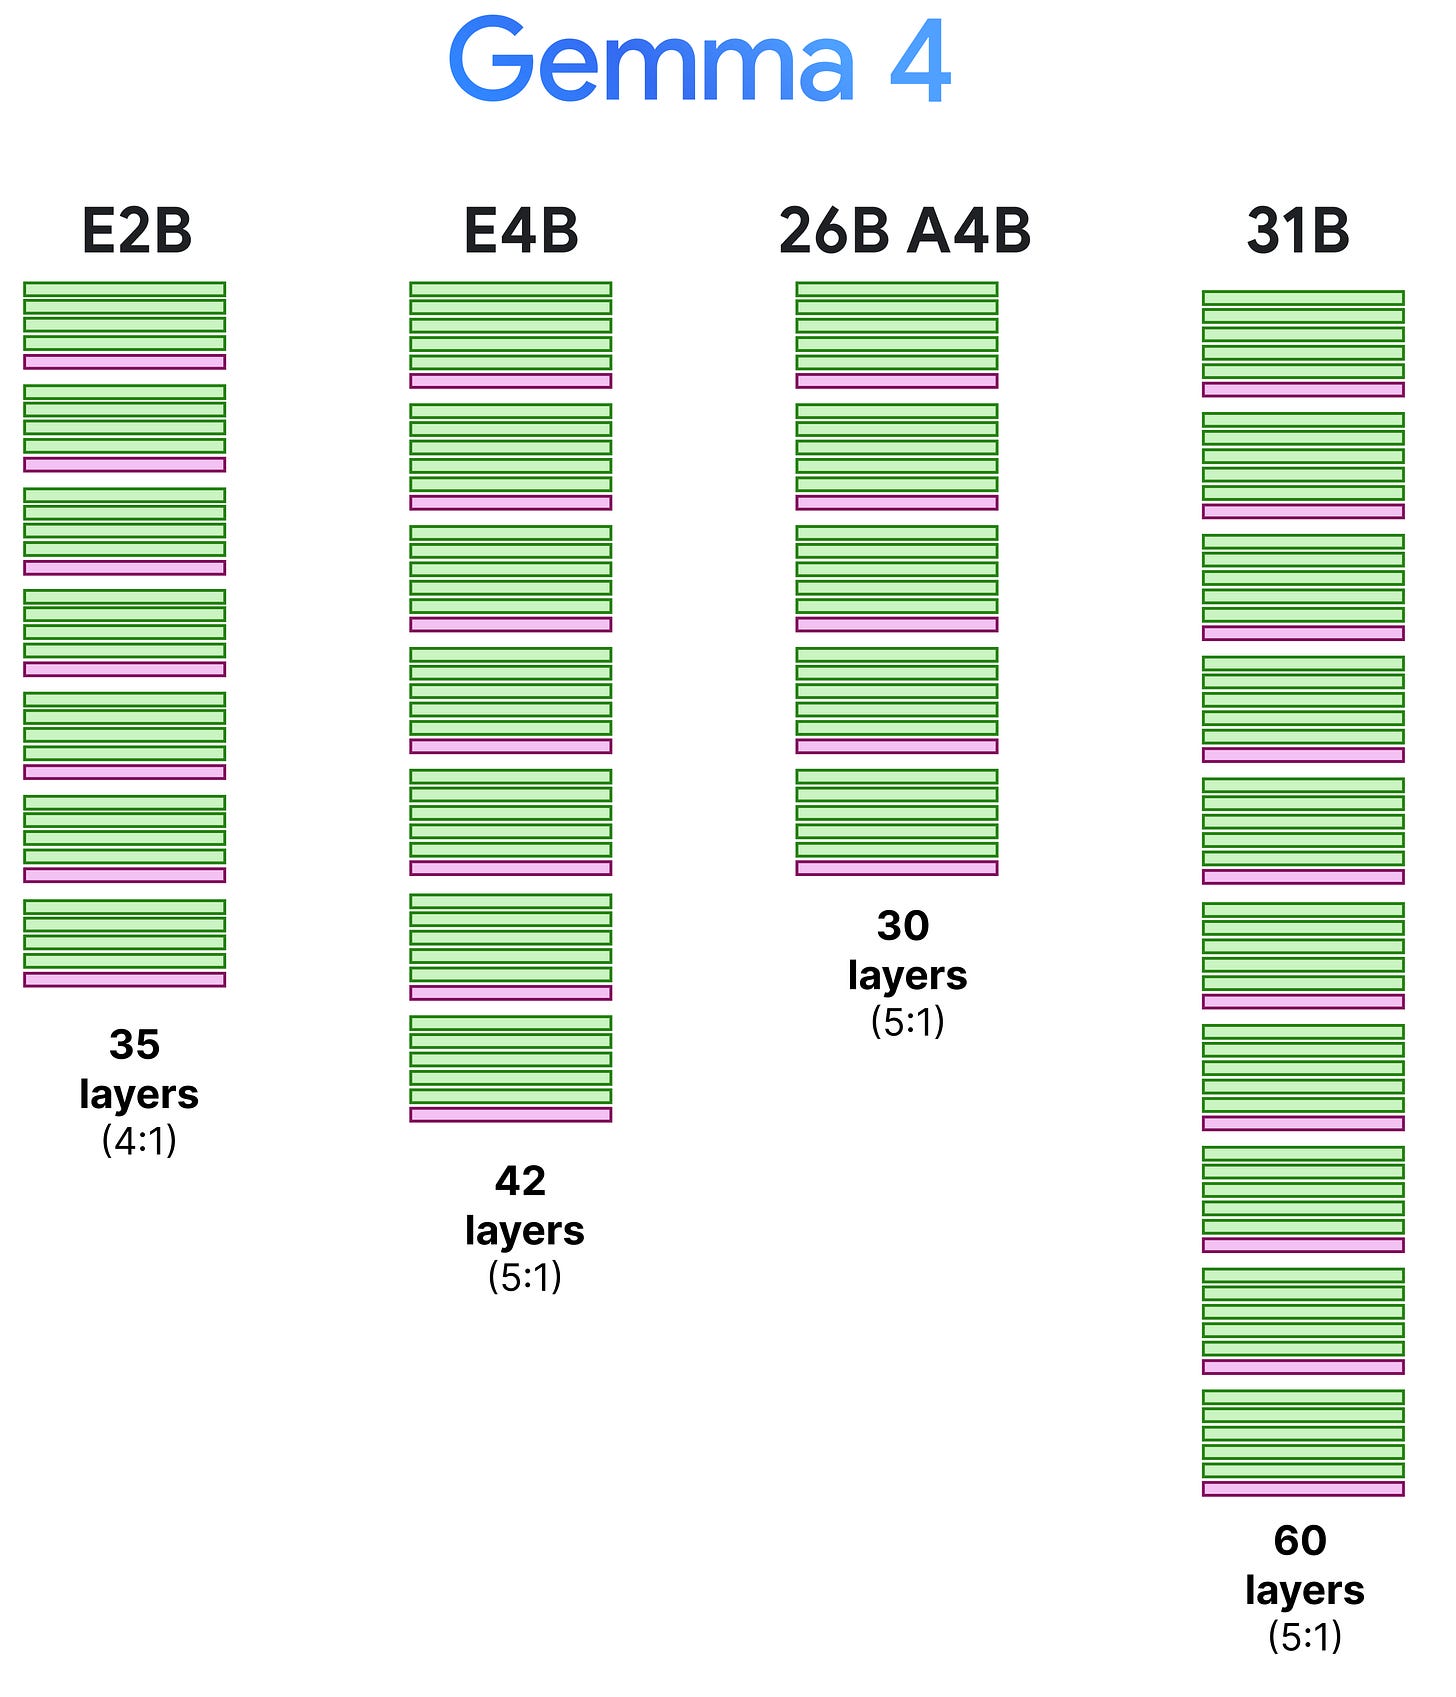
請注意,區域注意力層的上下文視窗從 1024 個詞元縮減到 512 個詞元,以進一步提升效率。
讓全域注意力更有效率
將區域注意力與全域注意力交錯配置,是讓大型語言模型更有效率的有趣方法,但天下沒有白吃的午餐。全域注意力層仍會關注整個上下文,這是一個耗費成本且緩慢的過程。
在本節中,我們將探討 Gemma 4 用來提升全域注意力層效率的各種技巧!
分組查詢注意力
與 Gemma 3 一樣,這些模型使用分組查詢注意力(GQA),讓查詢頭(Query head)可以共享 KV 值,減少需要快取的資料量。區域注意力層使用 GQA,由 2 個查詢頭共享 1 個 KV 頭。
在 Gemma 4 中,全域注意力層透過 8 個查詢頭共享 1 個 KV 頭來提升效率。這大幅減少了 KV 值所需的快取,因為全域注意力本身需要儲存的內容就已經很多(整個上下文),相較之下區域注意力層的上下文很小。
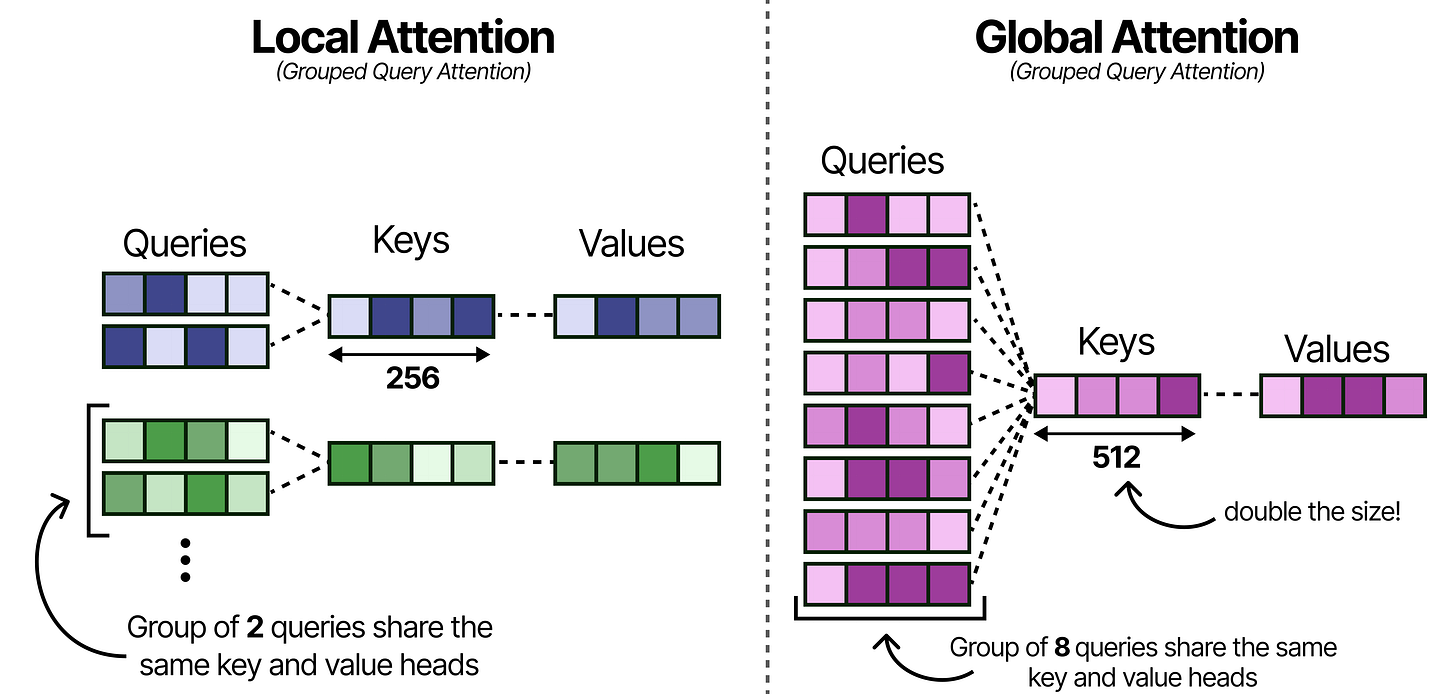
請注意,減少每個頭的鍵與值的數量可能會影響效能,因此為了補償,鍵的維度被加倍了!
加倍鍵的維度會佔用不少 KV 快取空間,所以讓我們來看看另一個減少 KV 快取的有趣技巧。
K=V
儘管分組查詢注意力的分組方式有所改進,全域注意力層因為關注整個序列,仍佔用相當多的記憶體。分組為 8 個查詢有點幫助,但還有更多可以提升效率的方法!
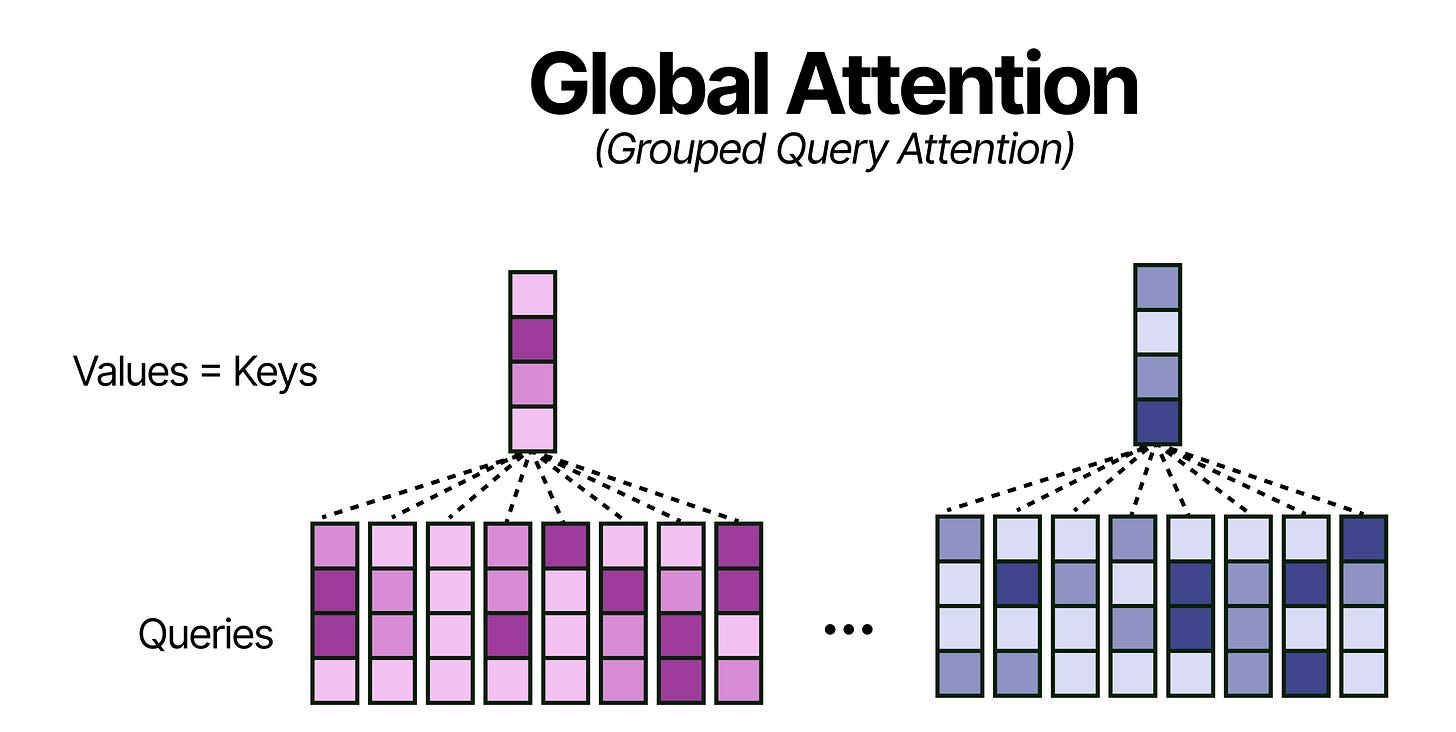
一個巧妙且幾乎不影響效能的技巧,是在全域注意力層中僅使用鍵與值。實際上,這表示所有鍵都等同於值,進一步減少了 KV 快取(或者更準確地說,現在是全域注意力層的 K 快取)的記憶體需求。
p-RoPE
任何大型語言模型的重要元件之一,就是如何追蹤序列中詞語的順序。最常見的技術之一稱為旋轉位置編碼(RoPE)。RoPE 將查詢與鍵向量切成兩個一組的數值對。每個數值對可以視為二維空間中指向某個方向的向量。RoPE 讓每個數值對的方向以遞減的速度稍微旋轉。第一組的旋轉幅度最大,最後一組最小。這種旋轉讓模型能夠追蹤詞語之間的相對距離。
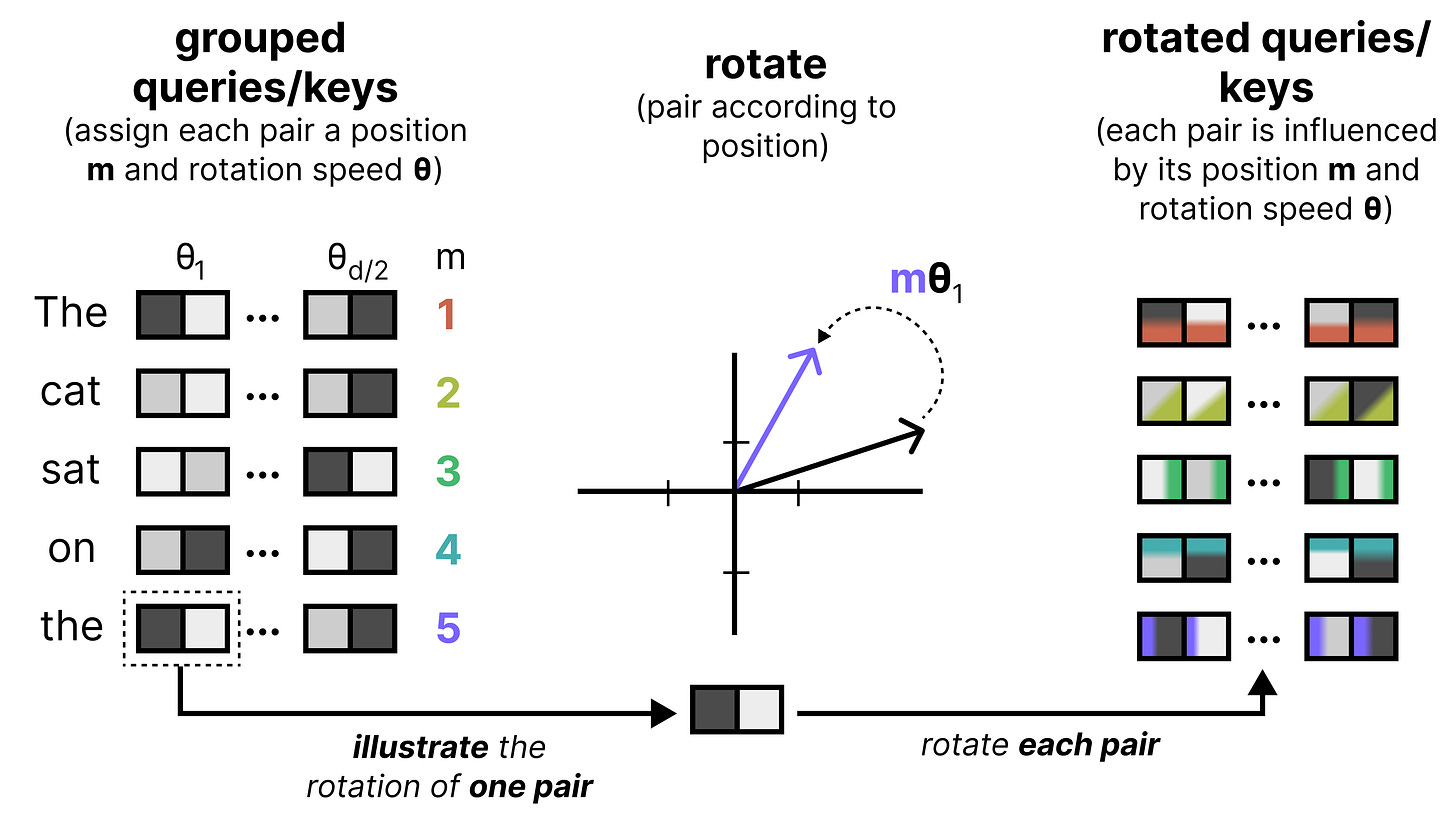
讓我們放大一點,看看旋轉查詢嵌入時發生了什麼。它先被切成兩個一組的數值對,每一組依序旋轉。旋轉本身隨著每組遞減,這稱為頻率:高頻表示旋轉幅度相當大,低頻則產生較小的旋轉。
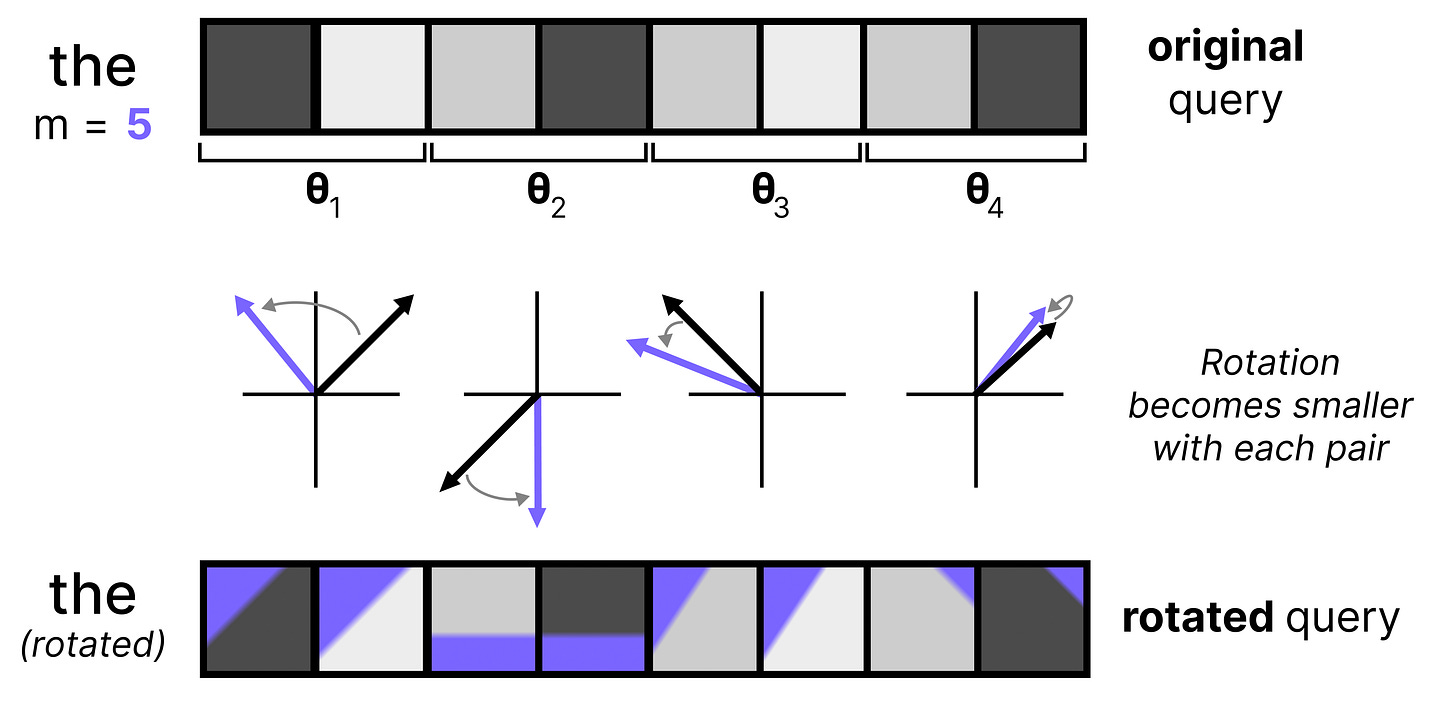
高頻數值對對位置的微小變化非常敏感,因為它們一開始就被賦予了大量資訊(大幅旋轉),非常適合追蹤詞語的位置。低頻數值對只得到非常輕微的旋轉,從一個詞到下一個詞幾乎不移動。由於這些低頻數值對只包含極少的位置資訊,且最接近原始的 KQ 值,它們更適合追蹤語義內容。因此,它們最忠於原本的樣貌(沒有位置資訊)。
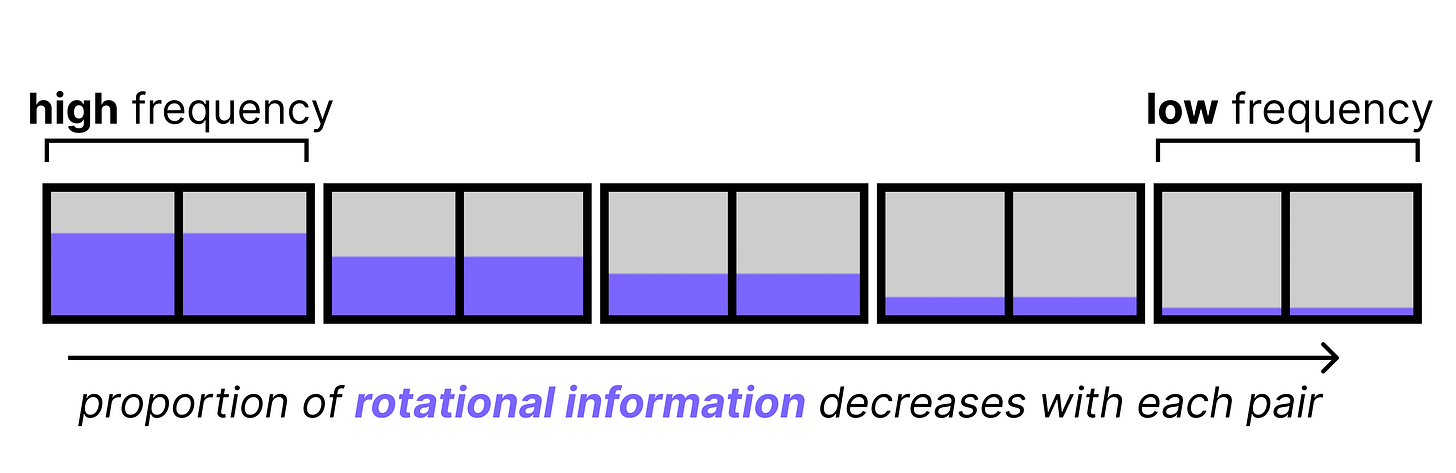
然而,事實證明高頻數值對已經包含了足夠的位置資訊。低頻數值對只包含一丁點位置資訊,少到沒有意義,甚至可能有害——因為模型傾向於用低頻數值對來處理語義資訊,所以額外的位置資訊只是雜訊。此外,在長上下文中,微小的旋轉會累積,最終導致相距很遠的詞元錯位,這會妨礙模型跨長序列連結詞語的能力。
一個優雅的解法是只對所有向量的部分維度應用 RoPE,稱為 p-RoPE。如果 p 是 0.25,則只有前 25% 的數值對獲得位置資訊,其他數值對都設為 0。這讓低頻數值對得以保留語義。
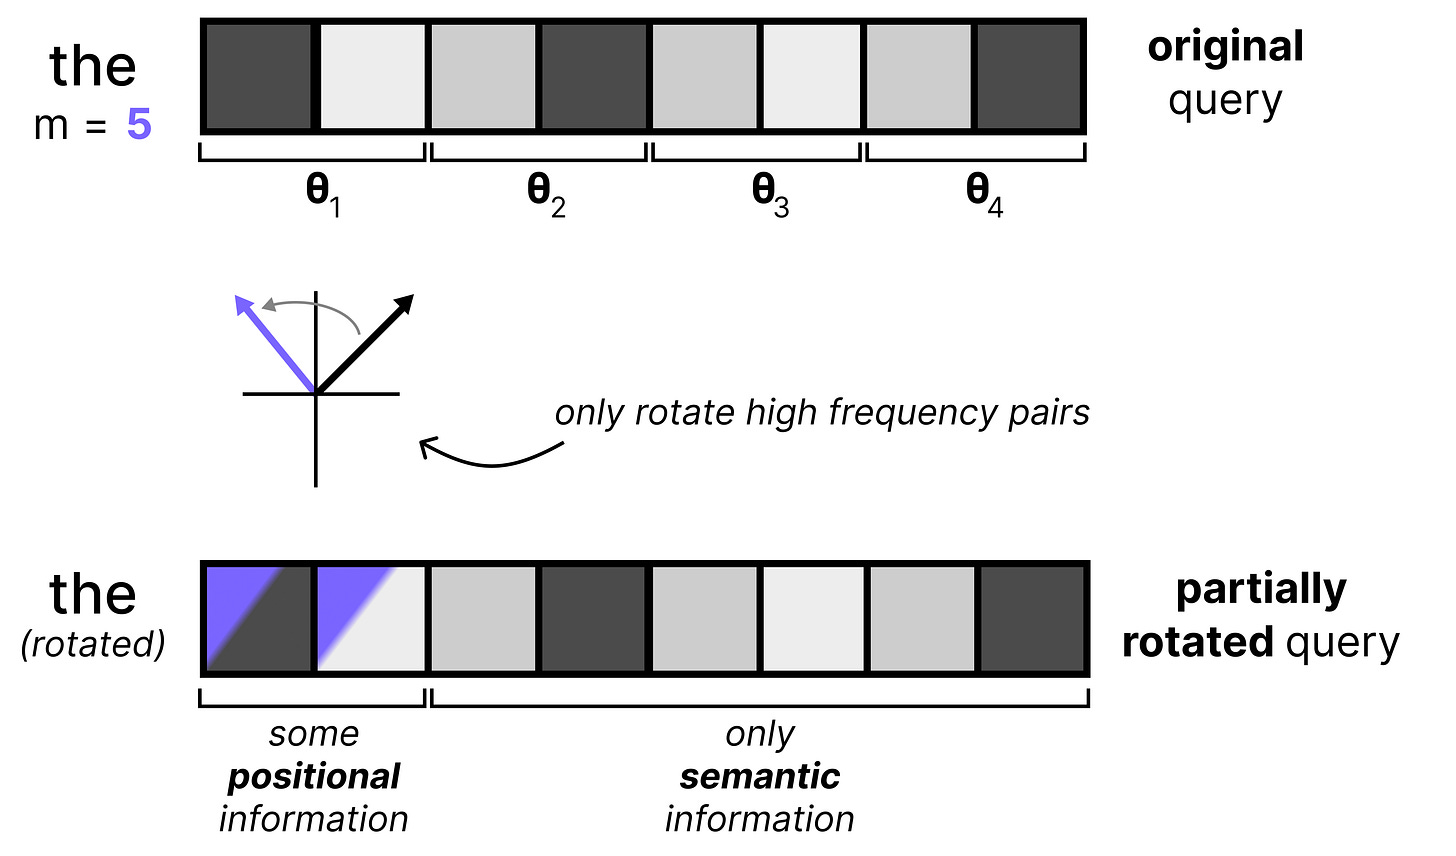
Gemma 4 在全域注意力層使用 p-RoPE,因為那裡的上下文視窗遠大於區域注意力層。此外,p-RoPE 在全域注意力層特別有用,因為大上下文視窗可能導致詞元之間的距離是模型從未見過的。相較於區域注意力,全域注意力的所有可能 RoPE 旋轉空間相當大,限制旋轉次數能讓模型更擅長處理大上下文。
把所有東西放在一起後,應用於全域注意力層的改進如下:
- 最後一層永遠是全域注意力層
- 每個鍵對應 8 個查詢的分組
- 鍵的維度加倍
- 鍵 = 值
- p=0.25 的 p-RoPE
視覺編碼器
Gemma 4 發布的一大重點是多模態能力。所有變體都支援圖像輸入,並能處理可變的長寬比與解析度!
實現這一點的是基於視覺 Transformer(ViT)的視覺編碼器,用於處理圖像。ViT 的運作方式類似一般的大型語言模型,只是不把文字切詞成詞語序列,而是把輸入圖像切成圖塊(patch)序列。每個圖塊(輸入圖像的一部分)接著被傳入 Transformer 模型,為每個圖塊輸出一個嵌入。
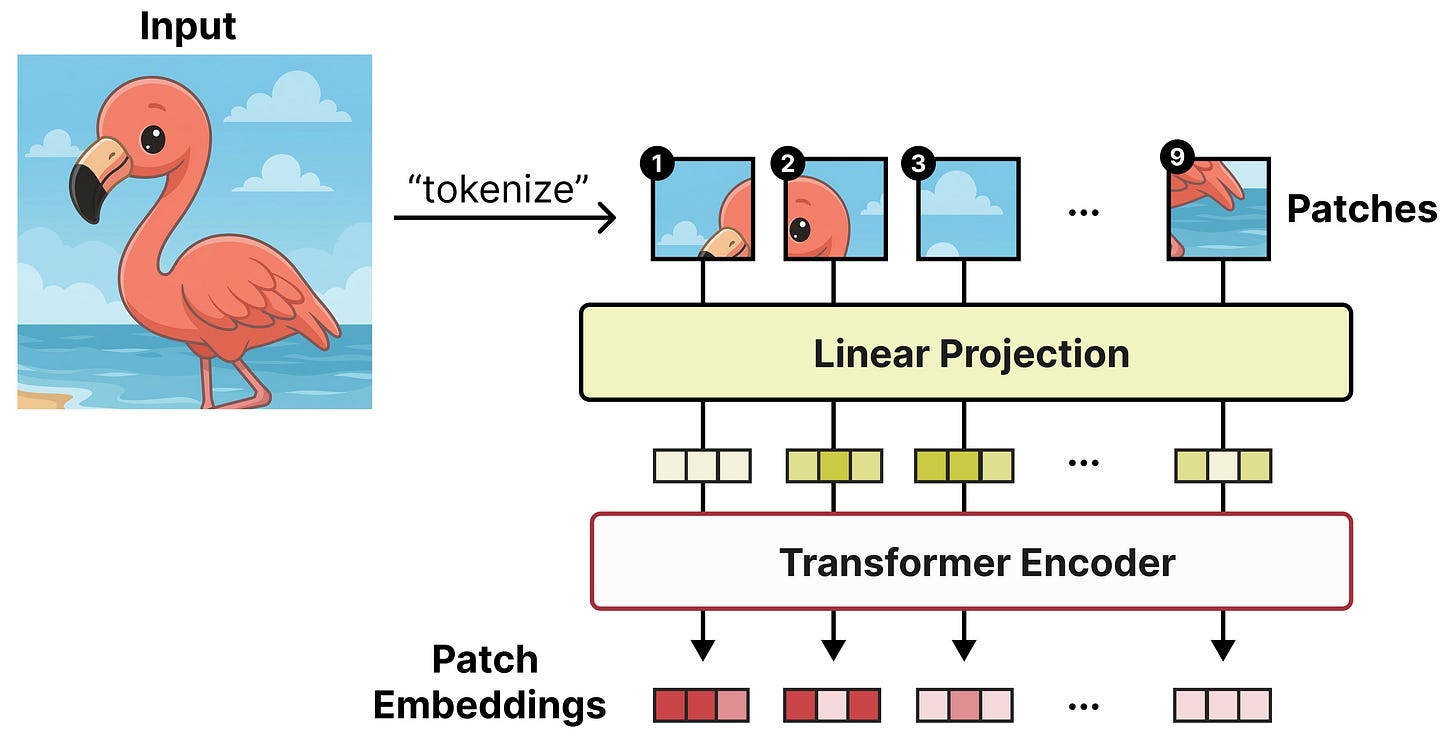
每個圖塊都是原始圖像的一小部分,通常是 16 x 16 像素。原始論文的名稱就很貼切:「An image is worth 16x16 words: Transformers for image recognition at scale」。
可變長寬比
ViT 假設原始圖像是一個正方形,可以切成 16 x 16 像素的圖塊。但這個方法有個缺點:當你處理圖塊序列,而原始圖像有各種不同的尺寸時,某個圖塊的位置(例如圖塊 4)代表的意思會隨著原始圖像的比例而改變。例如,如果假設原始圖像永遠是 3 x 3 的圖塊網格,那麼圖塊 4 永遠在正中間。但如果網格是動態的,例如可以是 2 x 4 的圖塊,那麼圖塊 4 就不在中間了。
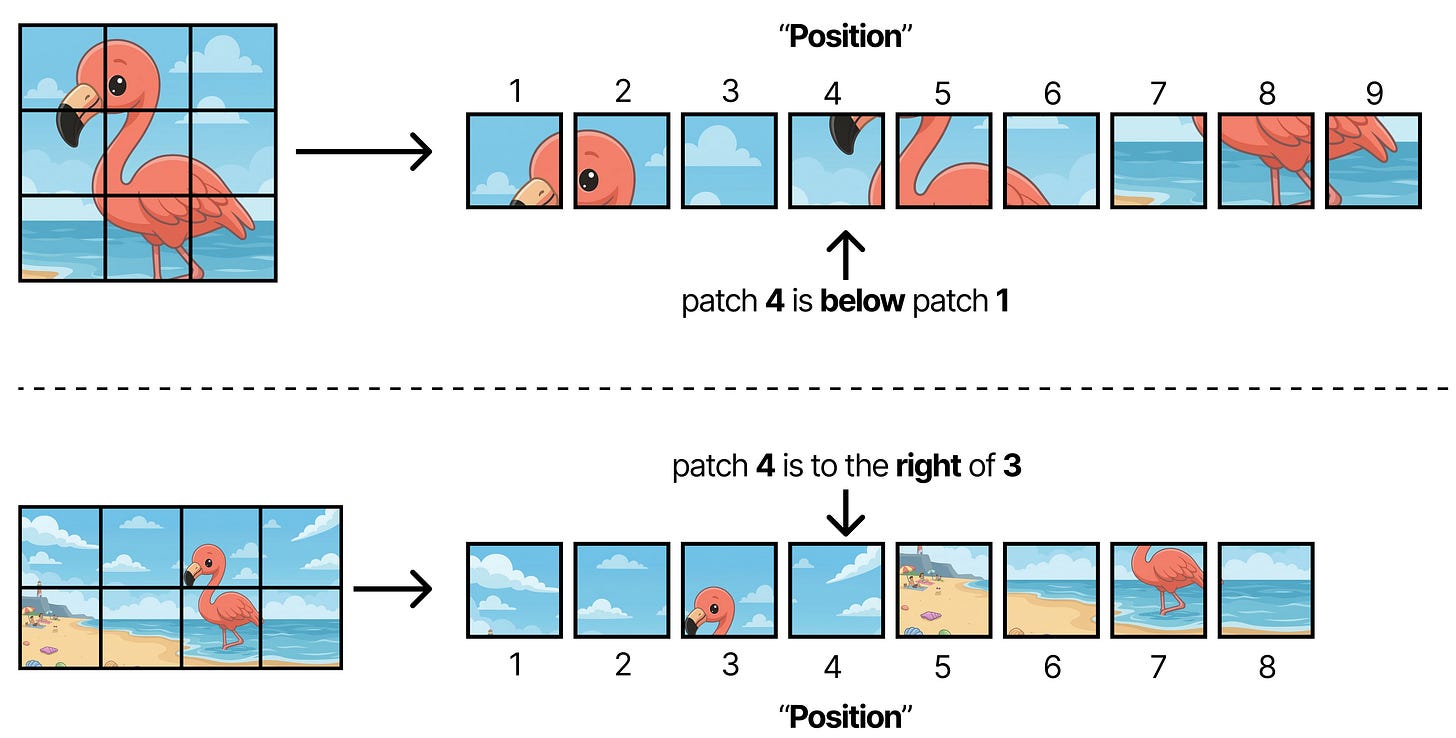
因此,應用 RoPE 不再直觀,因為位置的意義(「圖塊 4」)現在完全取決於原始圖像的長寬比。
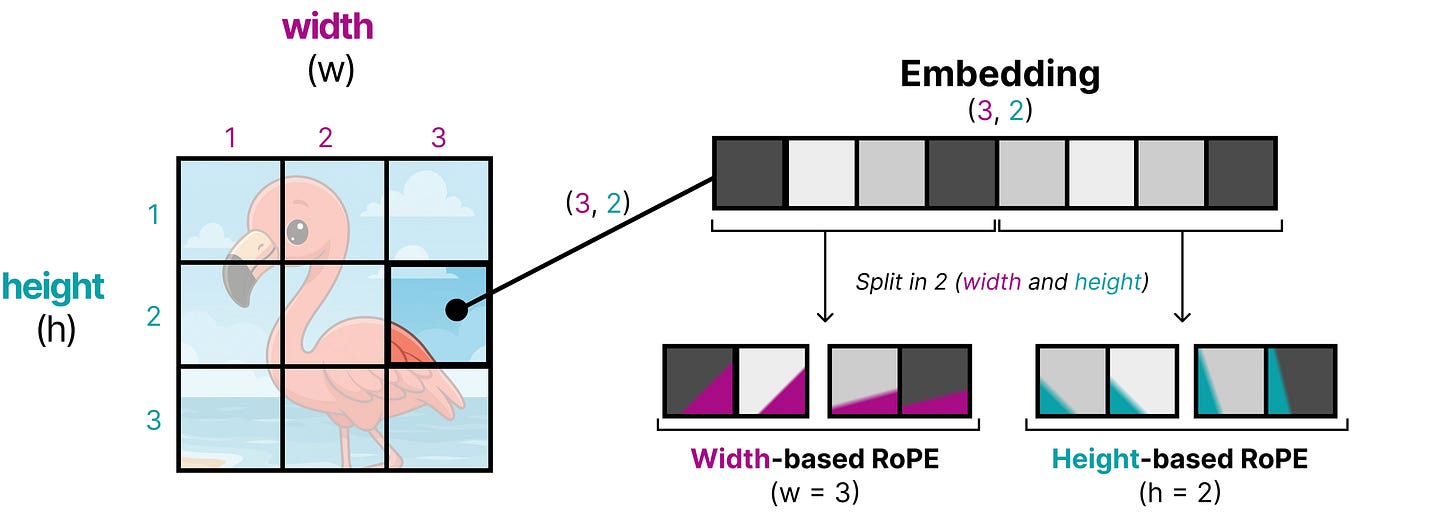
Gemma 4 應用的一個有趣技術,是用 2D RoPE 取代 RoPE,嘗試將圖塊的 2D 位置注入位置嵌入中,而不是把圖塊視為一維序列。做法是先將圖塊的嵌入切成大小相等的兩半,兩半各自獨立應用 RoPE,但不再用 m 作為位置,而是用寬(w)與高(h)來加入位置資訊。這樣,一半的嵌入就包含了相對寬度位置的位置資訊,另一半則包含相對高度位置的位置資訊。
光用 2D RoPE 還不足以支援可變長寬比。原始的 ViT 會把輸入調整成正方形,好讓處理後的輸入正好切成 16 x 16 像素的圖塊。想像你有一張寬幅圖像,硬要把它塞成正方形……看起來不是很怪,就是會裁掉很多內容!
Gemma 4 透過自適應調整輸入圖像的尺寸來支援不同的長寬比,同時仍支援 16 x 16 像素的圖塊。為了維持原始長寬比,當無法完美切成 16 x 16 像素方格時,就會對圖像做填充。
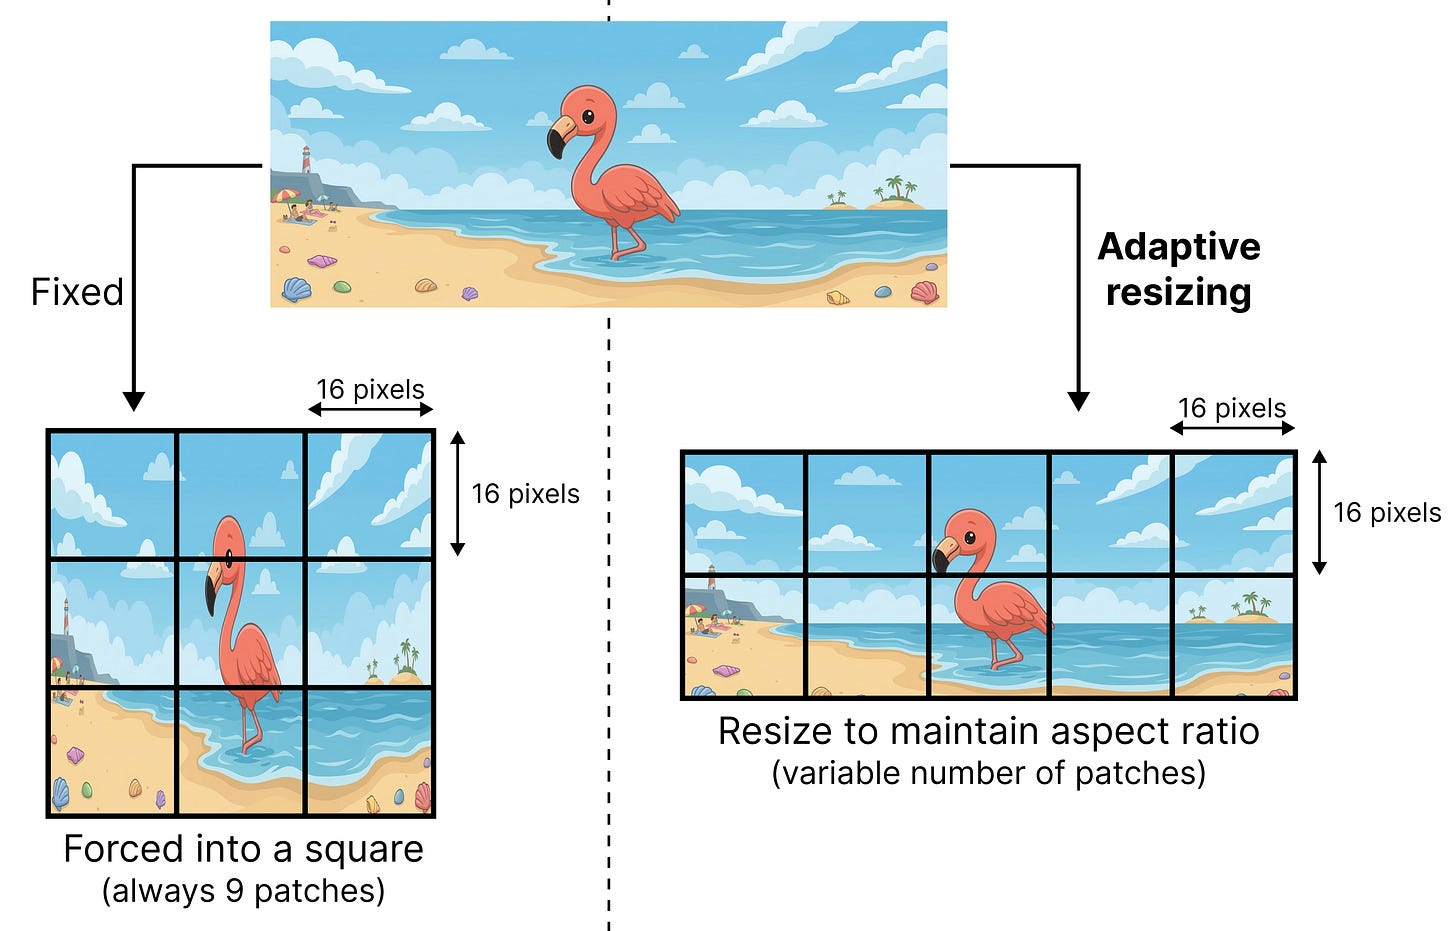
原始 ViT 通常假設正方形是固定尺寸,因此總是得到固定數量的圖塊(在我們的例子中是 9 個)。自適應調整方法會回傳可變數量的圖塊,數量可能增長得很快。因此,ViT 產生的詞元會根據空間位置做池化,彼此靠近的圖塊嵌入會被合併,直到剩下固定數量的圖塊嵌入。
可變解析度
可變長寬比解決了許多問題,但我們要如何決定圖塊的數量?長寬比相同的兩張圖像可能有不同的解析度。想像兩張長寬比都是 3:2 的圖像,一張是較低解析度的 272 x 176,另一張是較高解析度的 544 x 352。
一種方法是永遠決定一個固定的圖塊數量,並據此調整圖像尺寸。然而,對於某些任務我們可能想支援更高的解析度,例如物件偵測與分割,而對於影片,我們用較小的解析度就好,以加速後續影格的分析。
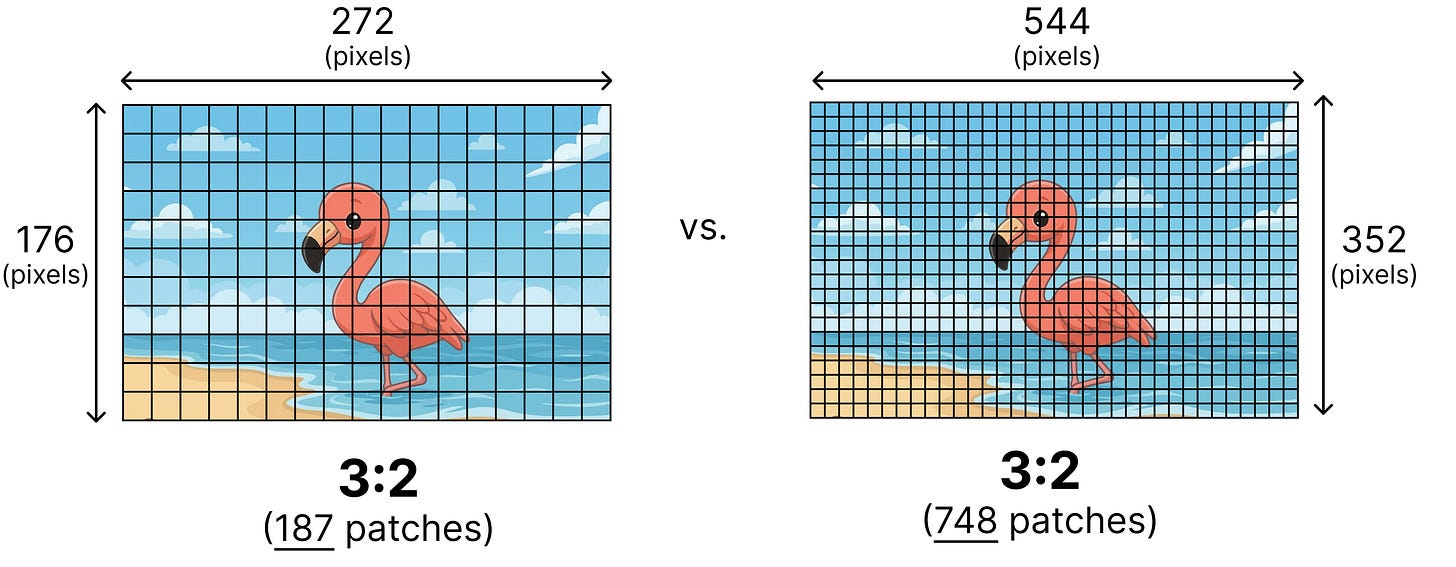
Gemma 4 透過引入軟詞元預算(soft token budget)來支援不同的解析度。這個預算代表傳給 LLM 處理的圖塊嵌入(也稱為軟詞元或視覺詞元)數量的上限。使用者可以在 70、140、280、560 或 1120 詞元的預算尺寸中選擇。
圖像的調整幅度取決於預算。如果預算較高(例如 1120 詞元),圖像可以維持較高的解析度,因此需要處理的圖塊就多很多。如果預算較低(例如 70 詞元),圖像就需要縮小,需要處理的圖塊就少。預算越高(詞元越多),能捕捉的資訊就越多。
這個預算決定了圖像的縮放程度。假設你的預算是 280 個詞元,那麼圖塊數量的上限就是 9 x 280 = 2,520。為什麼要乘以 9?因為在下一個步驟中,每個 3x3 的相鄰圖塊區塊會被取平均,合併成單一嵌入。
預算尺寸大致對應以下解析度:
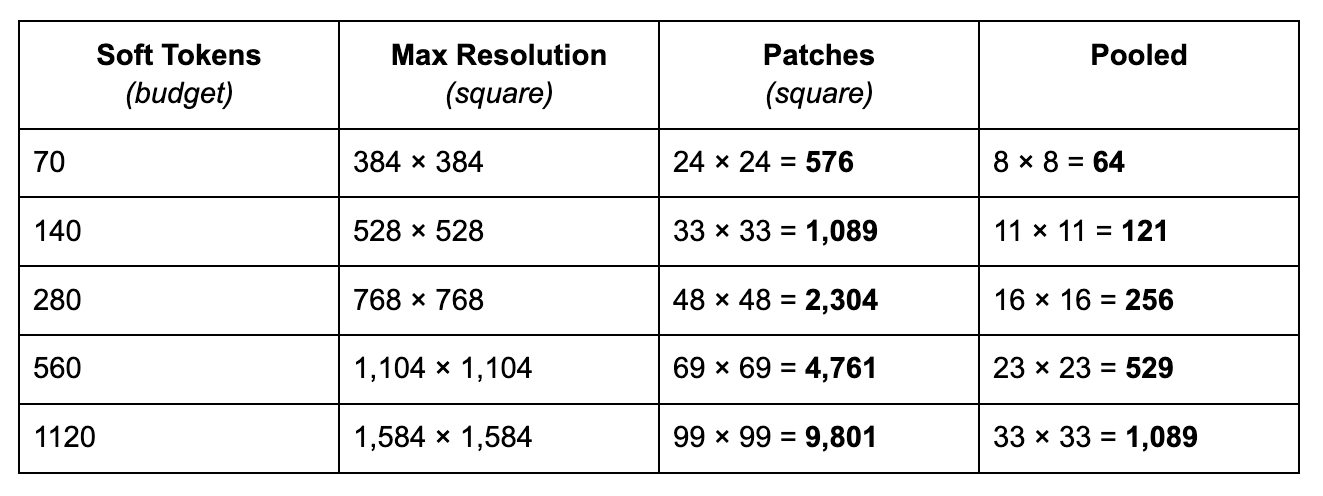
為簡單起見,這裡假設是正方形,但有了可變長寬比,它可以是不同的比例,因此圖塊也會有不同的維度。另外請注意,軟詞元比池化後的嵌入實際數量還少,那是因為解析度必須是 48 的倍數——每 3 個 16 像素的圖塊會被池化成單一嵌入。
下面是一個例子,展示最初大量的圖塊如何被取平均(也稱為池化),變成數量較少的圖塊嵌入(也稱為軟詞元)。
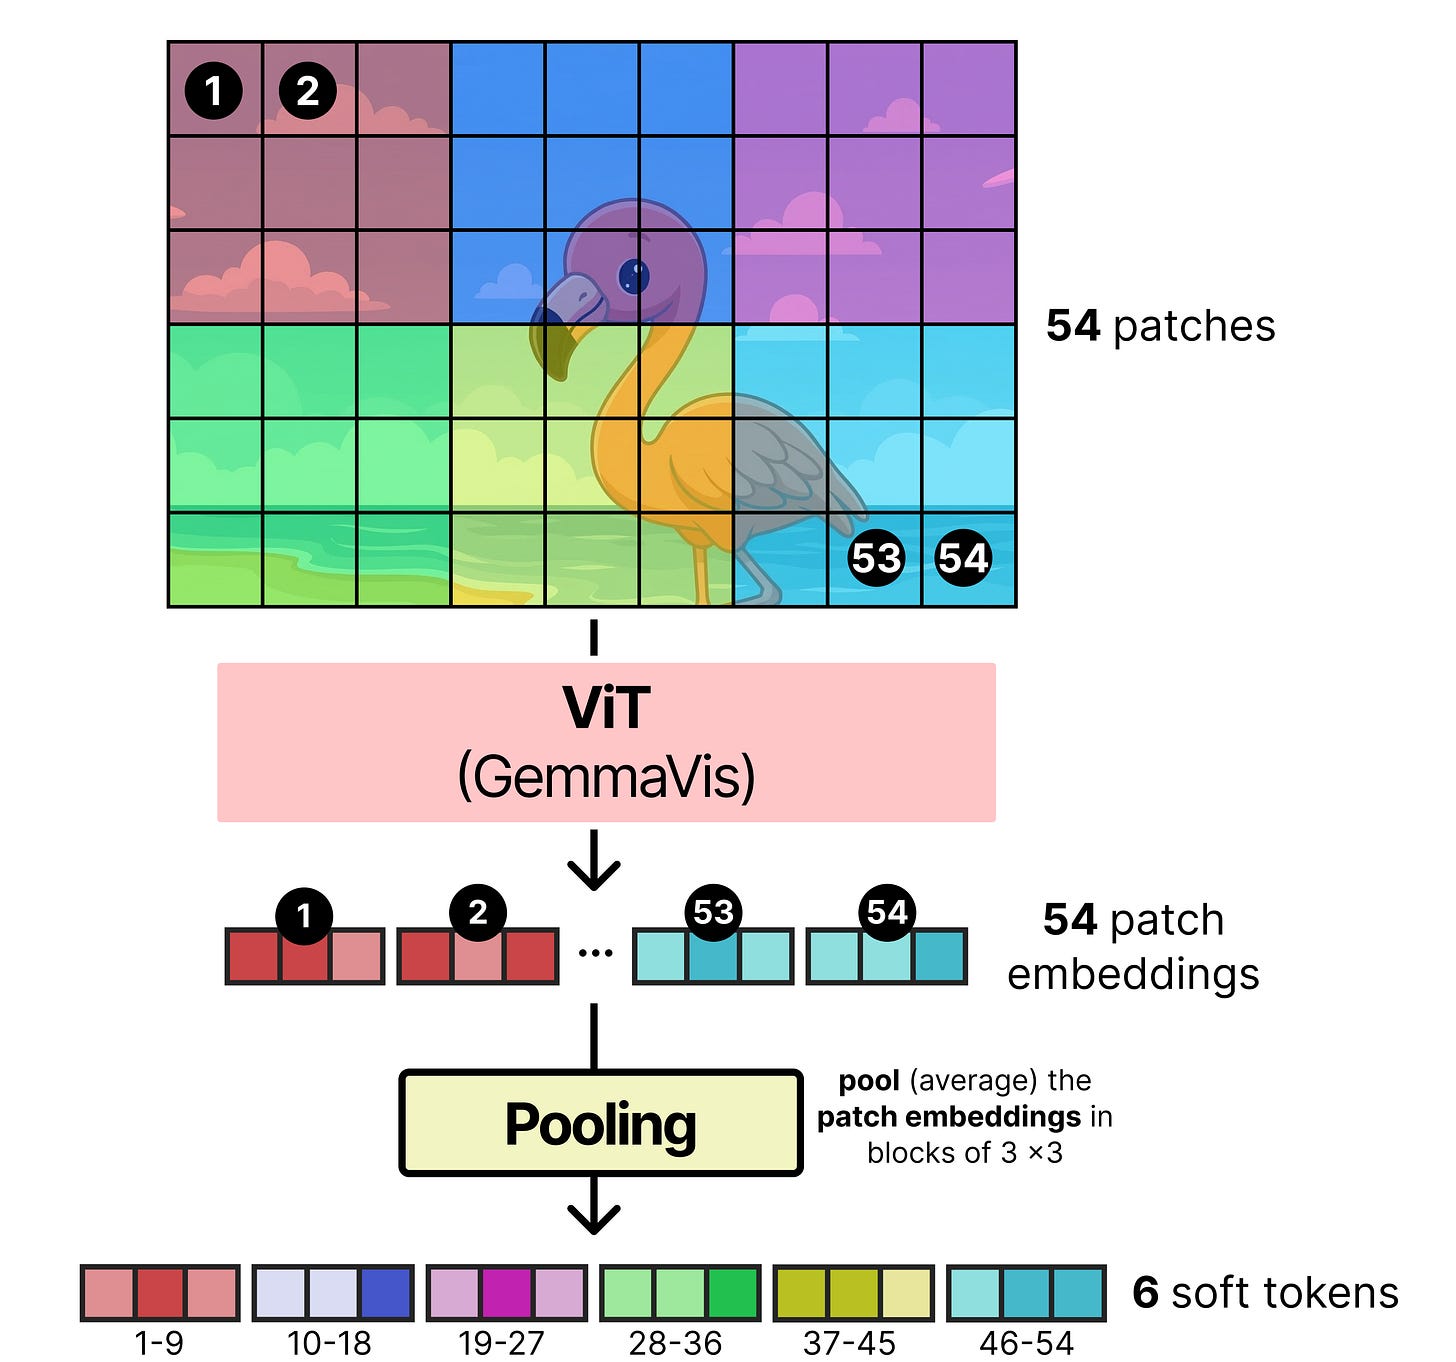
池化後的圖塊通常比詞元預算小,因為不是每張圖像都能正好用滿圖塊數量的上限。
線性投影
圖像編碼器產生的圖塊嵌入無法直接餵給 Gemma 4。跟所有語言模型一樣,它要求輸入嵌入具有特定的維度才能處理。理想情況下,你也希望它的嵌入佔據的維度空間與詞元嵌入類似,這樣它們才能輕鬆比較。
下圖有個很好的例子,可以看到圖像編碼器產生的嵌入與文字編碼器產生的詞元嵌入有多麼不同。
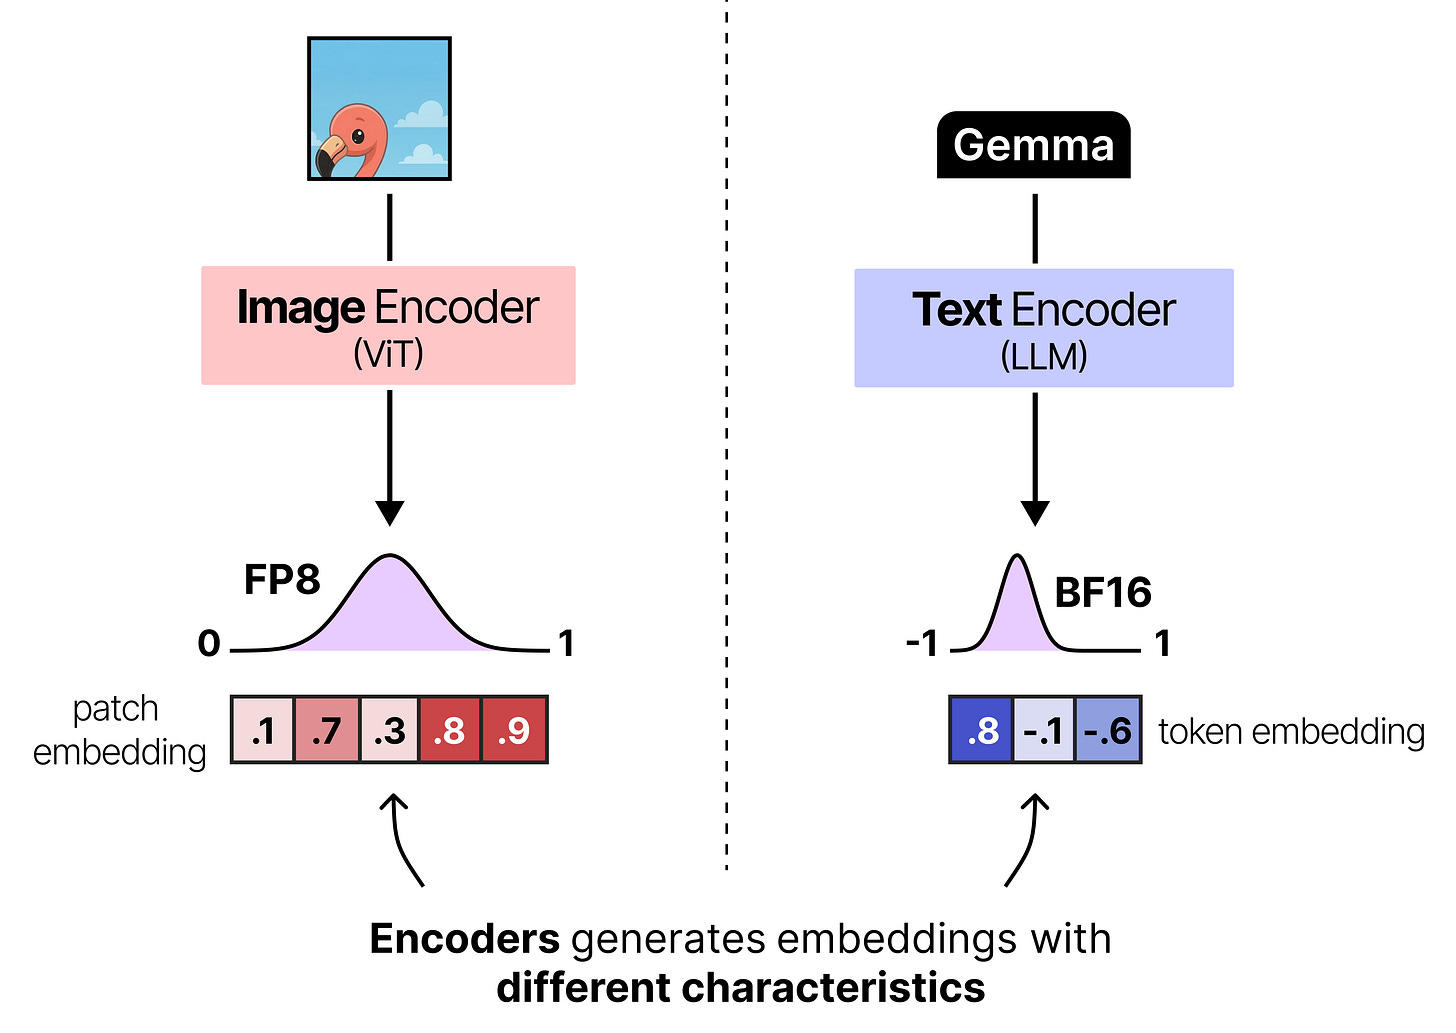
為了確保圖塊嵌入與詞元嵌入正確對齊,圖塊嵌入通常會用一個小型的神經網路做投影,讓它們具有與語言模型相同的維度與數值分佈。在 Gemma 4 中,這個投影之後會接一個 RMSNorm,以符合後續 Transformer 區塊的尺度期望。
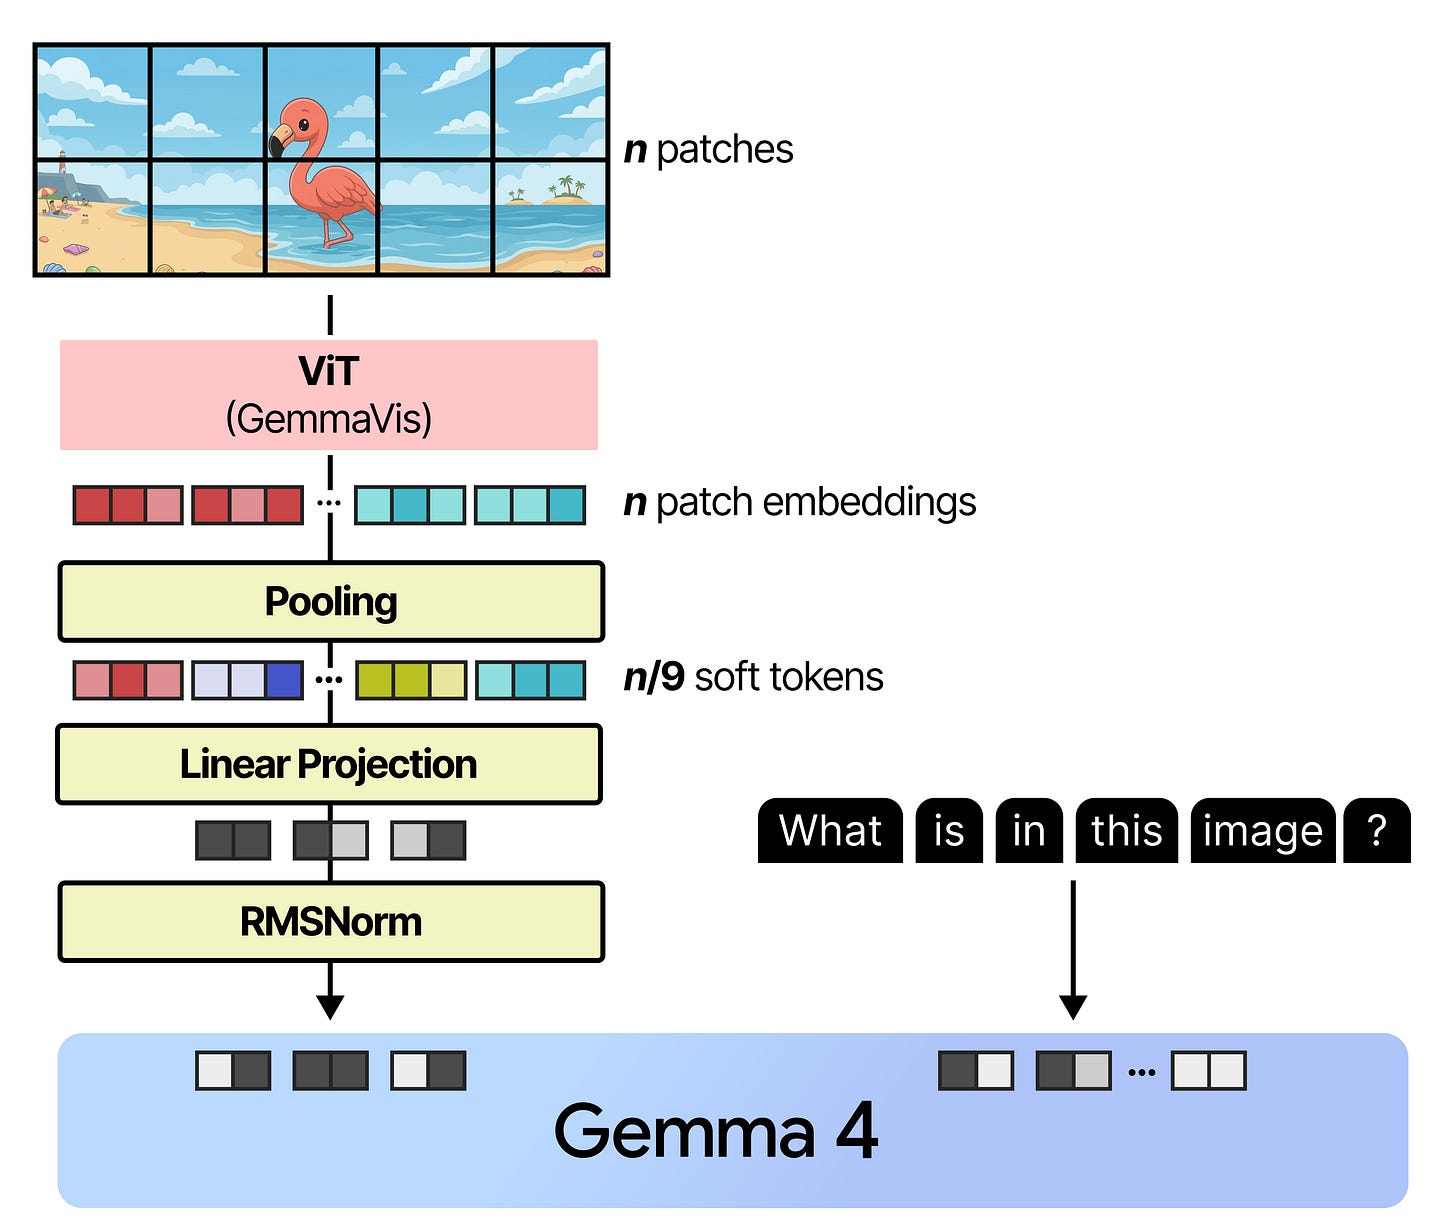
這就是 Gemma 4 處理圖像的方式!請注意,為了執行這個線性投影,它會與 Gemma 4 一起訓練,確保投影後的圖塊嵌入盡可能符合 Gemma 4 的期望。
此外,小模型(E2B 與 E4B)都使用 1.5 億參數的視覺編碼器,其他模型則使用 5.5 億參數的視覺編碼器。
整合在一起
把所有東西放在一起後,所有變體共通的 Gemma 4 架構可以總結為三大重點:
- 交錯配置的區域與全域注意力層
- 密集或混合專家,擇一
- 視覺編碼器
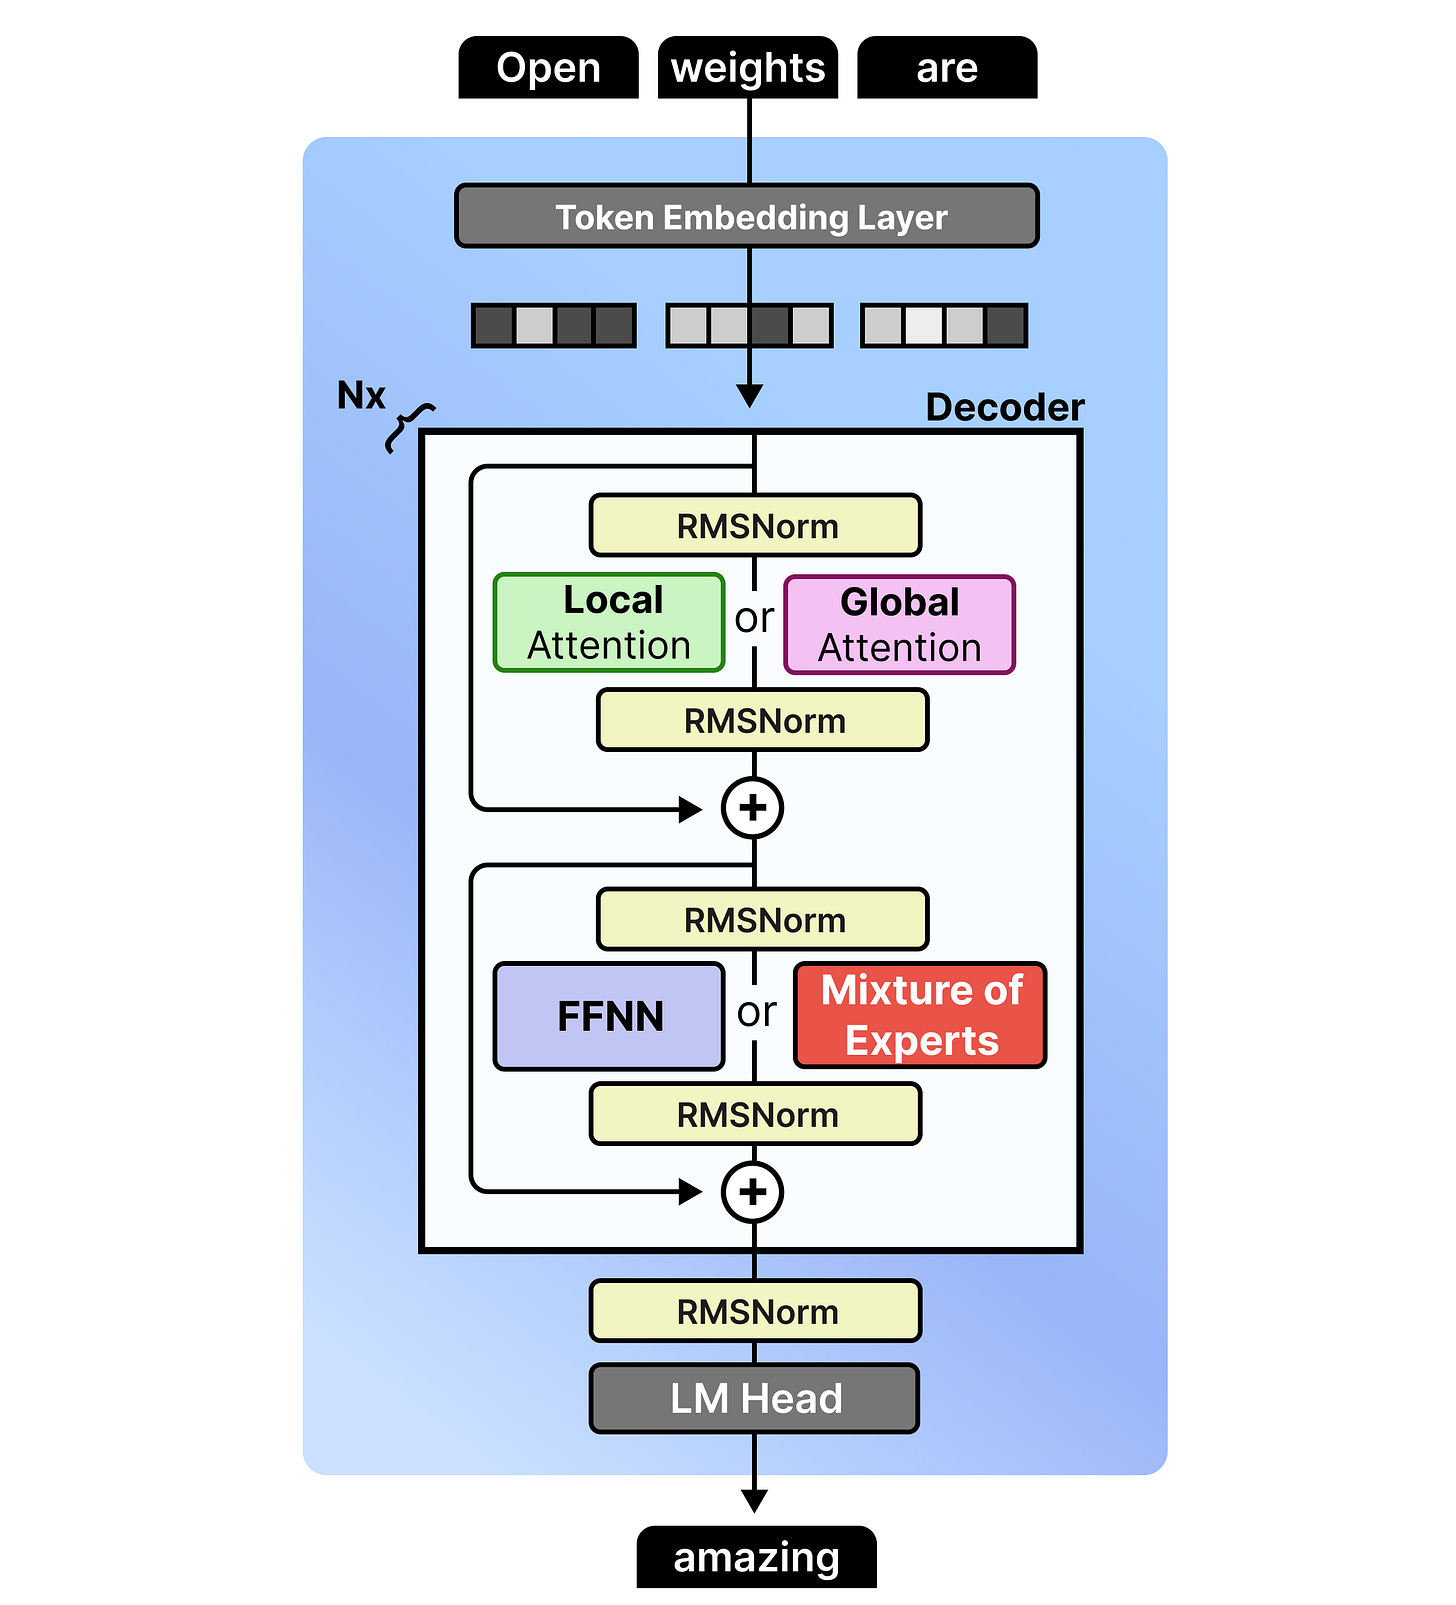
請注意,前饋神經網路(FFNN)並沒有與混合專家(MoE)交錯配置。任何 Gemma 4 變體的所有層都會使用其中之一,而不會混用。
現在我們已經介紹了每個變體的主要原則,接下來深入探索每組模型:
Gemma 4 - 31B - 密集
儘管混合專家廣受歡迎(稍後介紹),Gemma 4 系列有個相當大的密集變體,參數高達 31B。這個模型很好地代表了 Gemma 4 變體中比較「原汁原味」的架構。
這個模型在架構上與 Gemma 3 的對應模型(即 27B 變體)相當類似。它們都交錯配置區域與全域注意力,前後都有相同的 RMSNorm。不同的地方是我們前面討論過的方面,例如 K=V 與 P-RoPE。具體來說,Gemma 4 - 31B 的層數較少(60 層對 62 層),但模型更寬。
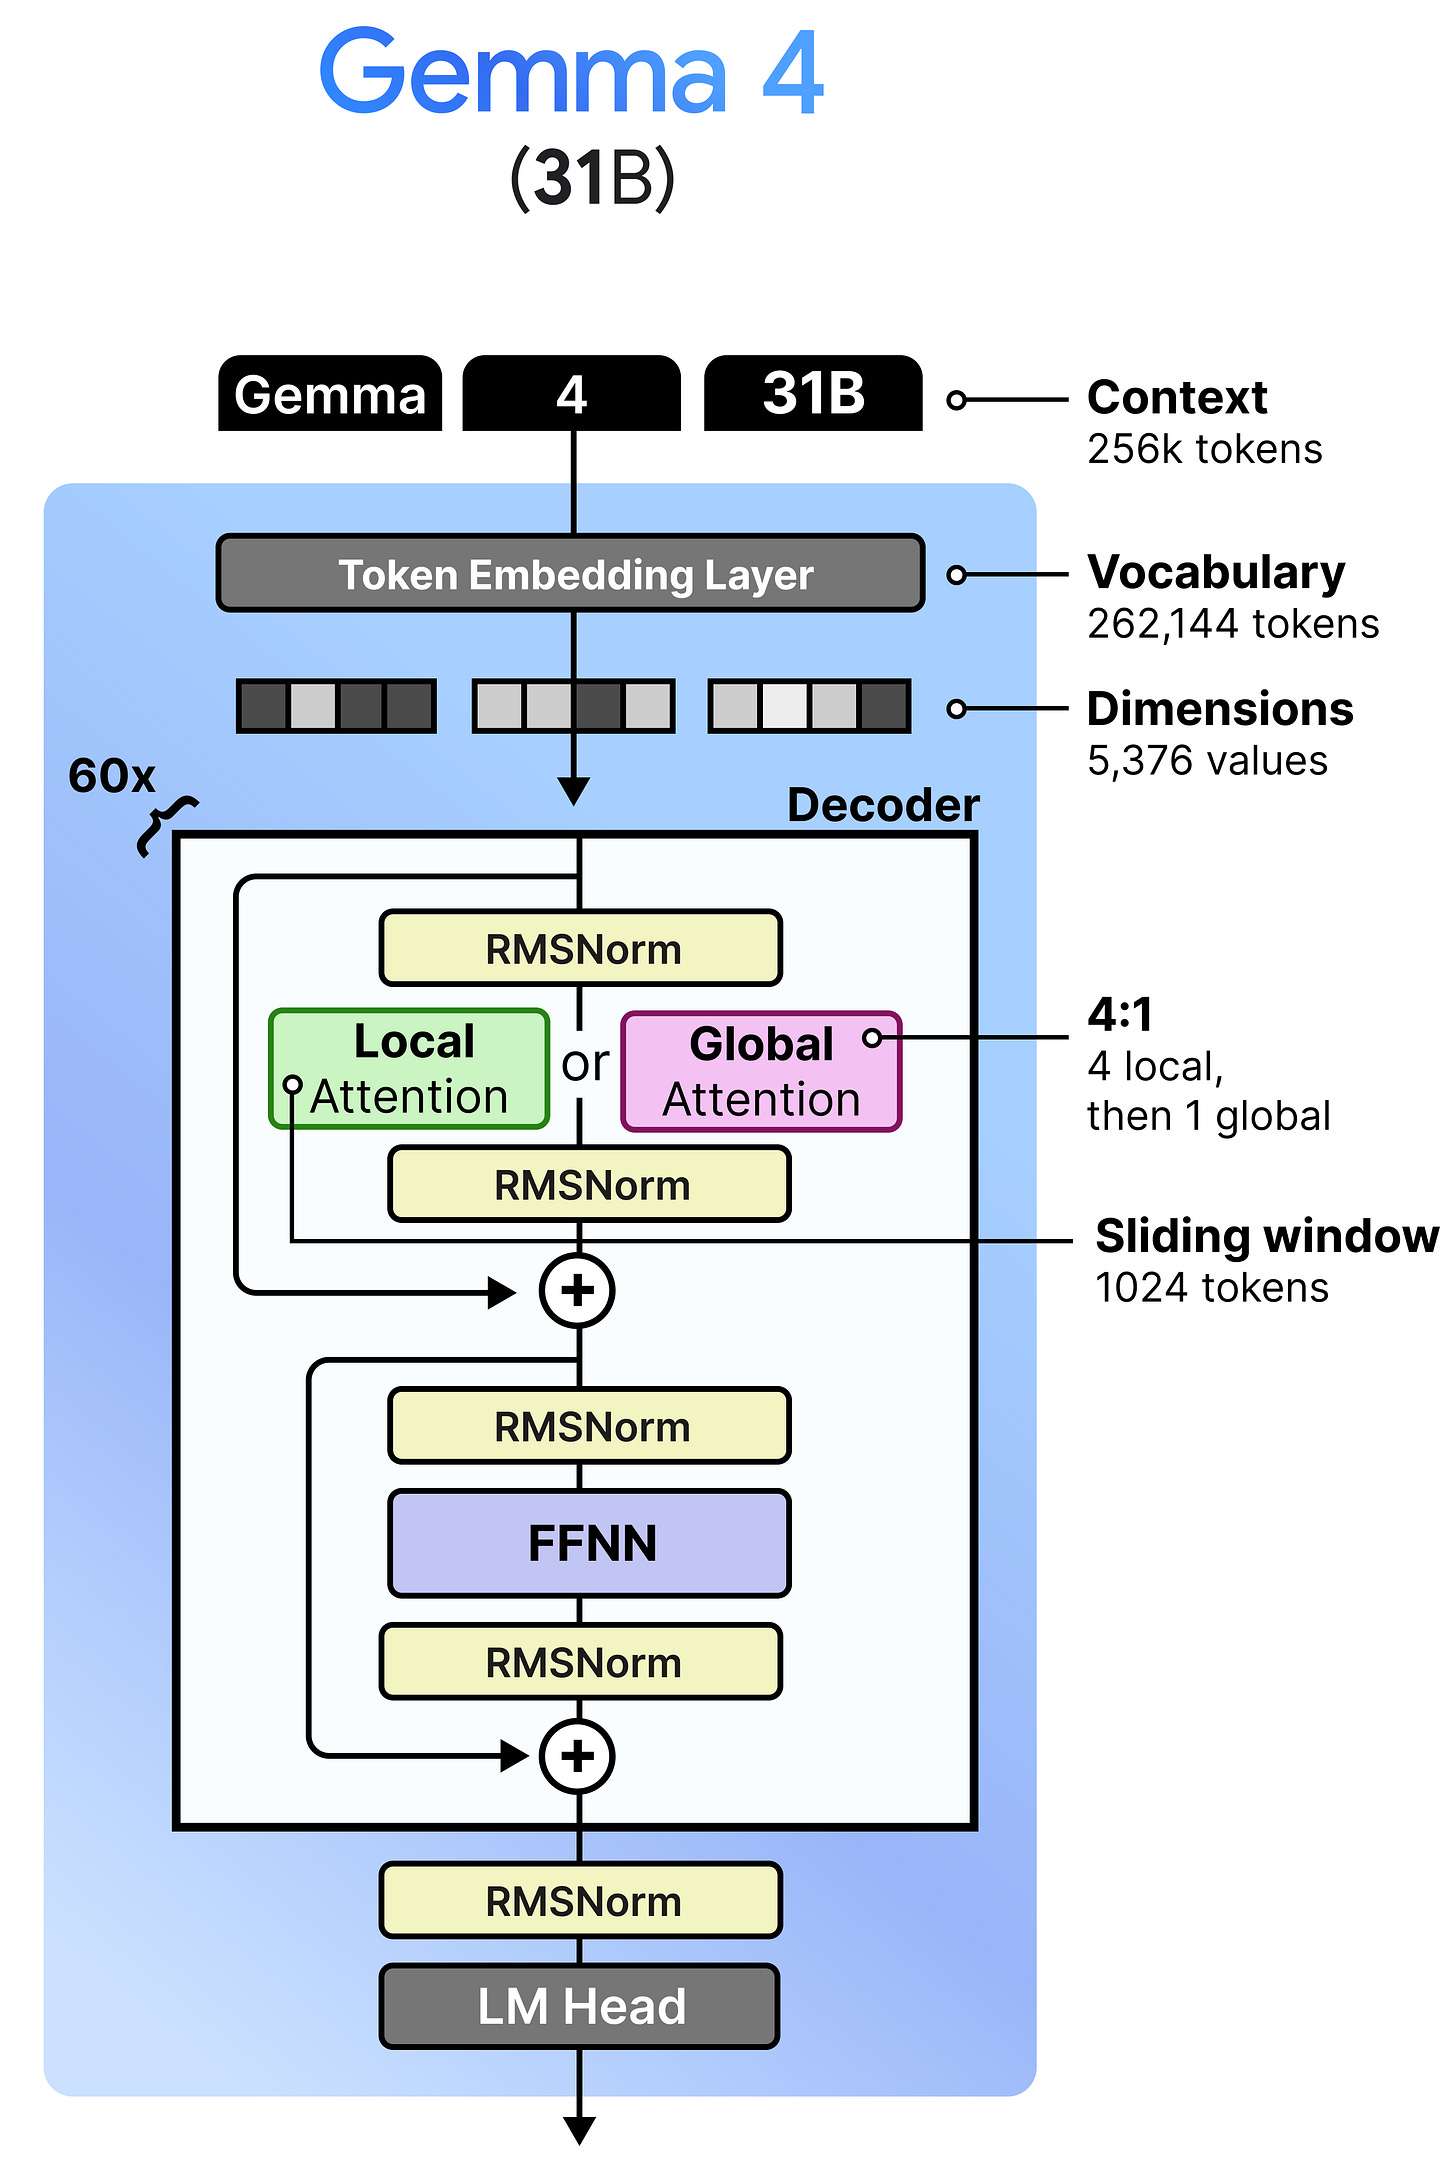
與混合專家模型和小型模型的逐層嵌入不同,這個變體沒有什麼「神奇成分」可以探索。我認為它是 Gemma 4 架構「原汁原味」的良好代表,讓我們可以在此基礎上探索其他模型。
Gemma 4 - 26B A4B - 混合專家
Gemma 4 有個名稱中含有「A」的變體,即 26 A4B 模型。「A」代表「啟用參數(active parameters)」,相對於它們包含的總參數數。具體來說,26B A4B 模型總共有 260 億參數(全部載入記憶體),但推論時只使用 40 億參數,這些稱為「啟用參數」。因為只啟用一部分參數,這些模型的運行速度遠快於其總參數數所暗示的。
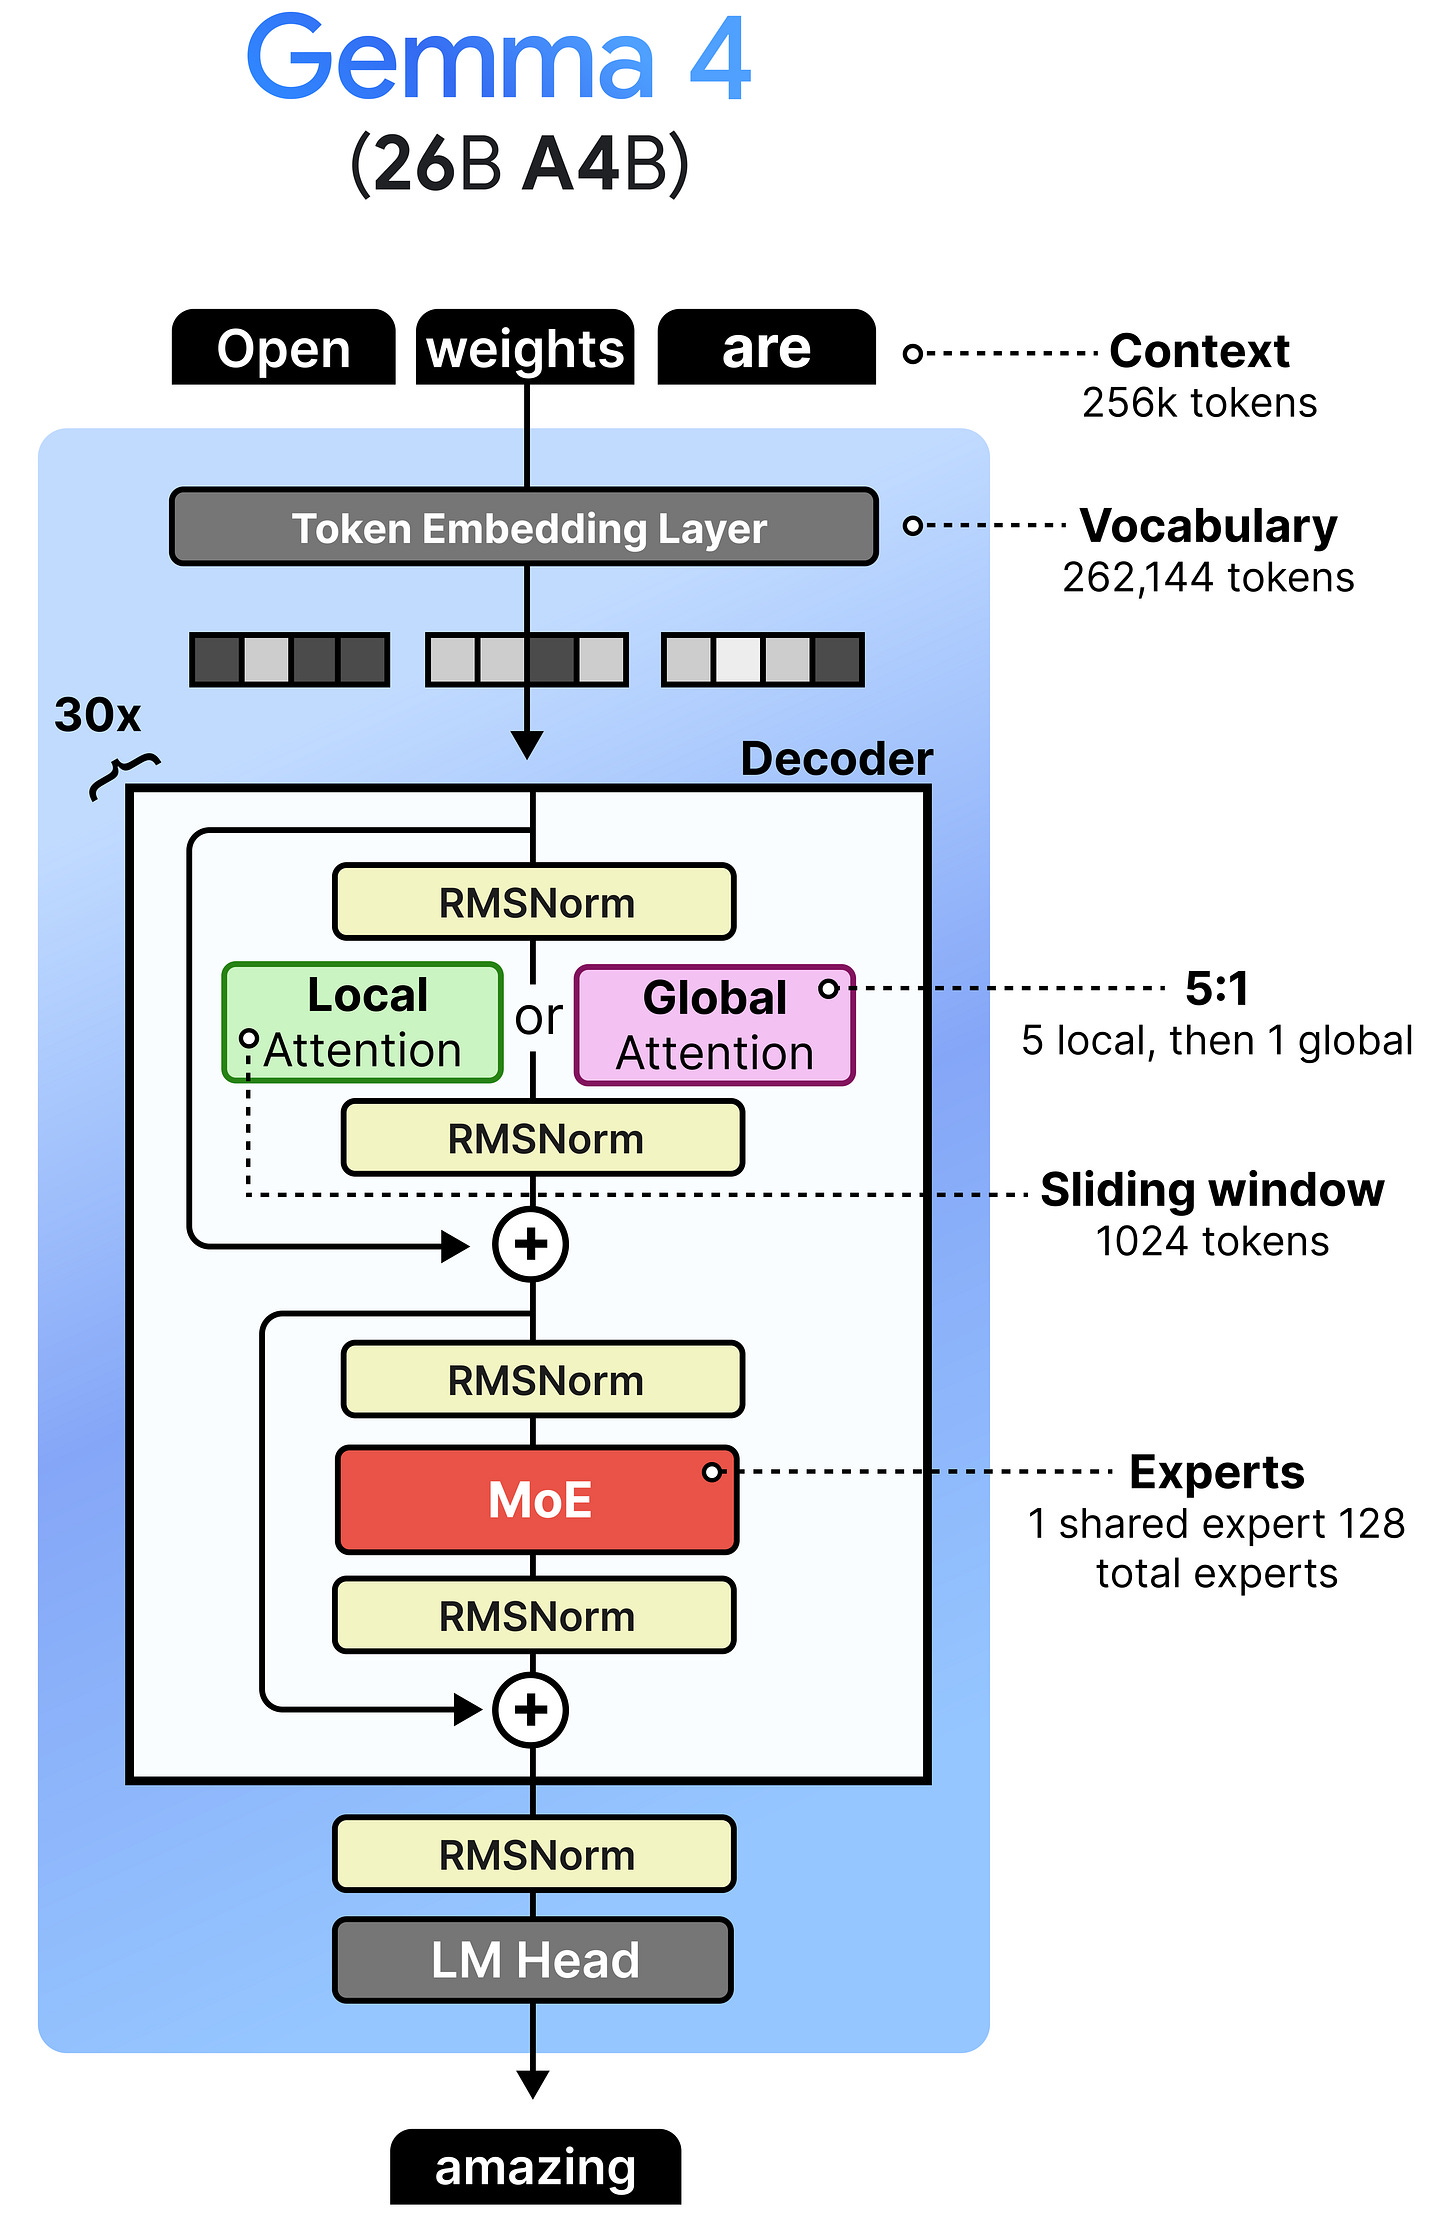
實現這一點的架構稱為混合專家(MoE)。它不用一個巨大的前饋神經網路(FFNN),而是使用多個較小的,並動態選擇用哪些來處理給定的輸入。
因此,MoE 有兩個主要元件:
- 專家(Experts) — 一組能處理詞元的 FFNN,但一次只啟用其中一部分。它們通常比密集(「常規」)模型中的 FFNN 小。
- 路由器(Router) — 決定哪些詞元由哪些專家處理。
給定的詞元嵌入在 MoE 層中,會先傳給路由器,由路由器選擇啟用一個或多個專家。為此,會產生專家機率,用於路由詞元嵌入。選定的專家會像一般的前饋神經網路一樣更新詞元嵌入。
這些機率讓某些專家對處理後的嵌入的影響力大於其他專家。因此,處理後的嵌入會乘以專家機率。
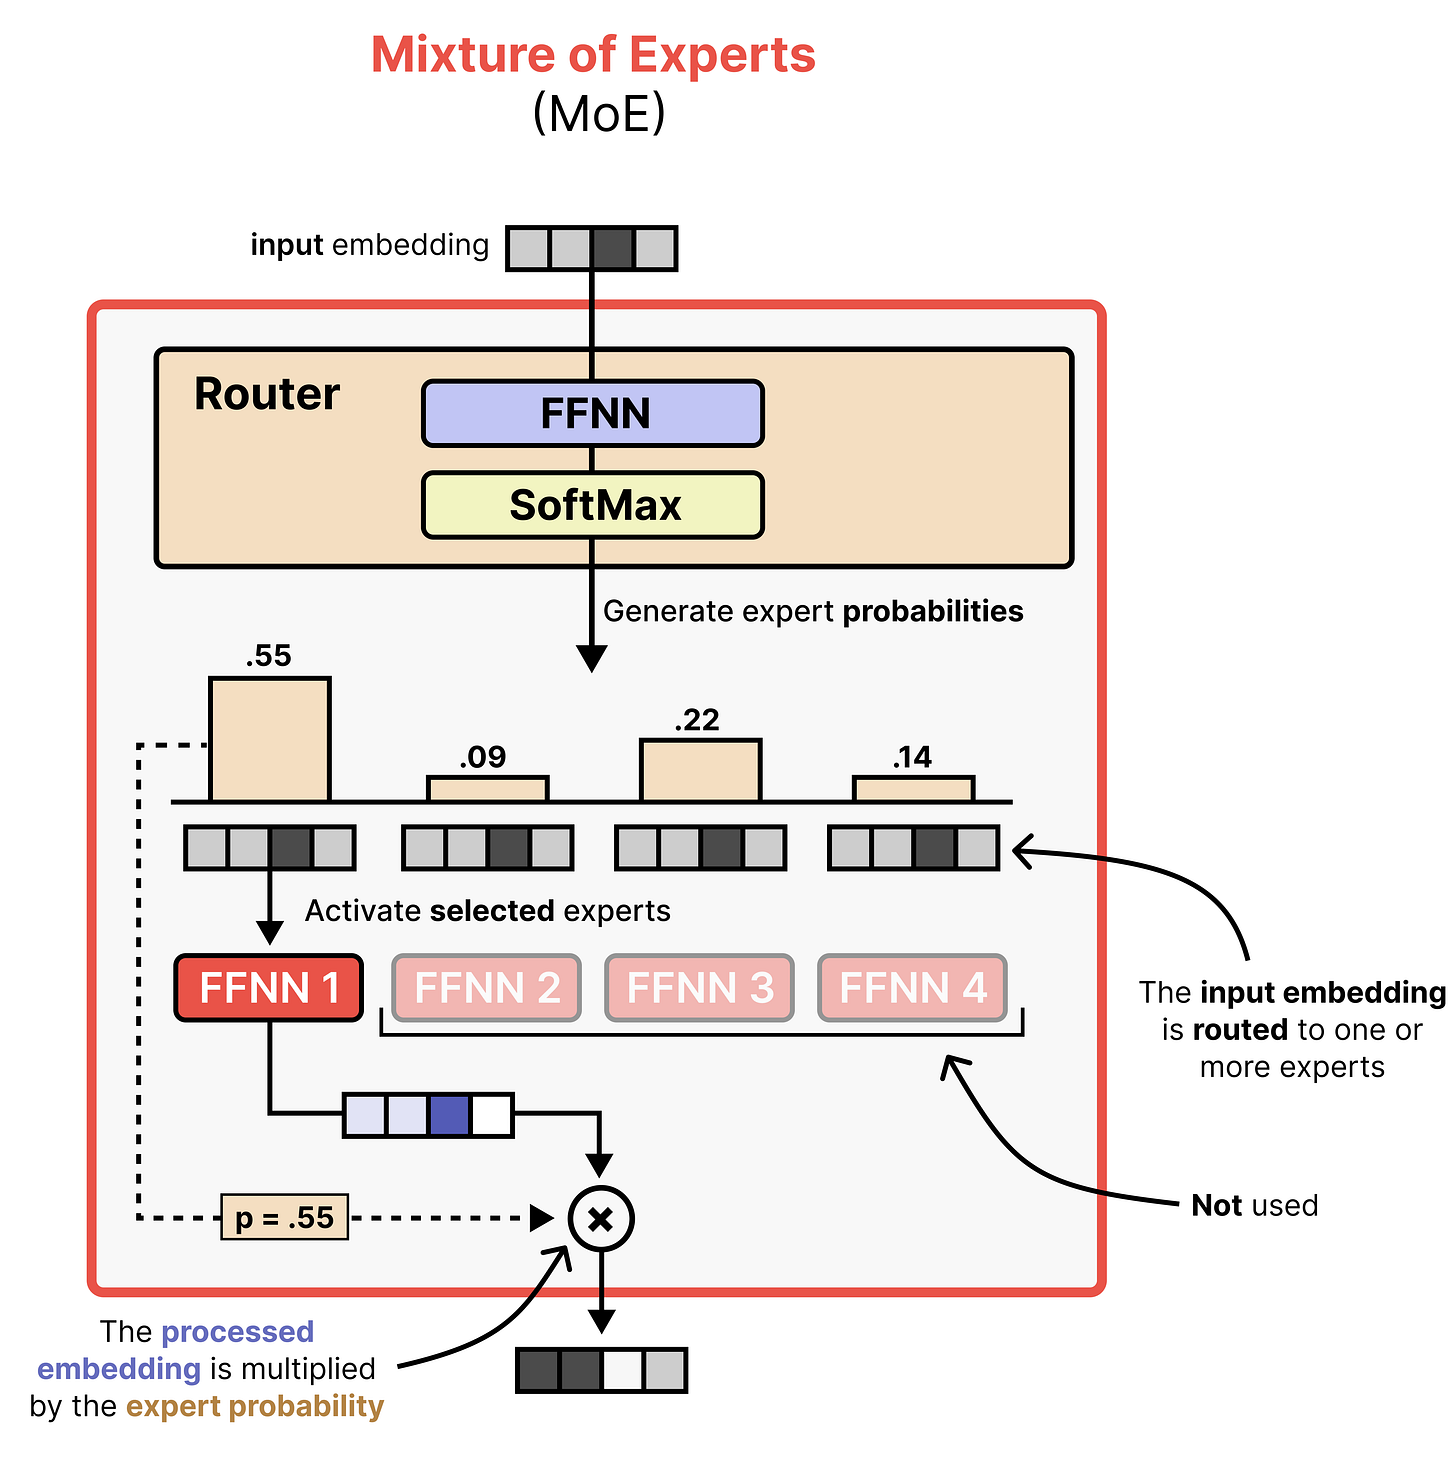
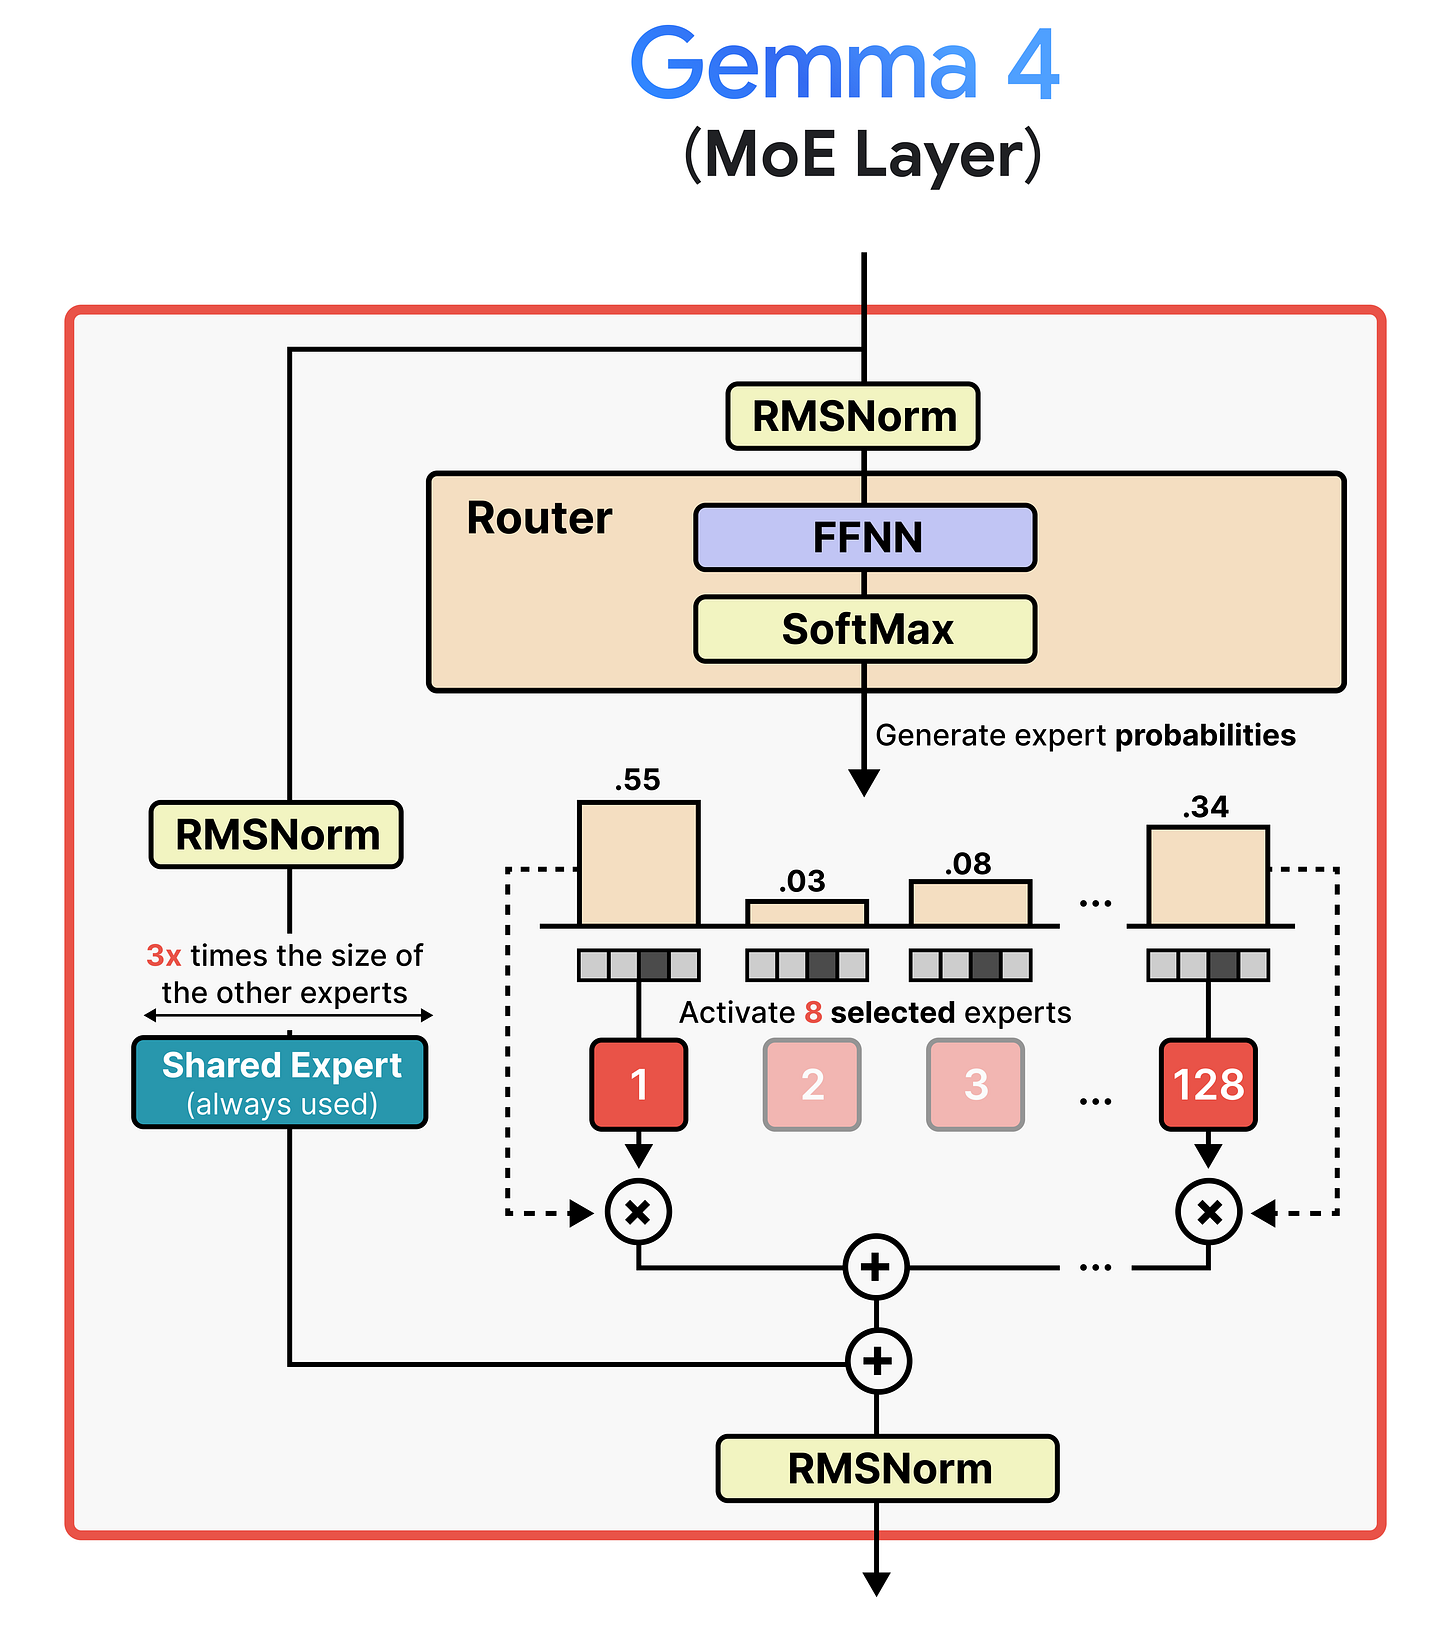
雖然圖中只顯示了一個專家,但大多數 MoE 會啟用多個並合併結果。在 Gemma 4 中,MoE 變體有 128 個專家可供路由器選擇,每次會啟用 8 個。
此外,還有一個共享專家。這個專家永遠會被啟用並用於處理輸入嵌入。設置共享專家的基本想法是,它包含大量應該永遠啟用的通用知識,而選定的專家則包含更細緻的知識。在 Gemma 4 中,這個共享專家是一般專家的三倍大,以確保涵蓋必要的通用知識。
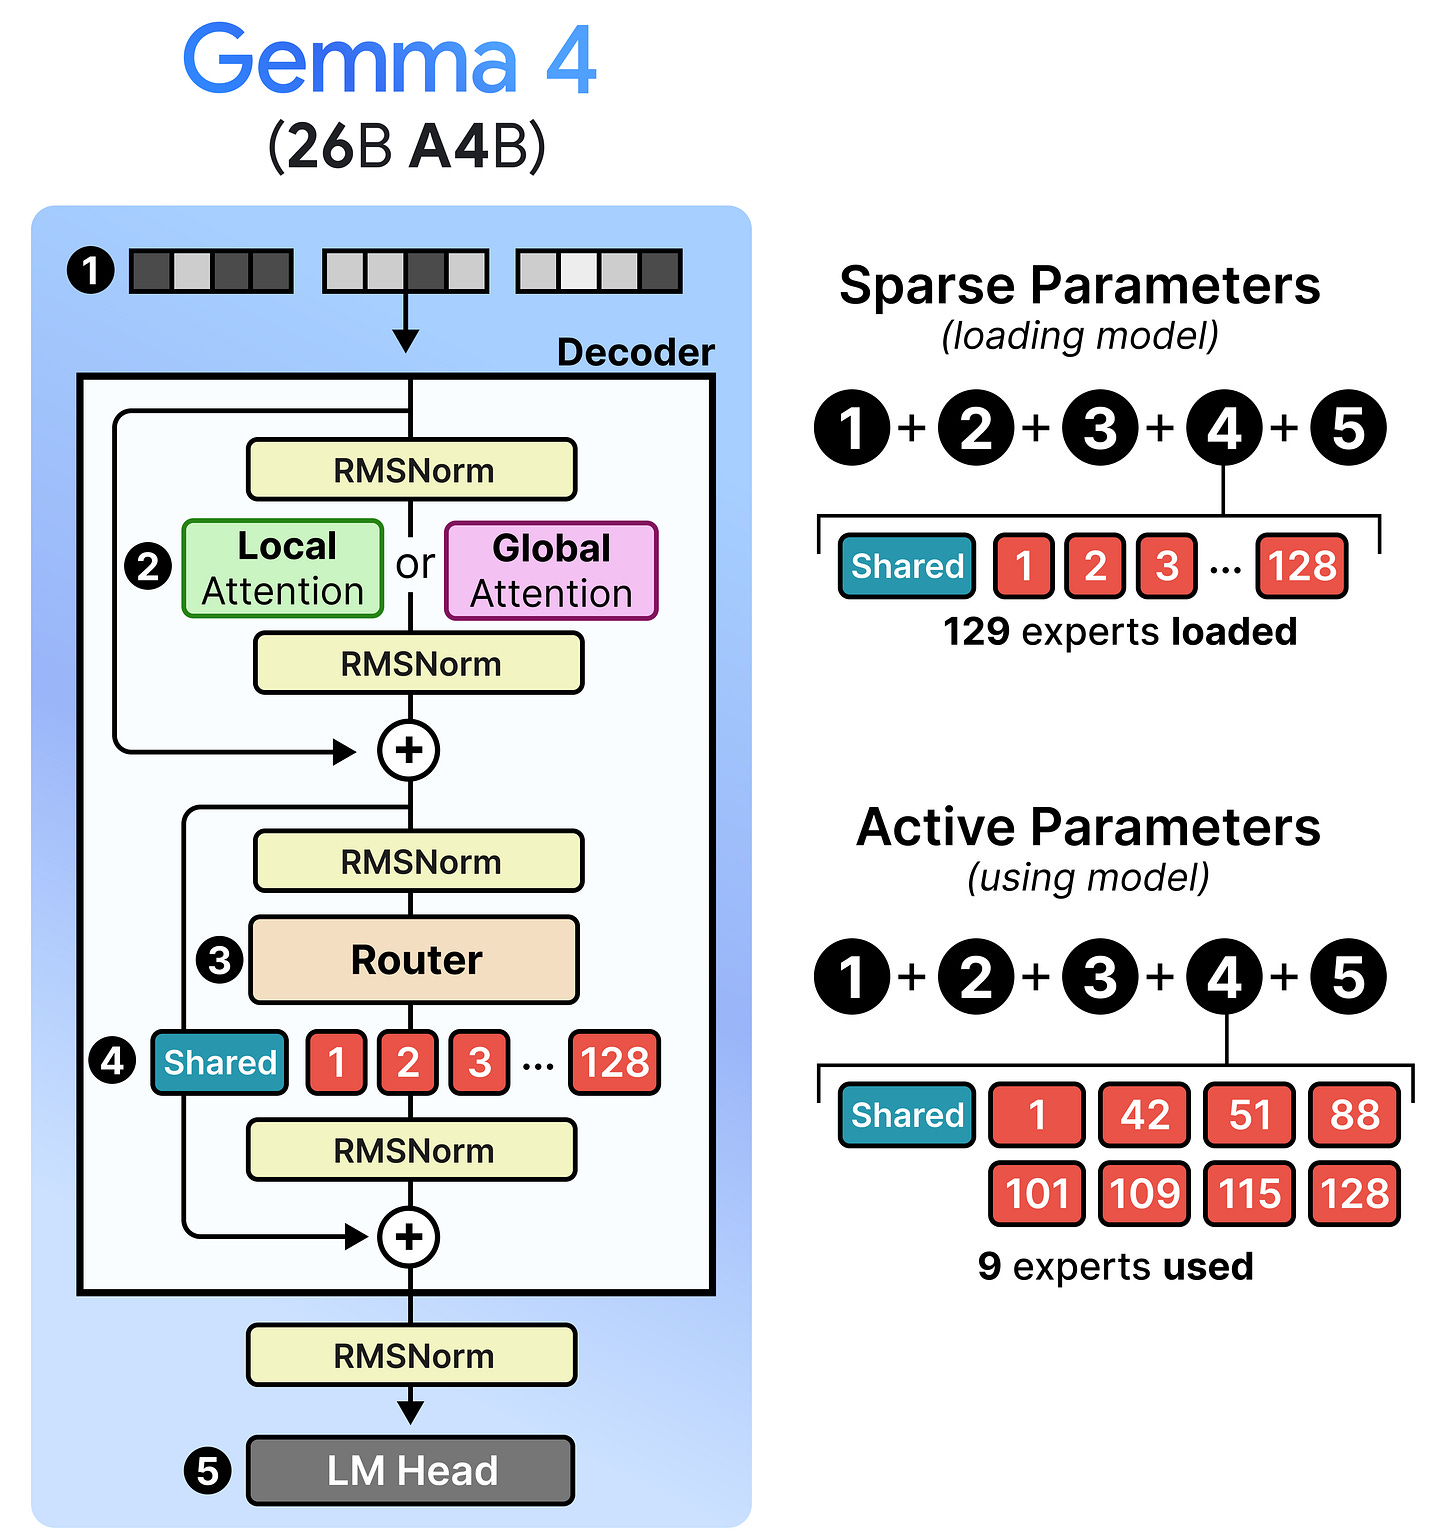
現在你對 Gemma 4 的混合專家有了整體概念,讓我們更深入地探討稀疏參數與啟用參數對高效架構的意義。稀疏參數是模型的所有參數,當你要載入模型時都需要載入記憶體。例如 Gemma 4 的 260 億參數模型相當大,你可能會以為它跑得很慢。然而,當你運行模型時,並不是所有的稀疏參數都會被你的裝置(如 GPU)實際使用。在 Gemma 4 的混合專家中,只有 8 個專家與 1 個共享專家會實際用於中間計算,其他 119 個專家可以先休息。這些就是啟用參數,代表「26B A4B」中的「A」。這意味著雖然這個模型很大,但運行速度幾乎跟 40 億參數的模型一樣快!
我試用這個模型時玩得很開心,可以告訴你它運行起來相當流暢。不過,如果你想在手機這類裝置上運行,可能還是想用更小的模型。
Gemma 4 - E2B 與 E4B - 密集
Gemma 4 有個名稱中含有「E」的變體,即 E2B 與 E4B 模型。「E」代表「有效參數(effective parameters)」,相對於它們包含的總參數數。
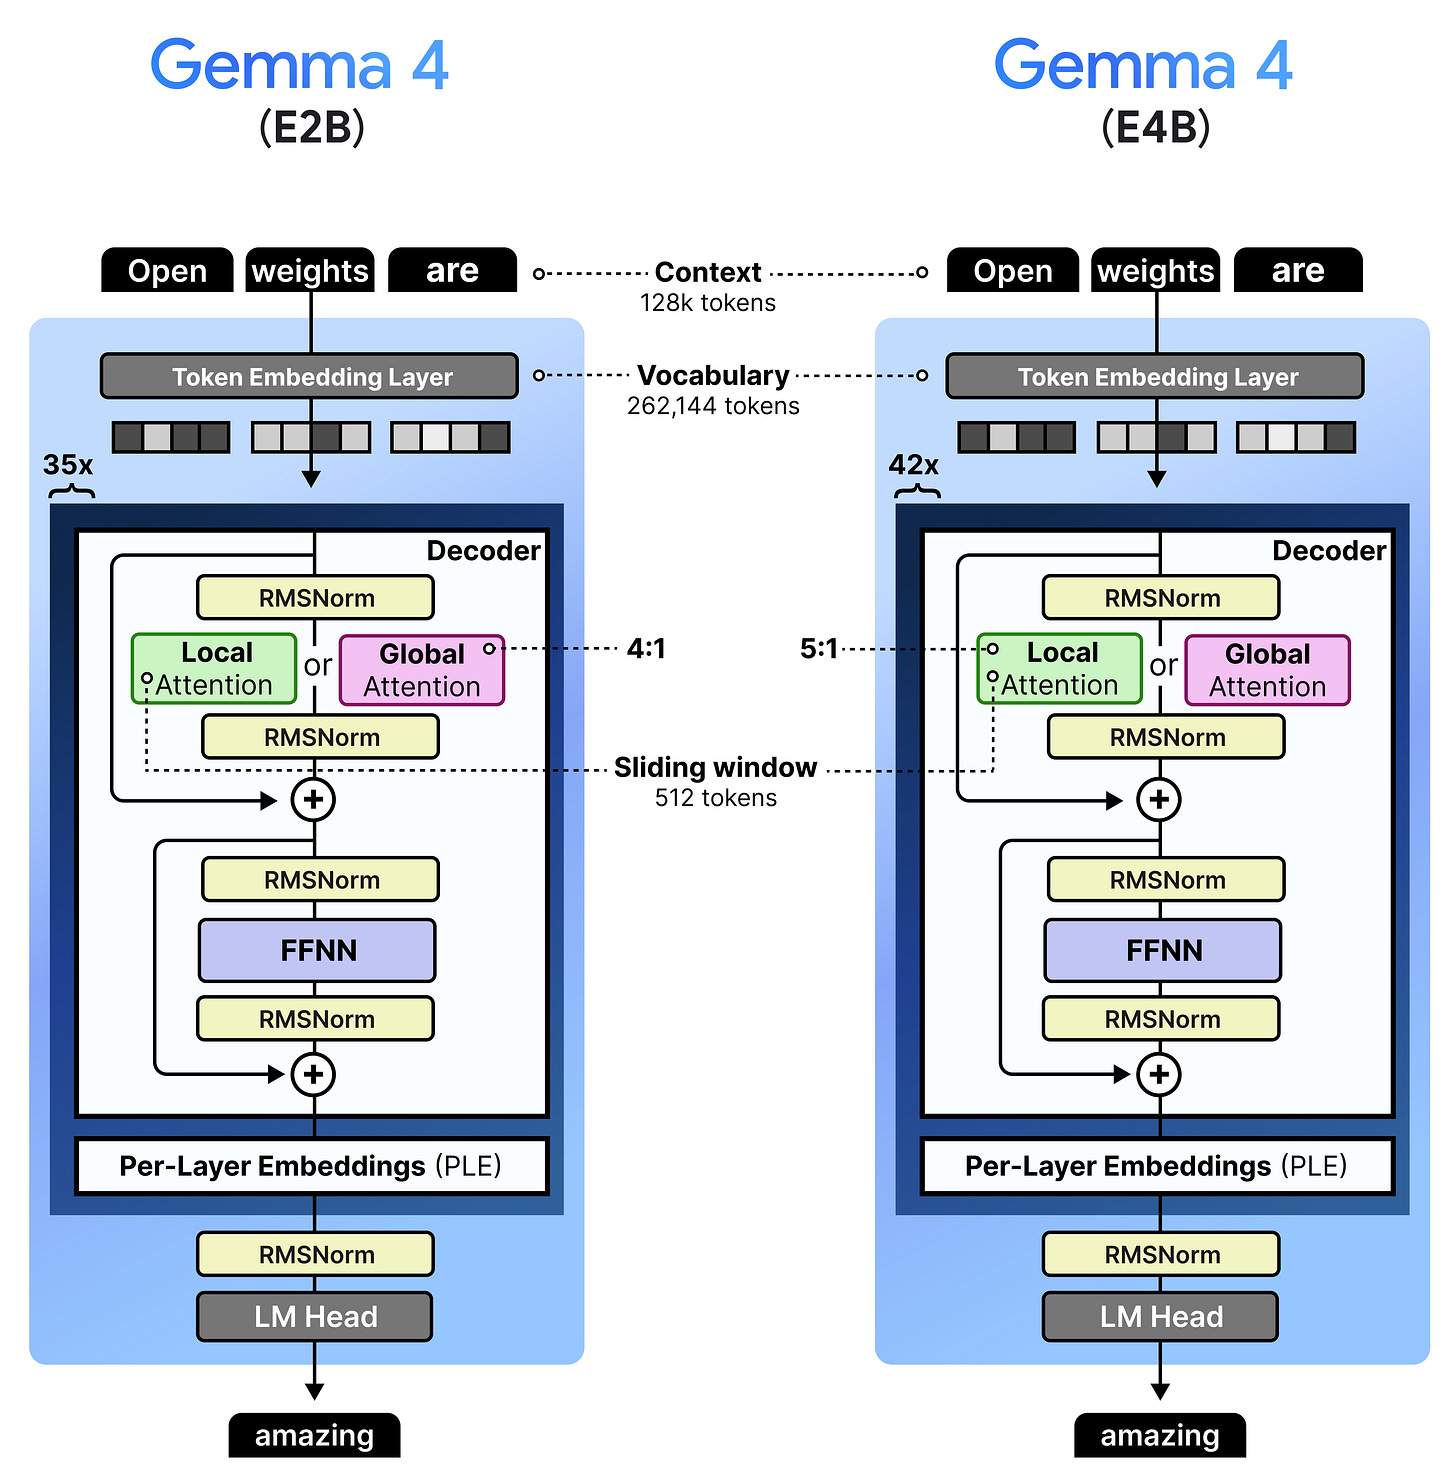
這些模型非常高效,非常適合裝置端的使用場景。這些模型特別令人興奮的地方是,它們還包含了一個額外的音訊編碼器,可以與文字和圖像一起處理音訊。
在深入介紹音訊編碼器的細節之前,我們先來探討這個「E」!
逐層嵌入
小尺寸 Gemma 4 模型中一個有趣的元件,是「E2B」與「E4B」中的「E」。它代表「有效」,在某種程度上類似於我們在混合專家探討過的稀疏參數與啟用參數。「有效」基本上表示這些參數用於計算並載入到你的(V)RAM,而其他參數(儲存嵌入的查找表)只用一次,用於快速找到相關的嵌入。
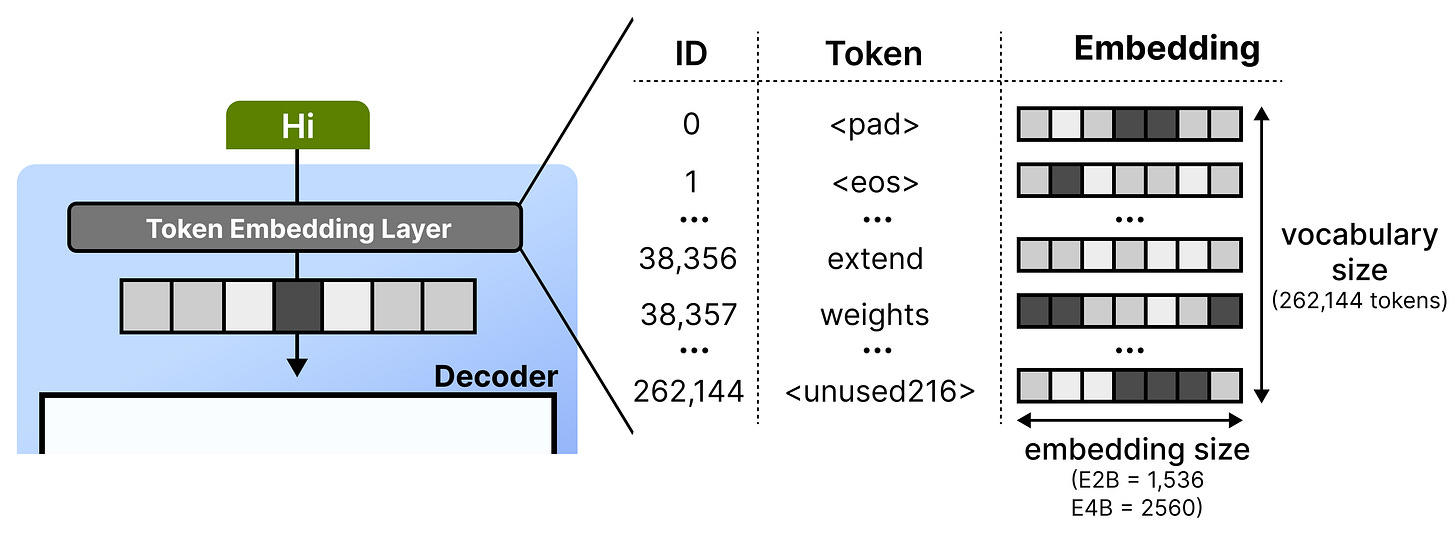
為了探索這在實際上的意義,我們先來介紹詞元嵌入層發生的事。每當收到一個詞元,它會用查找表查到它的嵌入。這個表可能很大,因為必須為詞彙表中每個詞儲存一個嵌入。例如 Gemma 4 E2B 有 262,144 個詞元,每個嵌入的維度是 1536。
然後,每個詞元的嵌入會經過堆疊的解碼器區塊,逐層被處理。要提升模型的能力,通常就是多加幾層或更多參數。更大的模型通常表現更好。
有一個聰明的技巧:不在模型本身加參數,而是在每一層都創建一組額外的嵌入。簡化來說,想像「cat」這個詞元的嵌入可能在各層強調:
- 第 2 層 - 「我是名詞,通常後面接動詞。」
- 第 18 層 - 「我是小型動物,與『寵物』或『貓科動物』等詞相關。」
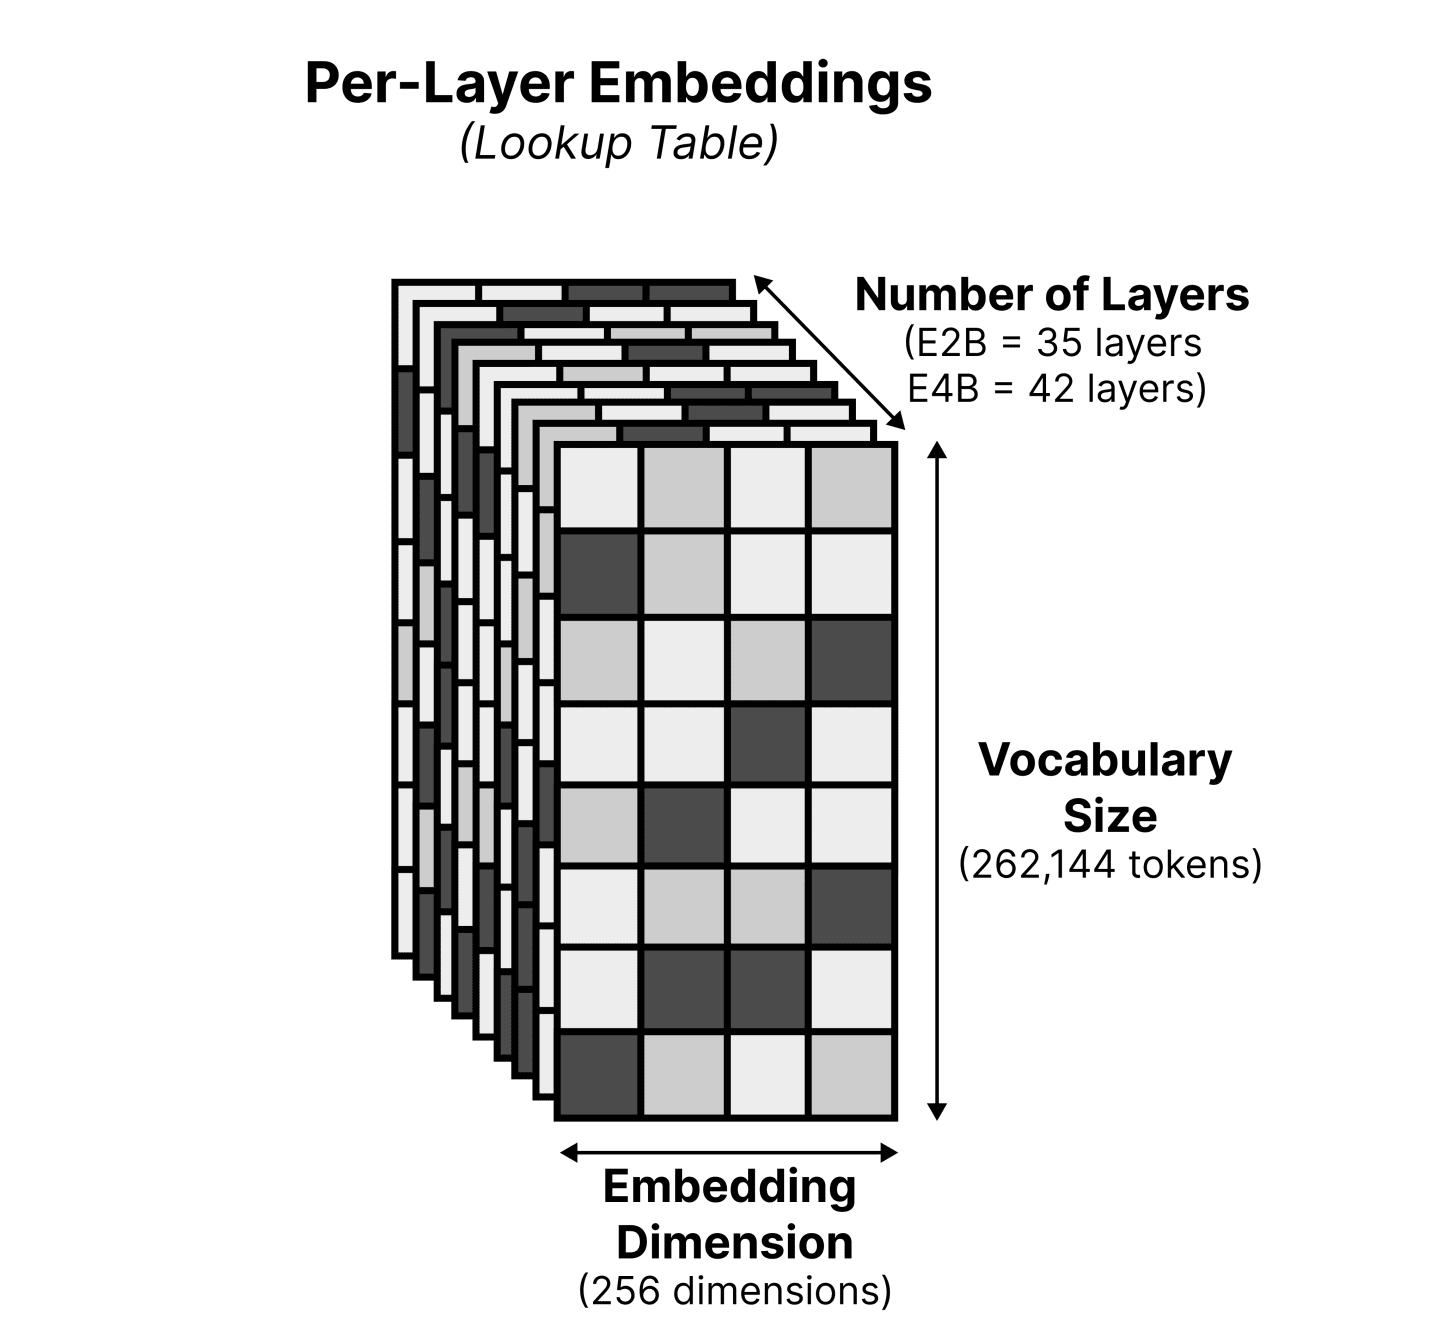
這些嵌入比原始查找表小得多(E2B 是 256 維對 1536 維,E4B 是 2056 維)以節省儲存空間。因此,我們現在有一個 262,144 個詞元 x 256 維 x N 層的查找表。擁有更大的查找表的好處是,可以把重要資訊存在快閃儲存中,而不需要佔用寶貴的(V)RAM——那是模型做計算用的。
這些稱為逐層嵌入(PLE),顧名思義,就是用於特定層的嵌入。
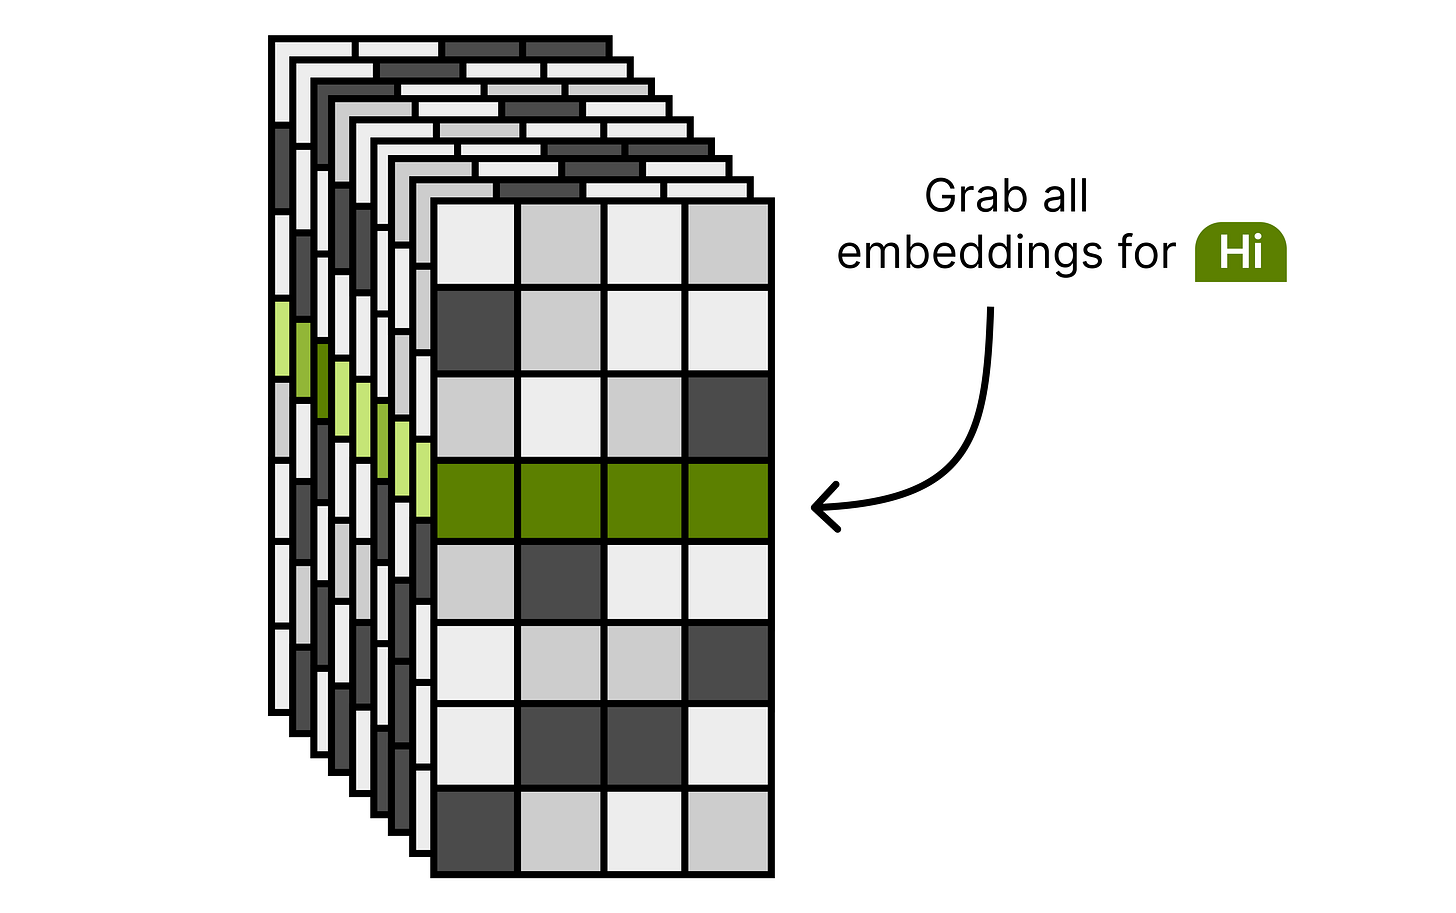
在推論開始時,模型會為每個輸入詞元抓取一組嵌入。每個輸入詞元都會有該層要用的每層嵌入。請注意,這個查找在推論中只做一次,所以這個動作相當節省計算,因為不需要在每次啟用層時都去查找嵌入。
這些嵌入在每組解碼器區塊之間被處理。在這裡,會使用一個門控函數來決定如何加權所選嵌入中的每個值。這讓模型能進一步關注從查找表中取出的嵌入的某些部分。得到的嵌入(維度仍是 256)接著被投影上去,以符合原始嵌入的尺寸(E2B 是 1,536,E4B 是 2,560)。
經過一個正規化層後,這個加權表示會與前一個解碼器區塊的原始輸出結合。這讓處理後的訊號能被「提醒」詞元嵌入代表什麼,而不是被混過一堆層、加了一大堆上下文之後失去原貌。
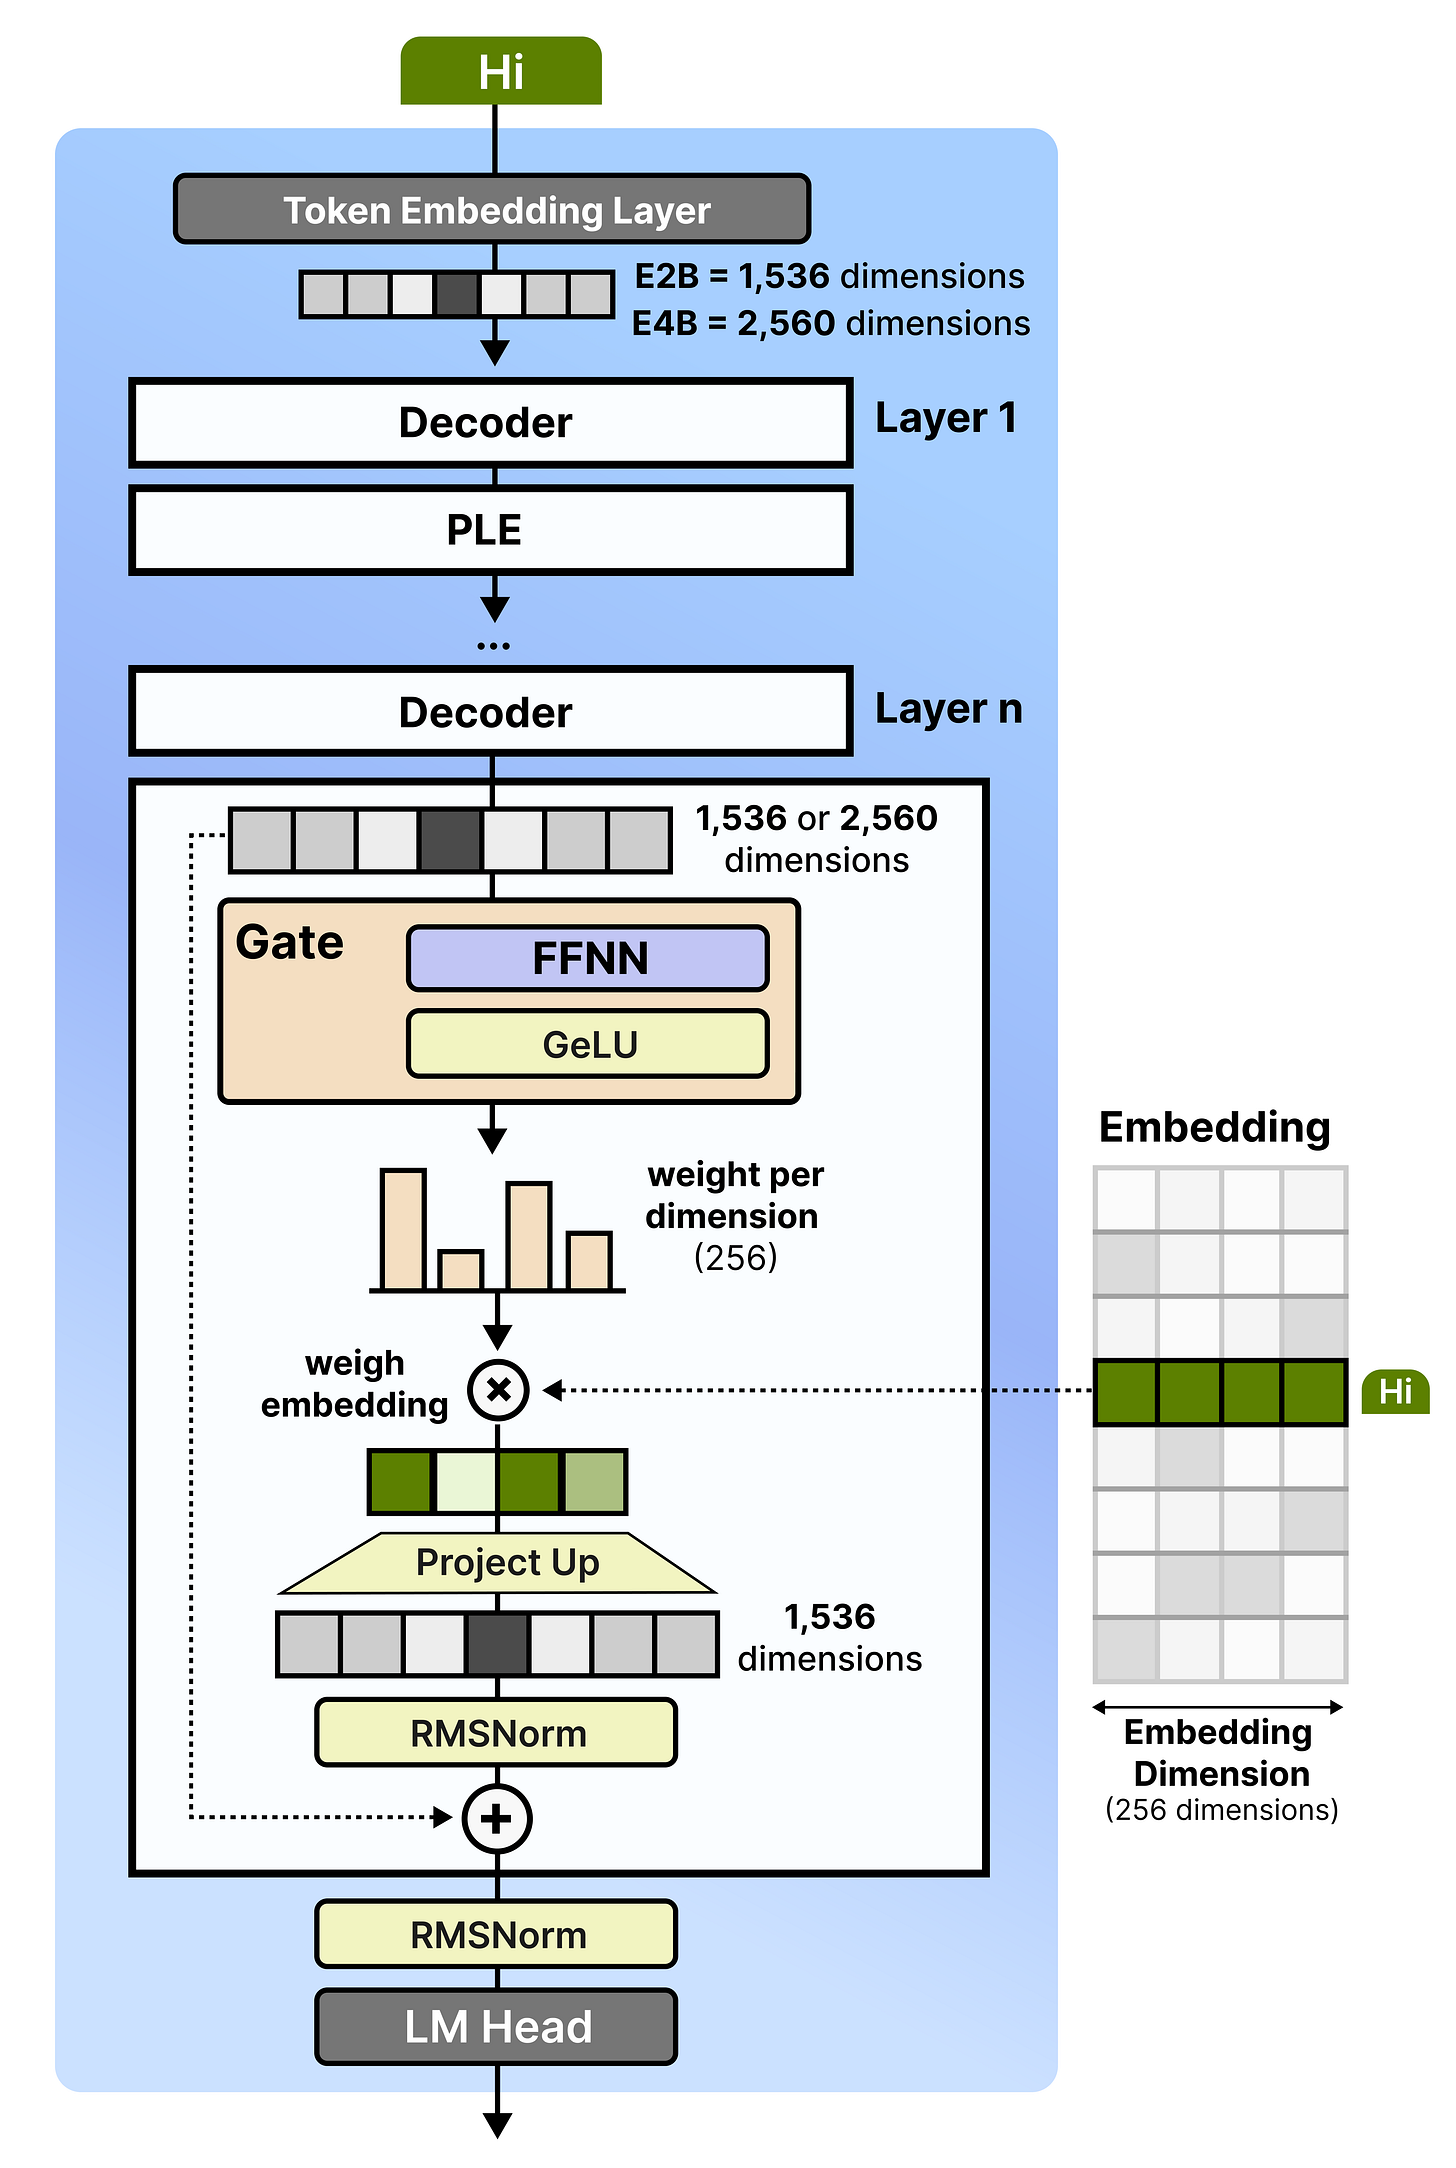
模型現在可以把內部維度專注在理解詞元,而不是需要一路攜帶底層的資訊。這讓現有的層比單靠自己更有效率、更有表現力。
但更重要的是,這些逐層嵌入雖然相當大(262,144 x 35 x 256),卻存在快閃記憶體中。如果存在(V)RAM 裡會很浪費,因為推論時只需要用到少數幾個嵌入。因此,「E2B」與「E4B」中的「E」指的是除了逐層嵌入之外的所有參數。
這是一個優雅的技術,讓這些模型可以在手機等較小的裝置上運行。在那裡,RAM 非常寶貴且有限,所以任何能減少 RAM 使用的方法都很受歡迎。
音訊編碼器
小模型(E2B 與 E4B)也可以處理音訊輸入,非常適合自動語音辨識與翻譯等任務。就像視覺編碼器一樣,音訊編碼器把原始音訊輸入轉換成 Gemma 4 可以處理的嵌入。
這個過程有幾個步驟,我們從頭開始。把原始音訊轉換成詞元及其嵌入的常見過程有三個步驟:
- 特徵提取 – 透過梅爾頻譜圖從原始音訊中提取特徵,梅爾頻譜圖是原始音訊的二維視覺表示,橫軸是時間,縱軸是頻率帶。
- 分塊 – 把梅爾特徵分成區塊,作為詞元序列的起點。
- 區塊降採樣 - 區塊被重疊並經過兩個二維卷積層處理,以縮短序列長度。這樣就把二維區塊轉換成嵌入序列(也稱為「軟」詞元,代表詞元的連續性質)。
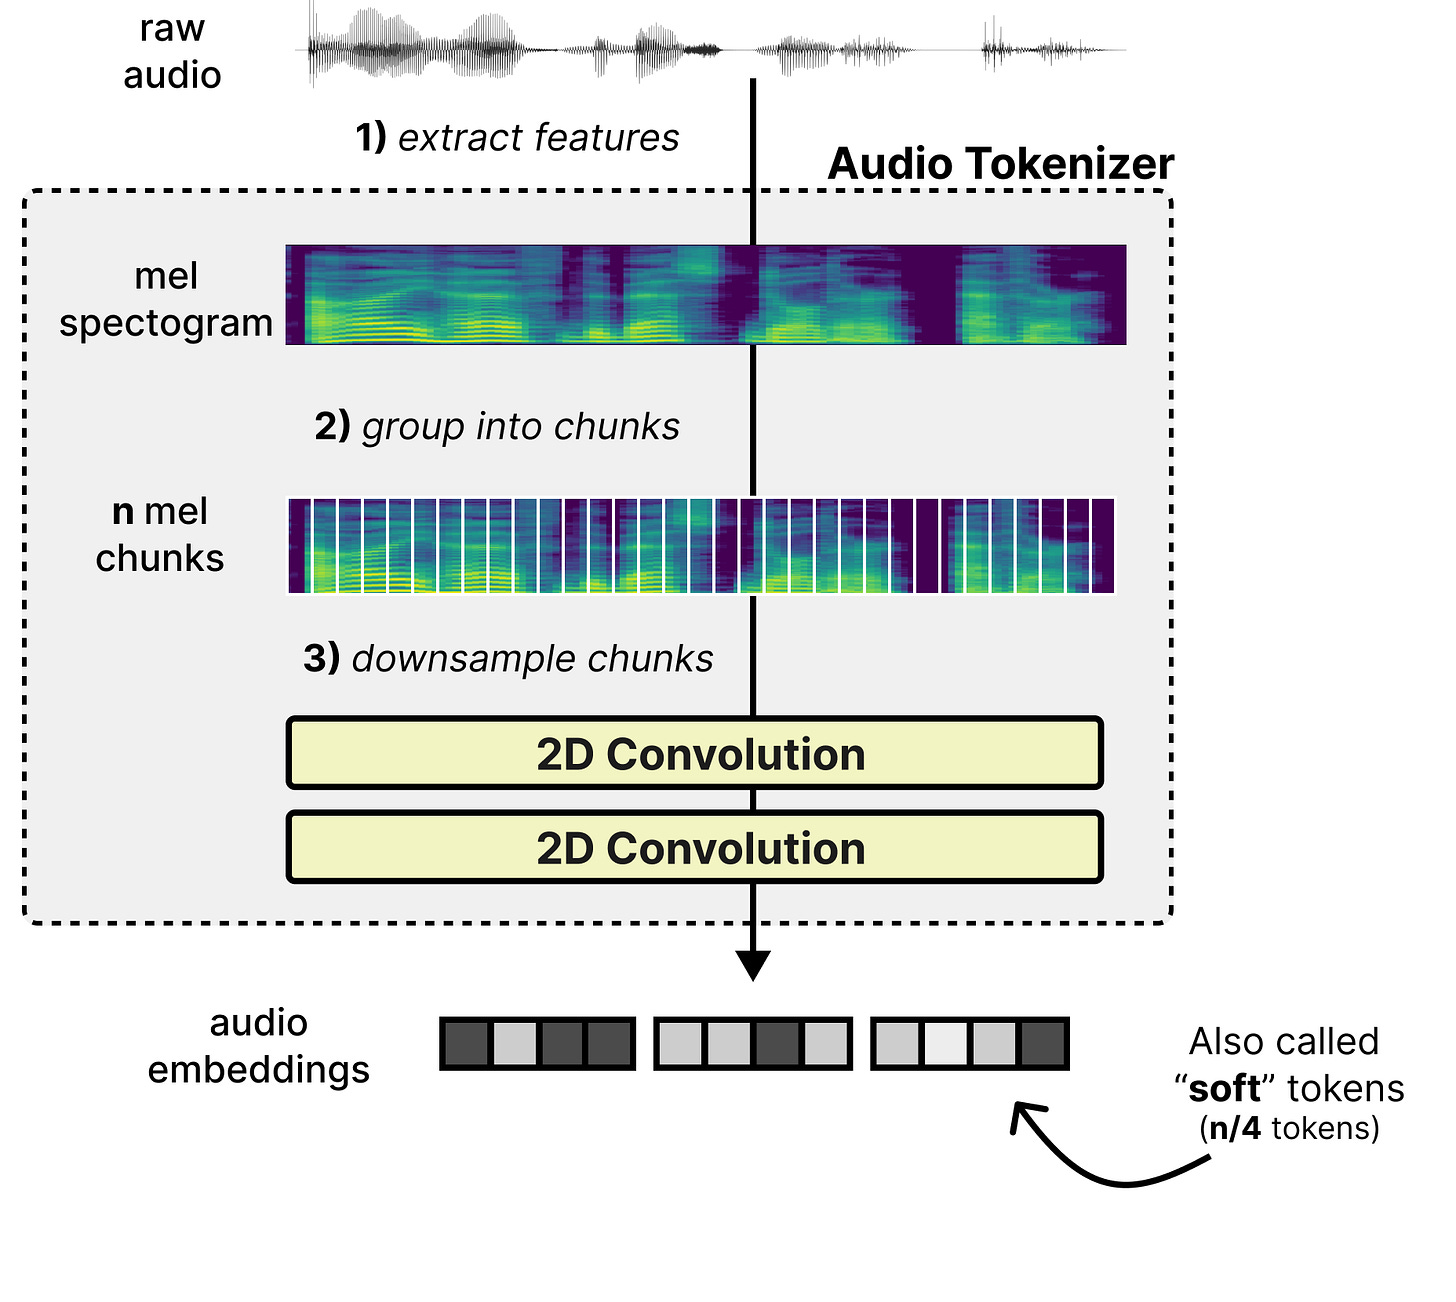 小知識:我自己錄了音,並為這張圖製作了梅爾頻譜圖!
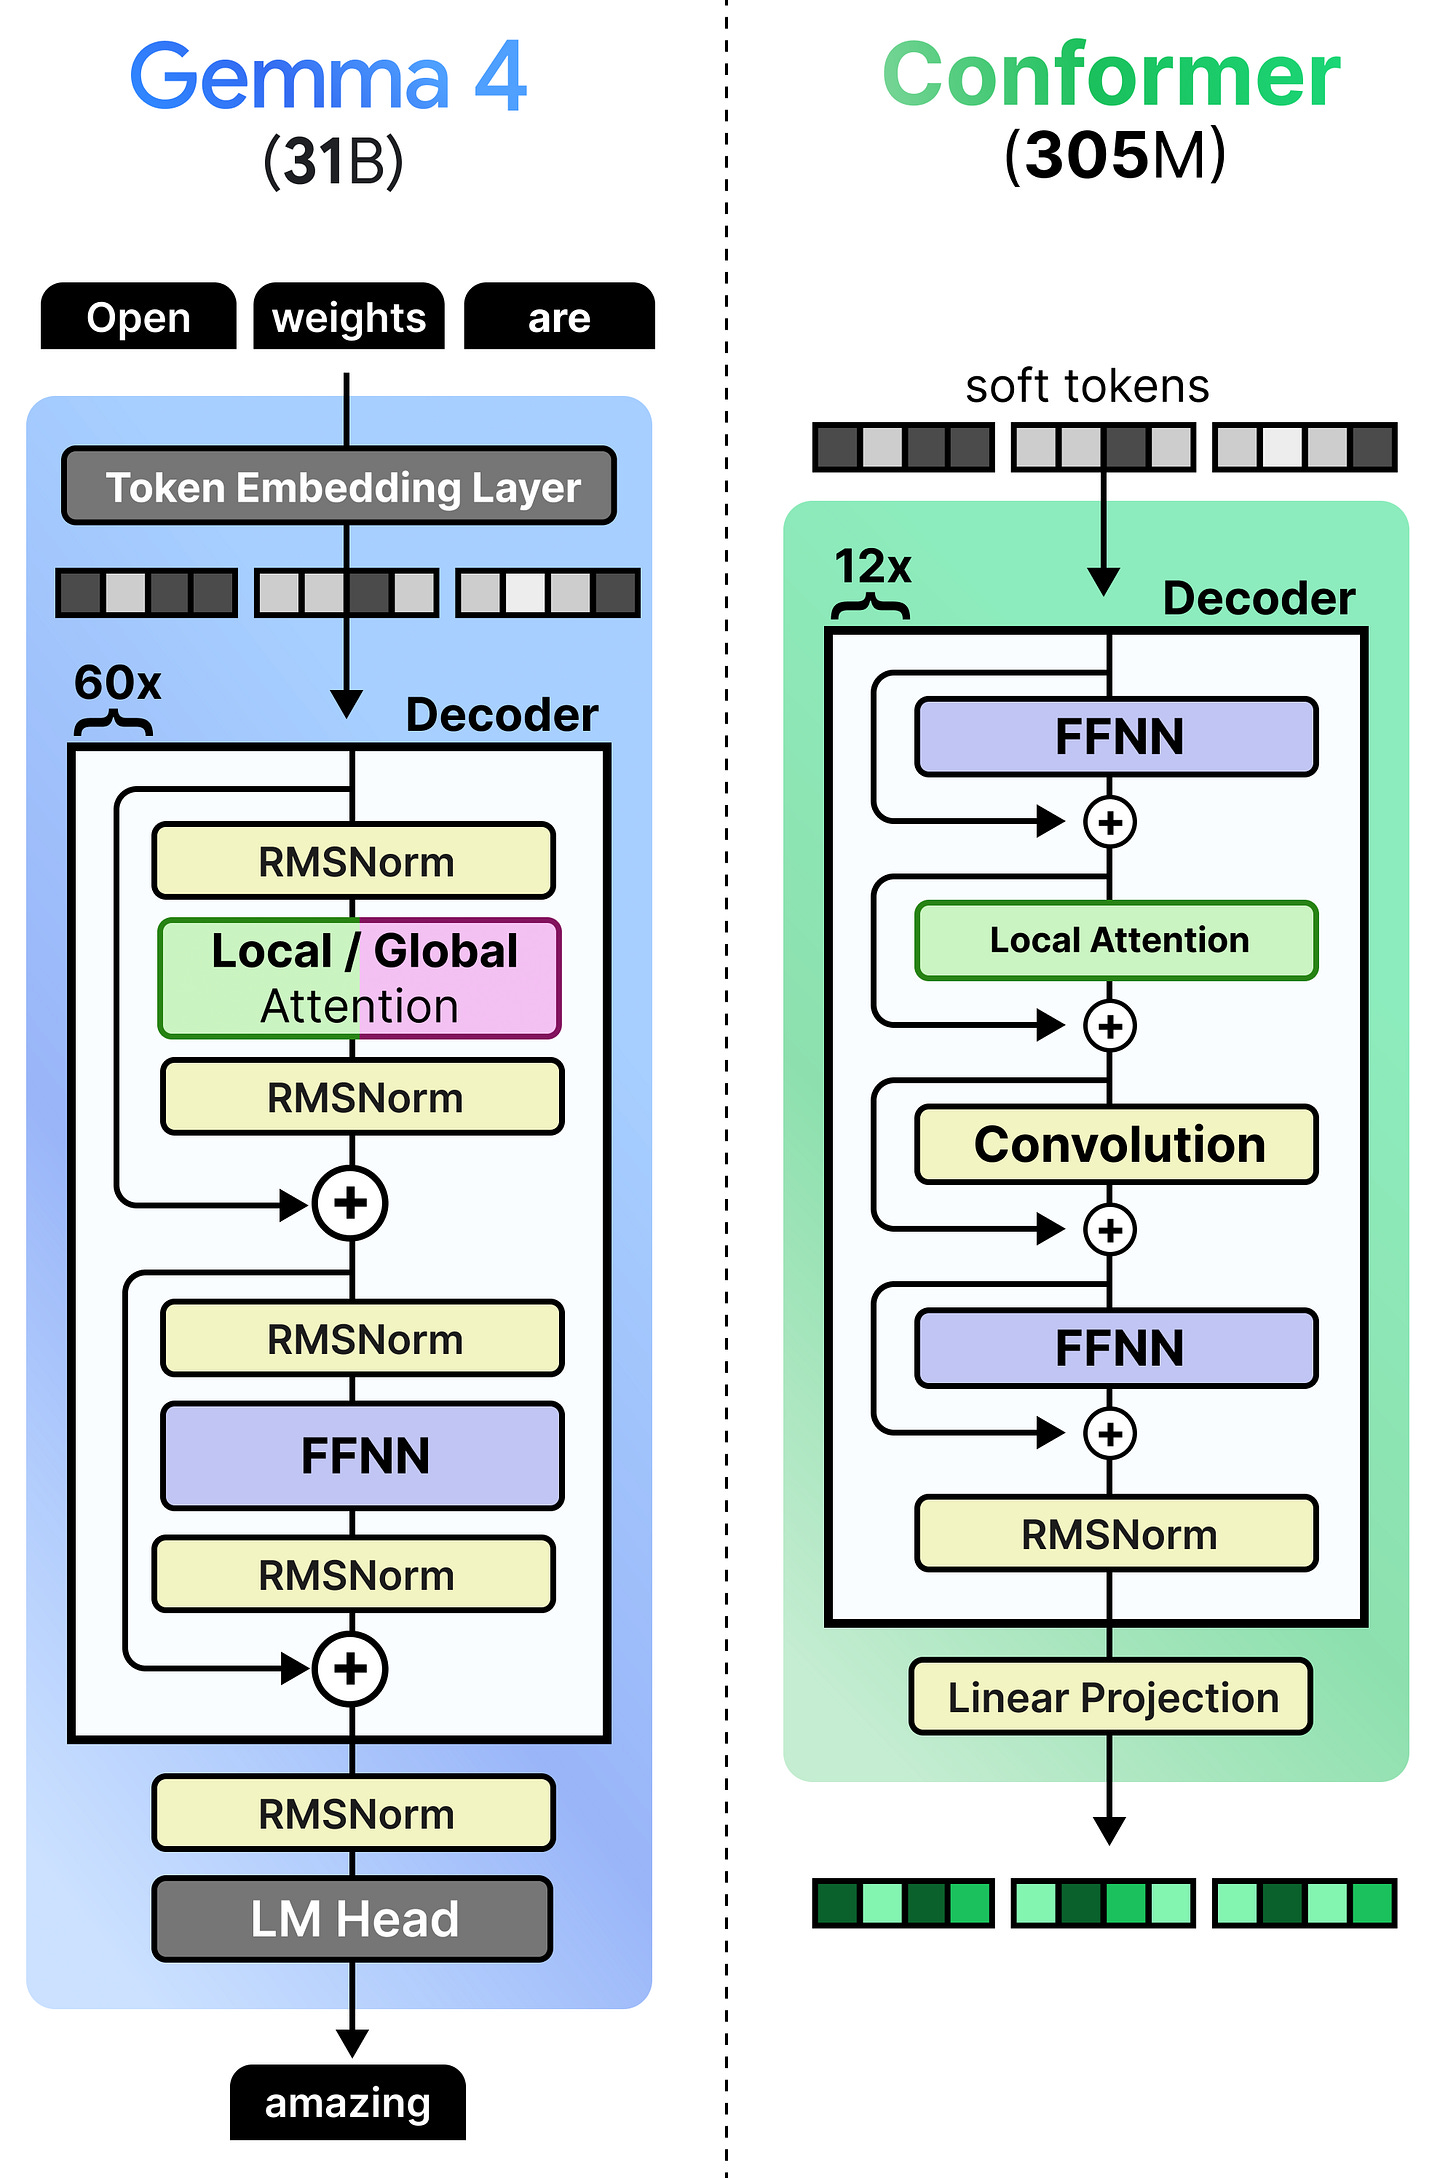
這個過程很像圖像圖塊的線性投影來產生嵌入。它們之後還需要被編碼器進一步處理,讓嵌入充滿上下文資訊。Gemma 4 使用的音訊編碼器稱為 conformer,很像一般的 Transformer 編碼器,但還用了一個卷積模組來處理軟詞元。一個很好的對照是密集的 Gemma 4 31B 與 conformer 的實現方式。請注意它產生的是嵌入而不是詞元。
就像視覺編碼器一樣,conformer 產生的嵌入會被投影到 Gemma 4 所期望的嵌入維度空間。否則,嵌入尺寸不符就無法被 Gemma 4 處理。
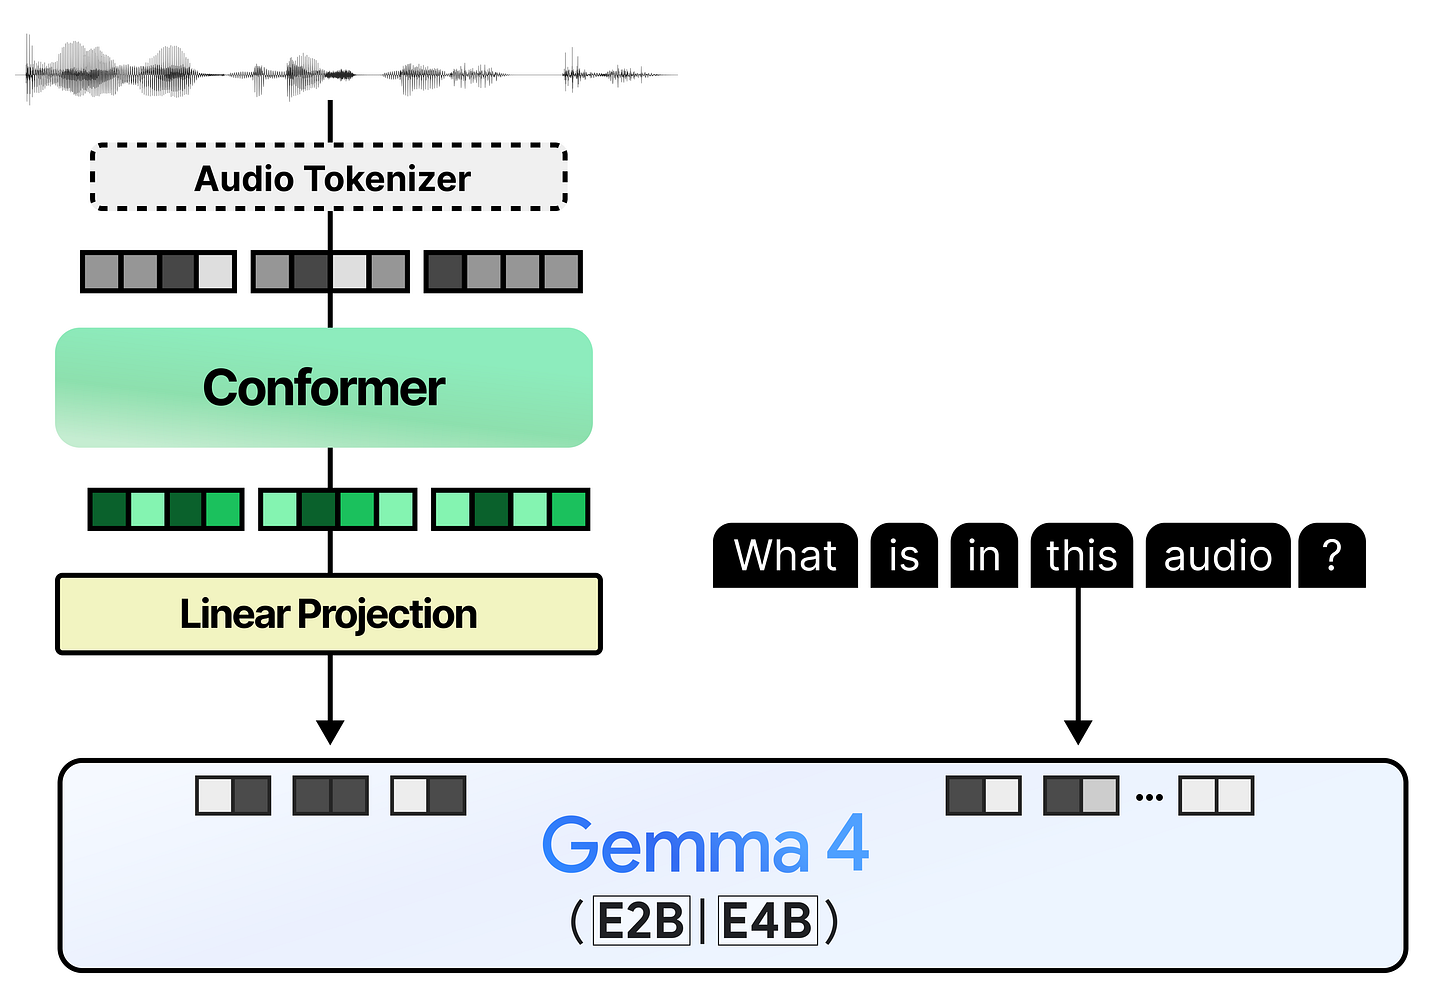
這讓我們得到了一個與視覺編碼器相當類似的管線!