Gemma 4 12B 視覺化指南
Note
原文首刊於 Exploring Language Models。
全新的 Gemma 4 模型 已經發布,相當值得關注。E4B 與 26B A4B 之間原本有一個空缺需要填補,12B 模型正好補上這個位置。不過,要是 Google DeepMind 不在這款模型上搞點特別的、再與大家分享,那就不像 Google DeepMind 了。
那麼,Gemma 4 12B 到底有什麼不同?
它沒有編碼器(encoder-free)!
老實說,我第一次聽到「無編碼器」時也是一頭霧水。現在的生成式 LLM 不本來就都是只有解碼器嗎?過了一會兒我才明白,這個模型其實是把負責音訊與影片理解的編碼器拿掉了,但仍然保有這些多模態能力。
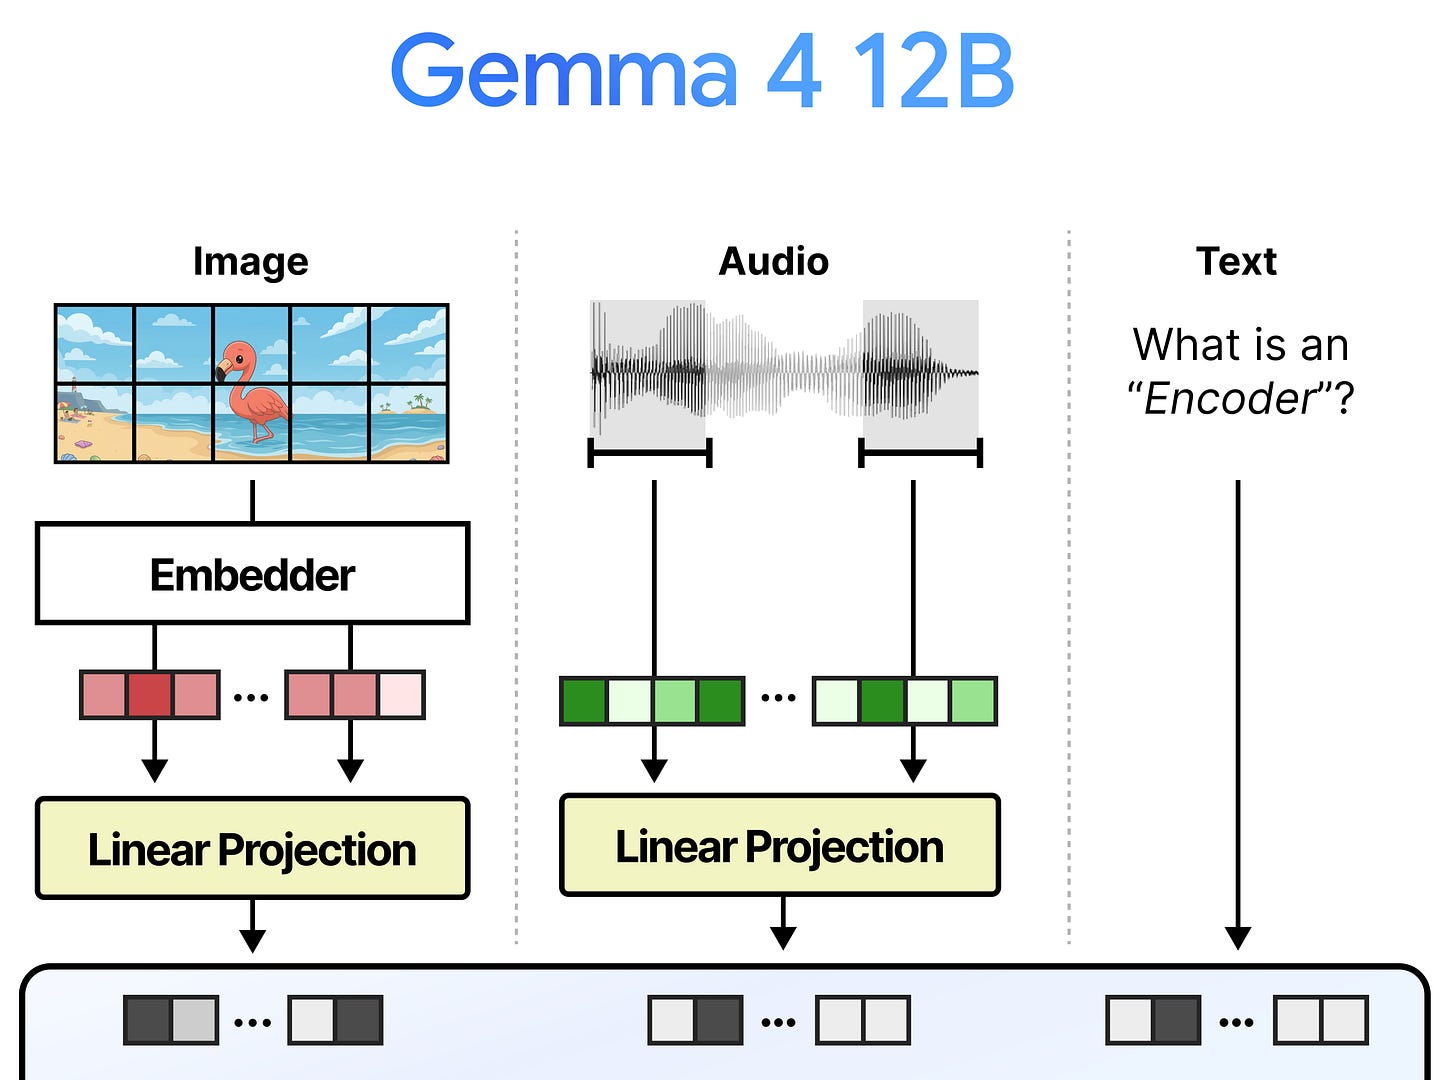
移除編碼器(通常由它們負責解讀多模態輸入)之後,解讀所有輸入的重擔就落到了 LLM 身上。雖然模型沒有編碼器,但所有模態如今都統一在 LLM 之內。模型不必等待編碼器先處理完音訊和圖像輸入,LLM 可以更早開始處理輸入、生成輸出!
在這份指南中,我想呈現移除視覺與音訊編碼器、並用更快方案取代它們的過程。成果就是一個 12B 模型,能處理音訊和圖像輸入,但不需要編碼器。
編碼與連接各個模態
在探索 Gemma 4 與它如何做到無編碼器之前,讓我們先退一步,了解把文字以外的模態接上 LLM 大致意味著什麼。
當一段文字交給 LLM,LLM 本身(透過其詞元嵌入層)負責把文字切成詞元、轉換成嵌入。這些嵌入接著傳給 LLM 的解碼器層,解碼器中的注意力層會為這些詞元嵌入建立有意義、具上下文的表示。
要讓 LLM 具備理解文字以外模態(如音訊和視覺)的能力,這些處理大多不由 LLM 處理。取而代之的是先用一個由注意力驅動的獨立編碼器,把輸入處理成嵌入。編碼器通常是小型的 Transformer 模型,用注意力處理輸入,就像 LLM 那樣。
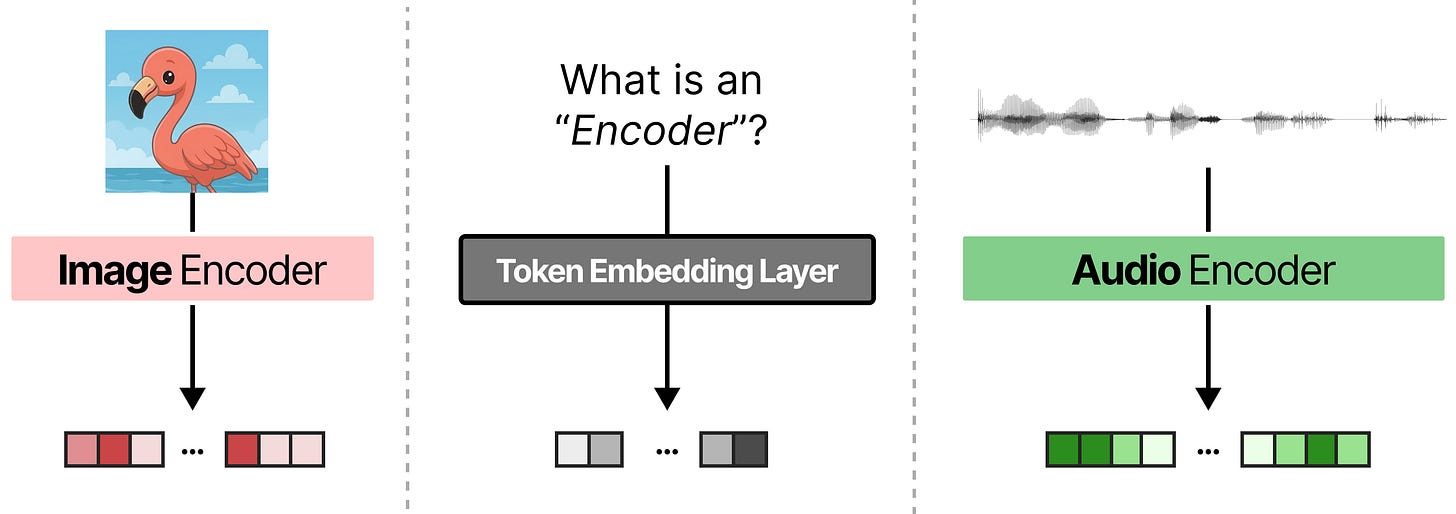
然而,產生的嵌入無法直接給 LLM 使用。它們的維度通常不同,在 n 維空間中的行為也可能不一樣。常見的做法是使用稱為「連接器(connector)」的東西,把編碼器的輸出轉換成與詞元嵌入相同的維度。畢竟,大型語言模型主要是在文字上訓練的。
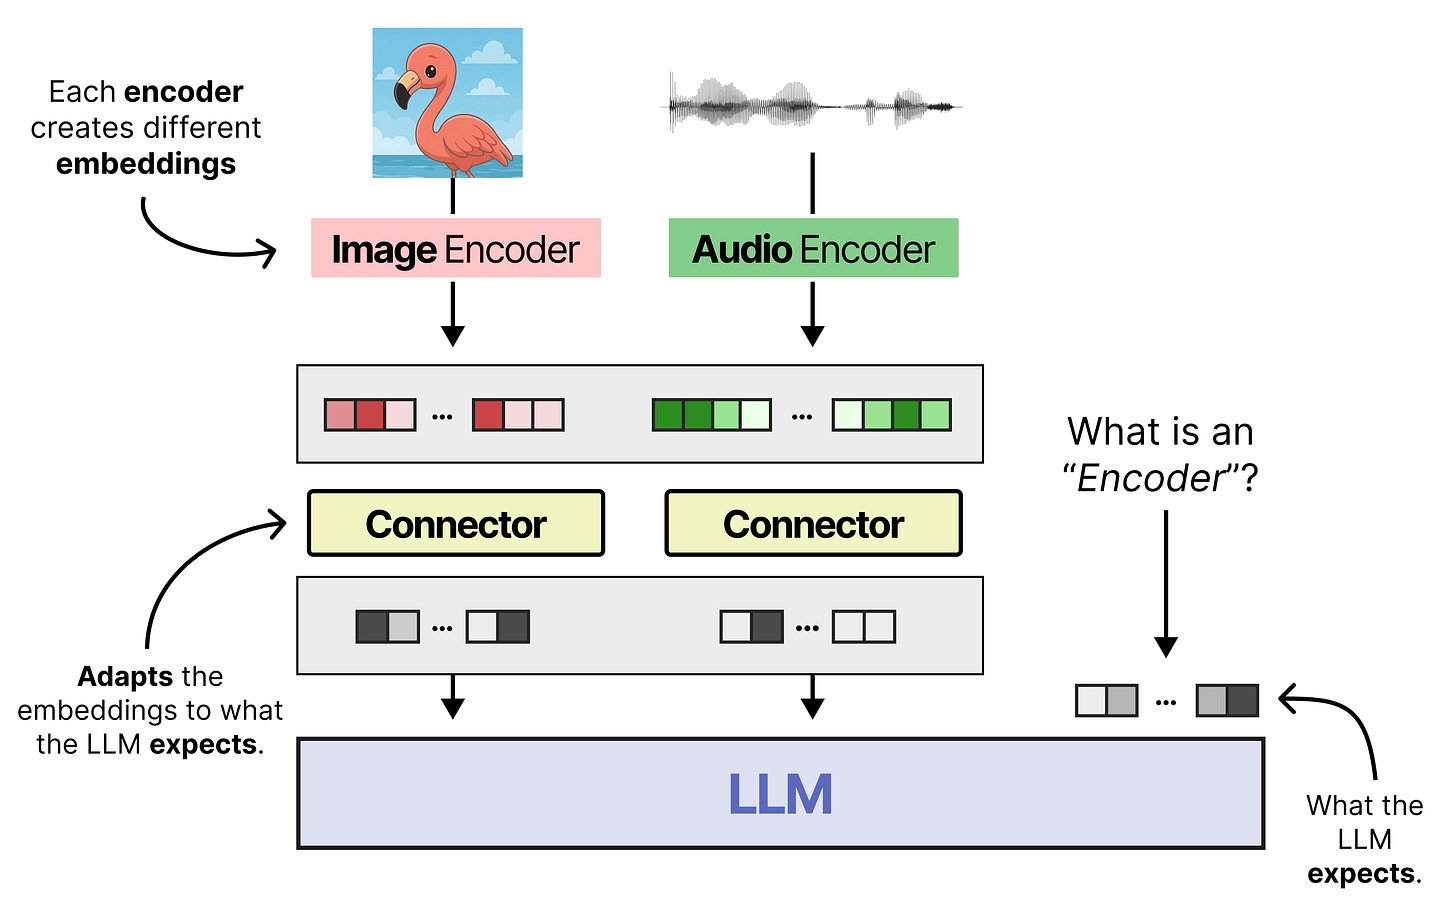
一般來說,就是用這兩個元件讓 LLM 具備多模態能力。效果相當不錯,許多開放的多模態 LLM 都採用,例如 Gemma 4 和 Qwen 3.5。
不過天下沒有白吃的午餐。非文字編碼器必須先處理完輸入,LLM 才能開始工作。這會為模型推論增加一些延遲。而且以絕對值來說,編碼器不小,也會增加不少參數量。
那麼……如果我們不需要編碼器呢?如果只需要連接器呢?
要探索 DeepMind 如何統一多模態輸入,我們先來看看 Gemma 4 的編碼器如何運作,以及取代它們需要做什麼。
Gemma 4 的模態
Gemma 4 支援三種模態:
- 文字輸入 – 所有模型
- 圖像輸入 – 所有模型
- 音訊輸入 – 僅 E2B 與 E4B 模型
這些模態都需要類似 Transformer 的注意力架構來處理輸入。圖像和音訊輸入各用兩個獨立的 Transformer 編碼器,產生 LLM 可用的視覺詞元與音訊詞元。
視覺編碼器
Gemma 4 E2B、E4B、26B A4B 和 31B 都有視覺編碼器來處理輸入圖像。這些視覺編碼器有一定的份量:E2B 和 E4B 的編碼器有 1.5 億參數;26B A4B 和 31B 的則有 5.5 億參數。
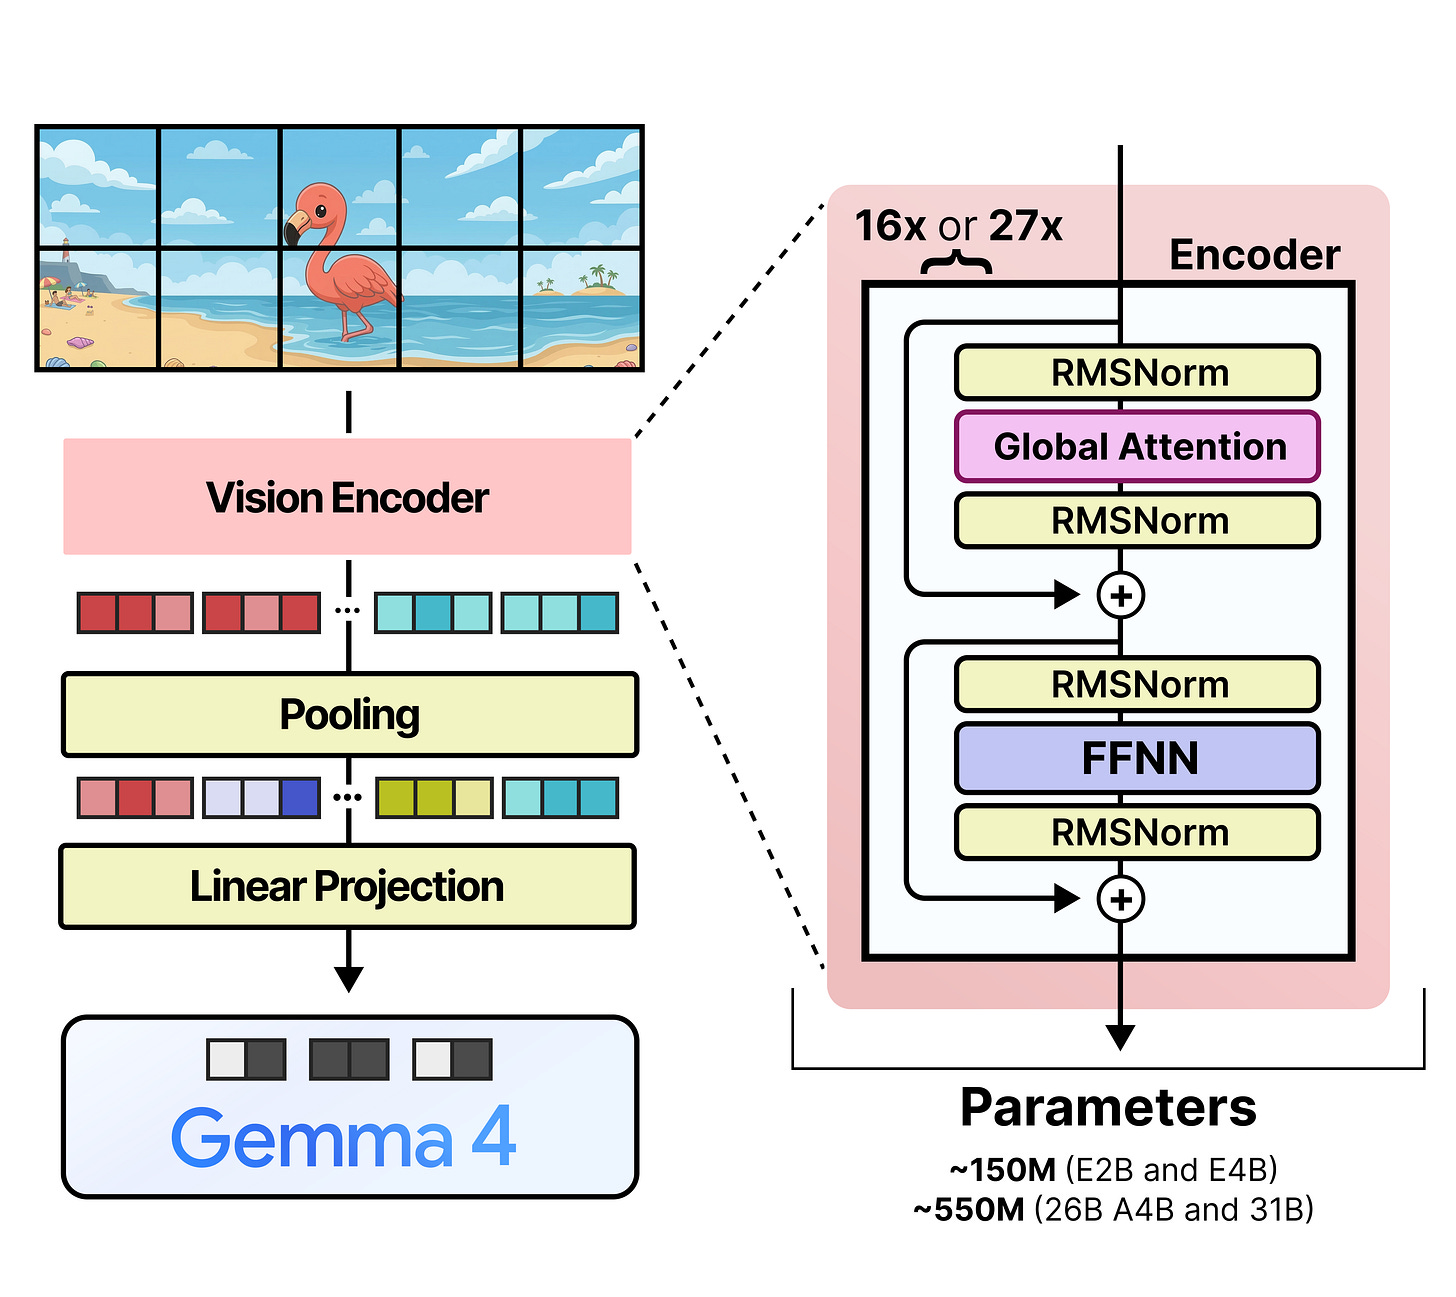
輸入圖塊(patch)大小為 16 x 16 像素。經過視覺編碼器處理後,會以 3 x 3 圖塊的格子做池化(pooling)。
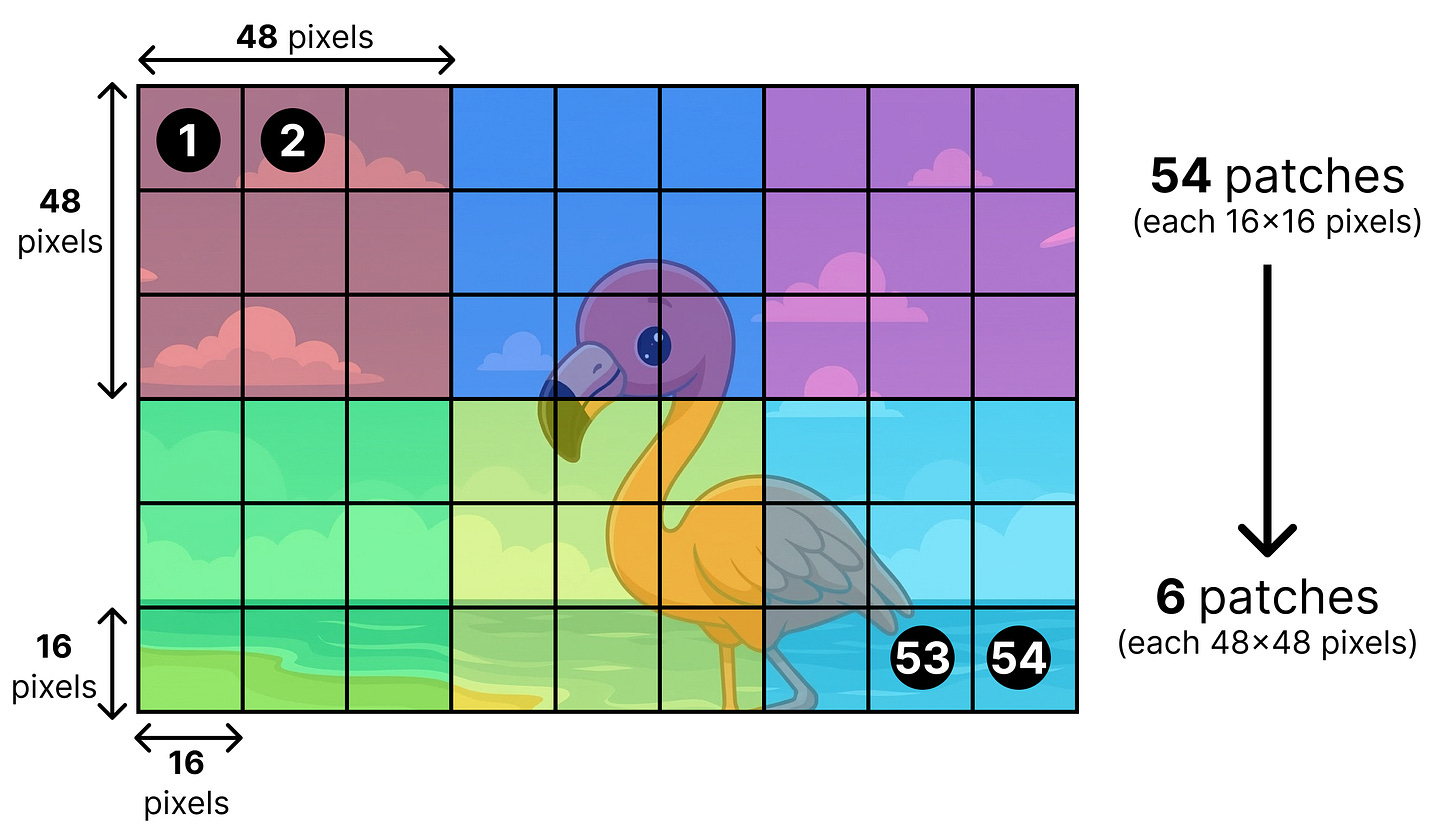
由於把原始圖塊池化在一起,這些圖塊嵌入代表 48 x 48 像素。池化之後,用一個小型的線性投影層(即連接器)把圖塊嵌入轉換成 LLM 可處理的嵌入。因此,最終的圖塊嵌入與詞元嵌入形狀相同,並與詞元嵌入交錯排列。
音訊編碼器
較小的 Gemma 4 模型(E2B 和 E4B)也有音訊編碼器處理輸入音訊。和視覺編碼器一樣,這些音訊編碼器也有一定份量。E2B 和 E4B 的音訊編碼器相同,都有 3.05 億參數。
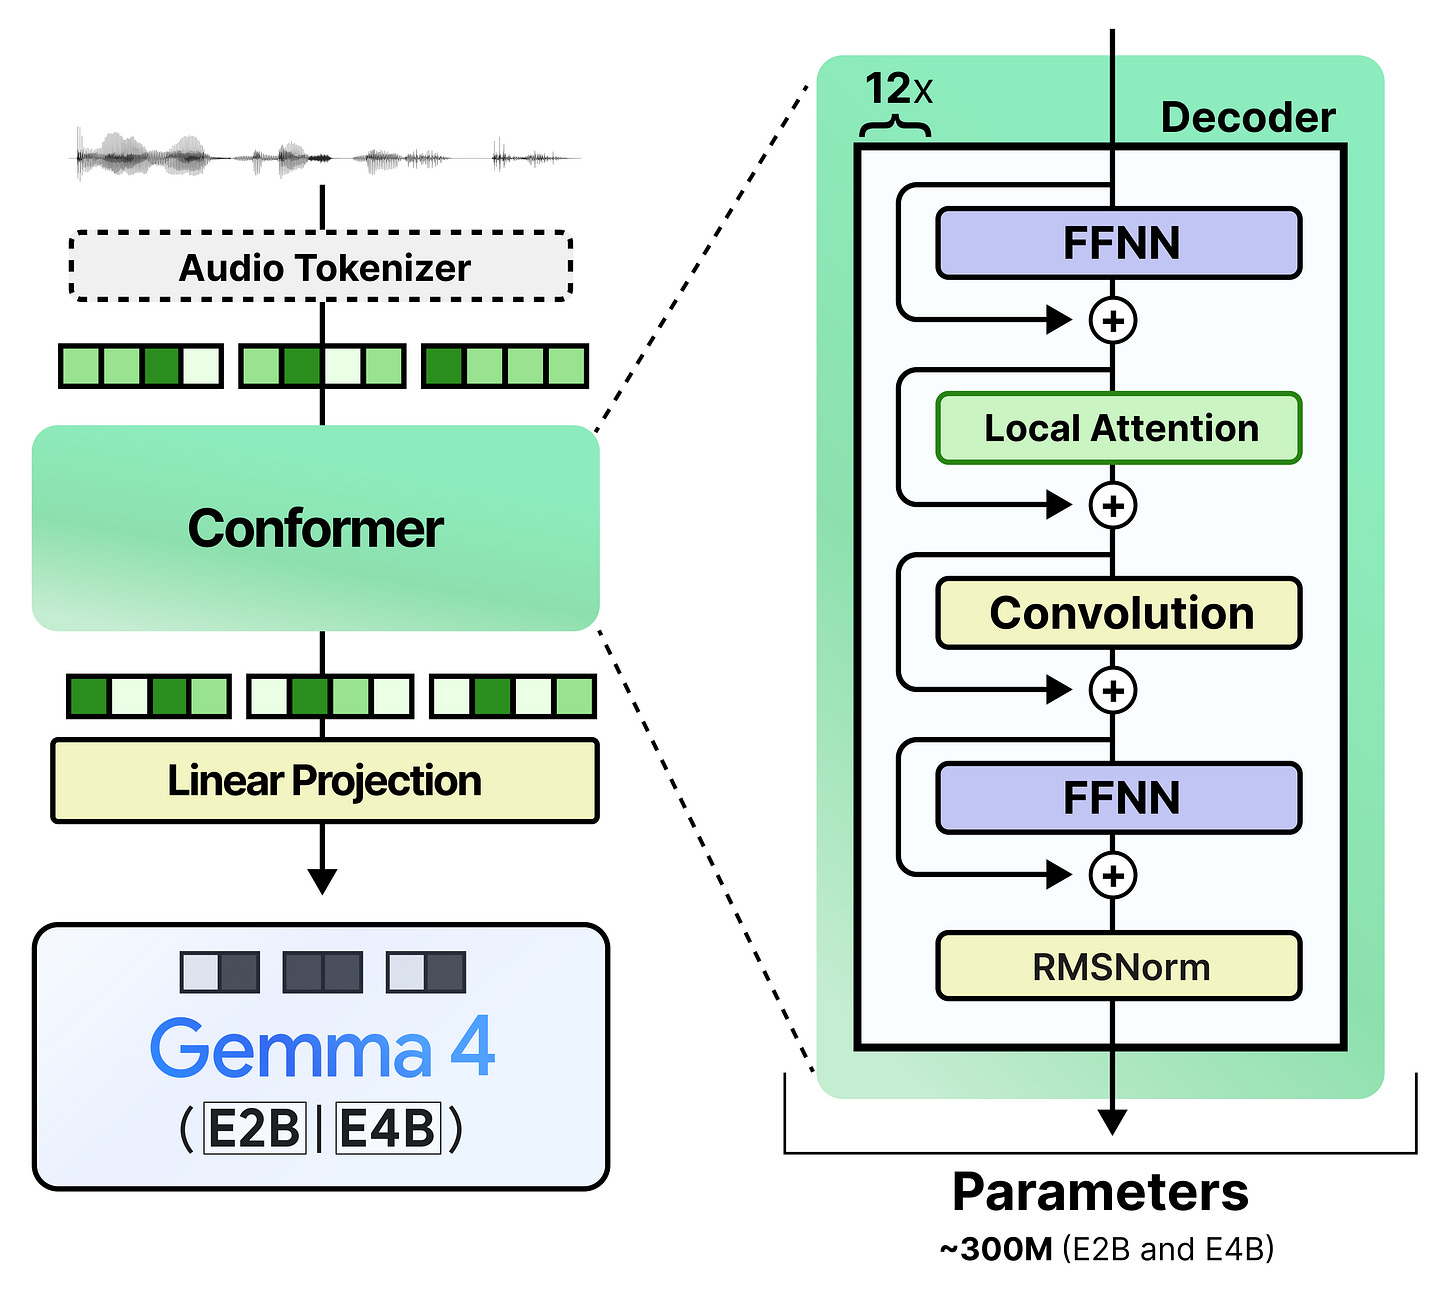
和視覺編碼器一樣,處理完音訊輸入後,會把嵌入投影到與詞元嵌入相同的維度空間。產生的音訊詞元嵌入與文字詞元嵌入交錯排列。
這些模型雖然相對於對應的 Gemma 4 模型來說不算大,但處理輸入仍會增加延遲,也讓整個管線更複雜。而且微調 Gemma 4 模型時,通常只微調 LLM 本身,而不會微調其編碼器。這讓編碼器很難跟著模型一起成長——必須同步微調,徒增複雜度。
那麼,如果能完全不用編碼器呢?
讓 Gemma 4 12B 無編碼器
為了移除編碼器,同時為社群帶來新模型,Google DeepMind 推出了 Gemma 4 12B 模型。Gemma 4 12B 的主架構(只看 LLM 本身)與 31B 稠密模型相當類似:同樣使用解碼器結構,局部注意力(local attention)與全域注意力(global attention)交錯排列,且全域注意力永遠排在最後。
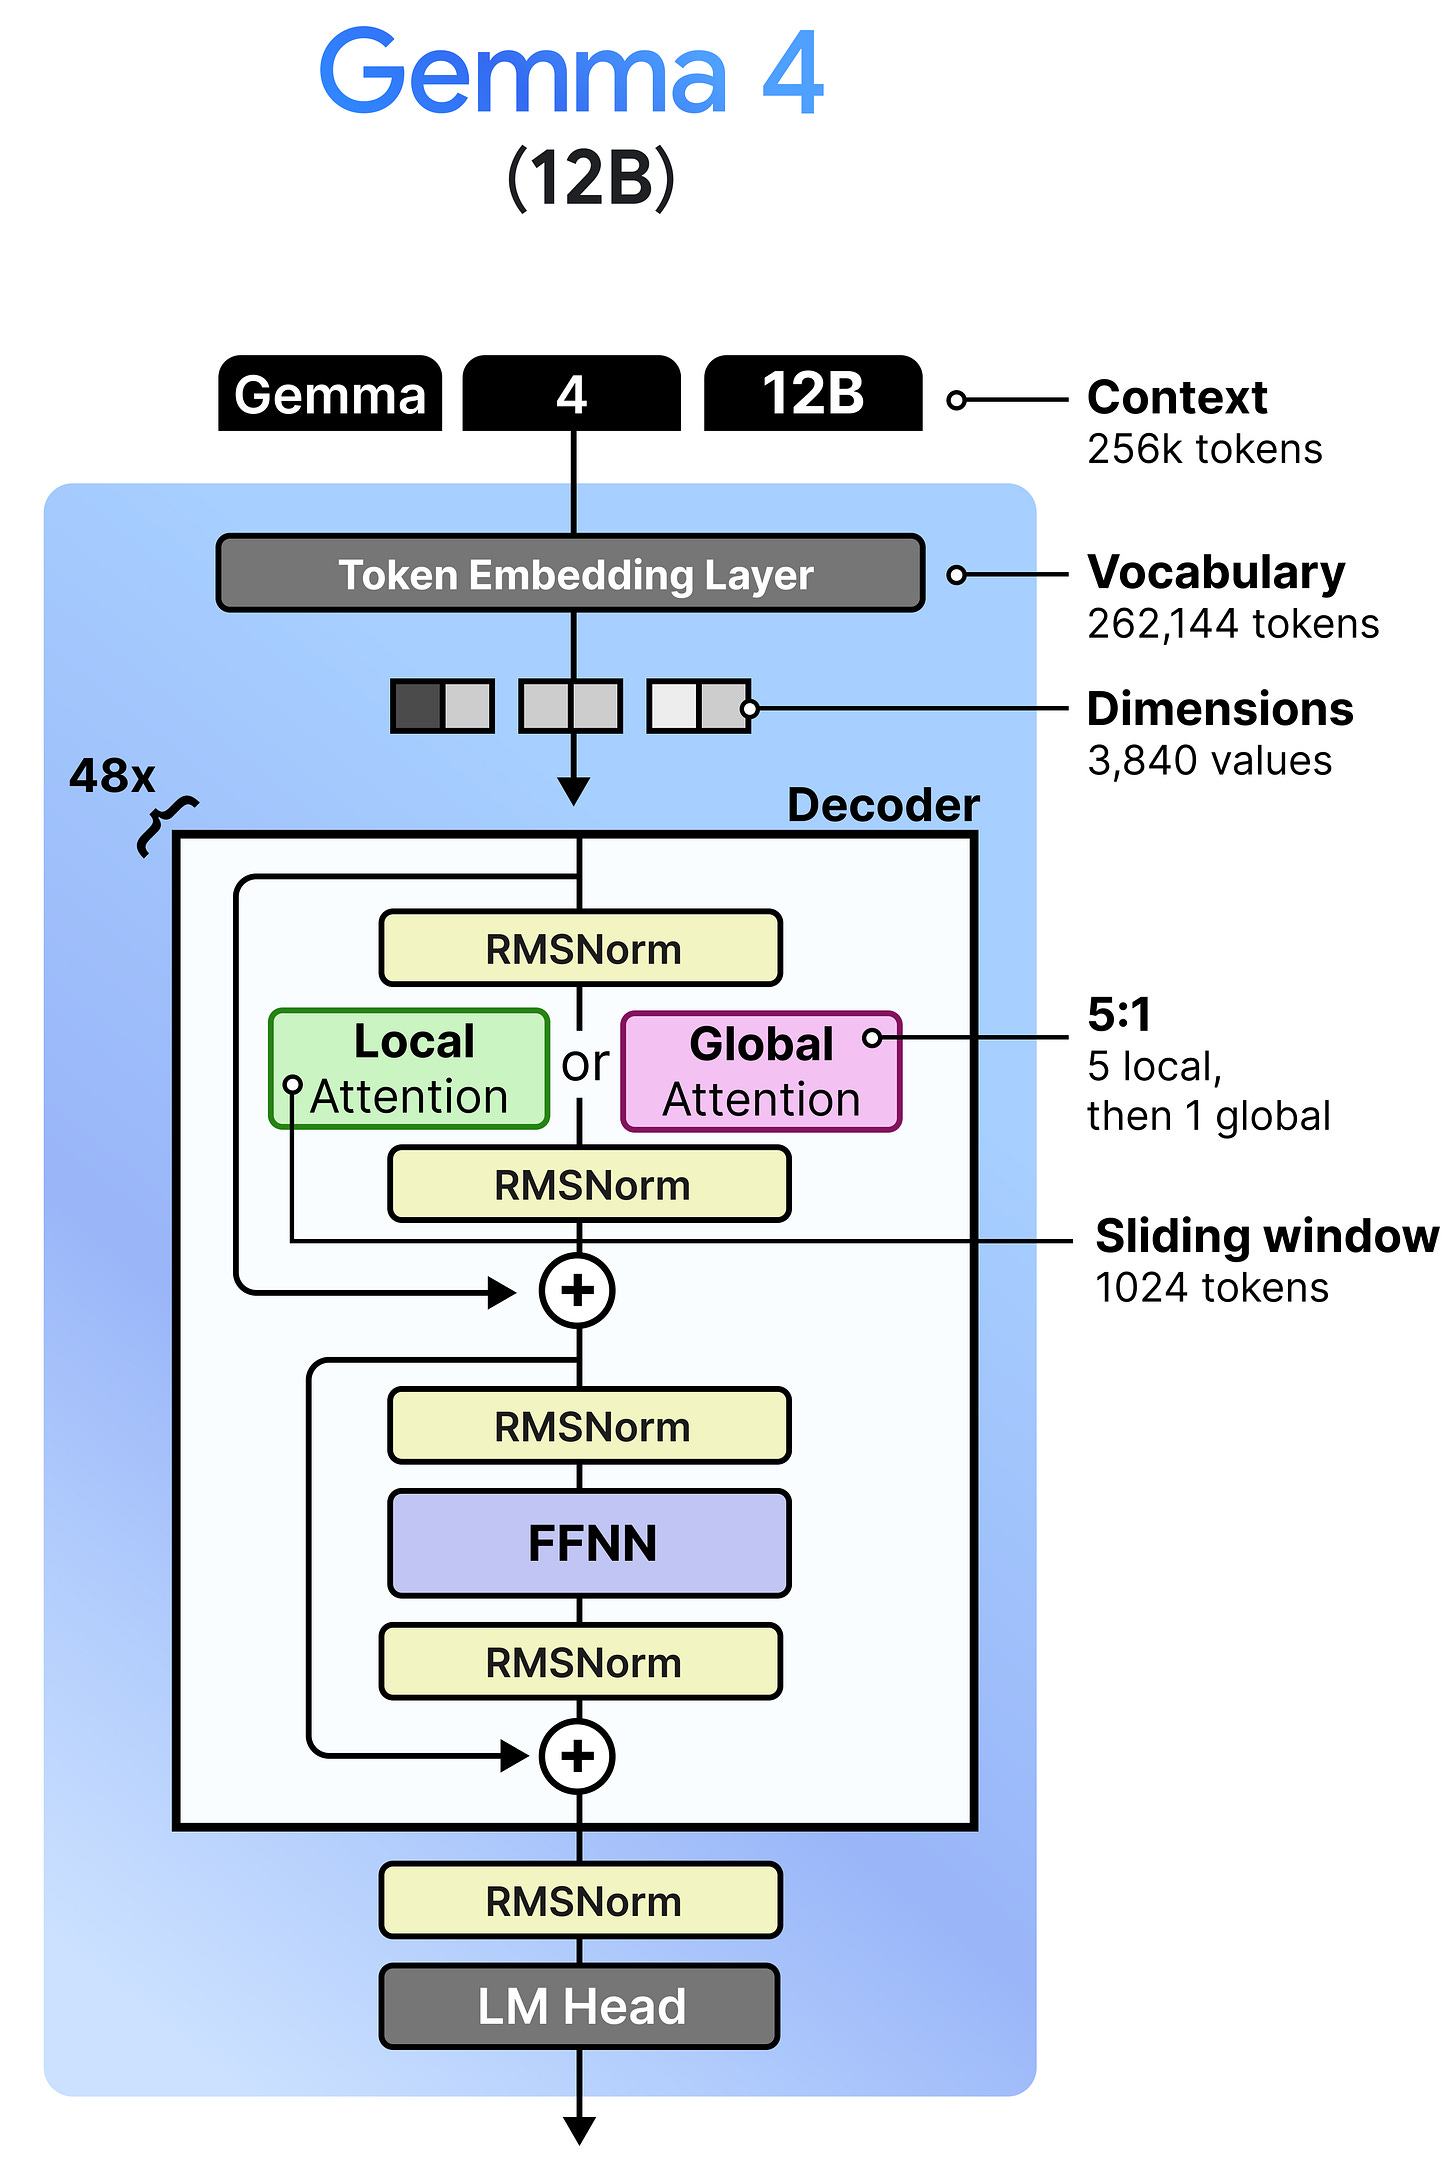
這個模型正好落在現有的 E4B 與 26B A4B 之間,非常適合擁有 12GB 到 16GB VRAM 的配置。
除了大小,它最大的賣點就是去掉了那些有些笨重的編碼器。
取代視覺編碼器
Gemma 4 12B 用一個輕量的嵌入模組取代整個視覺編碼器。不必跑過所有 Transformer 層(15 或 27 層)來抽取和處理視覺特徵,嵌入模組只用單一層就能產生嵌入。
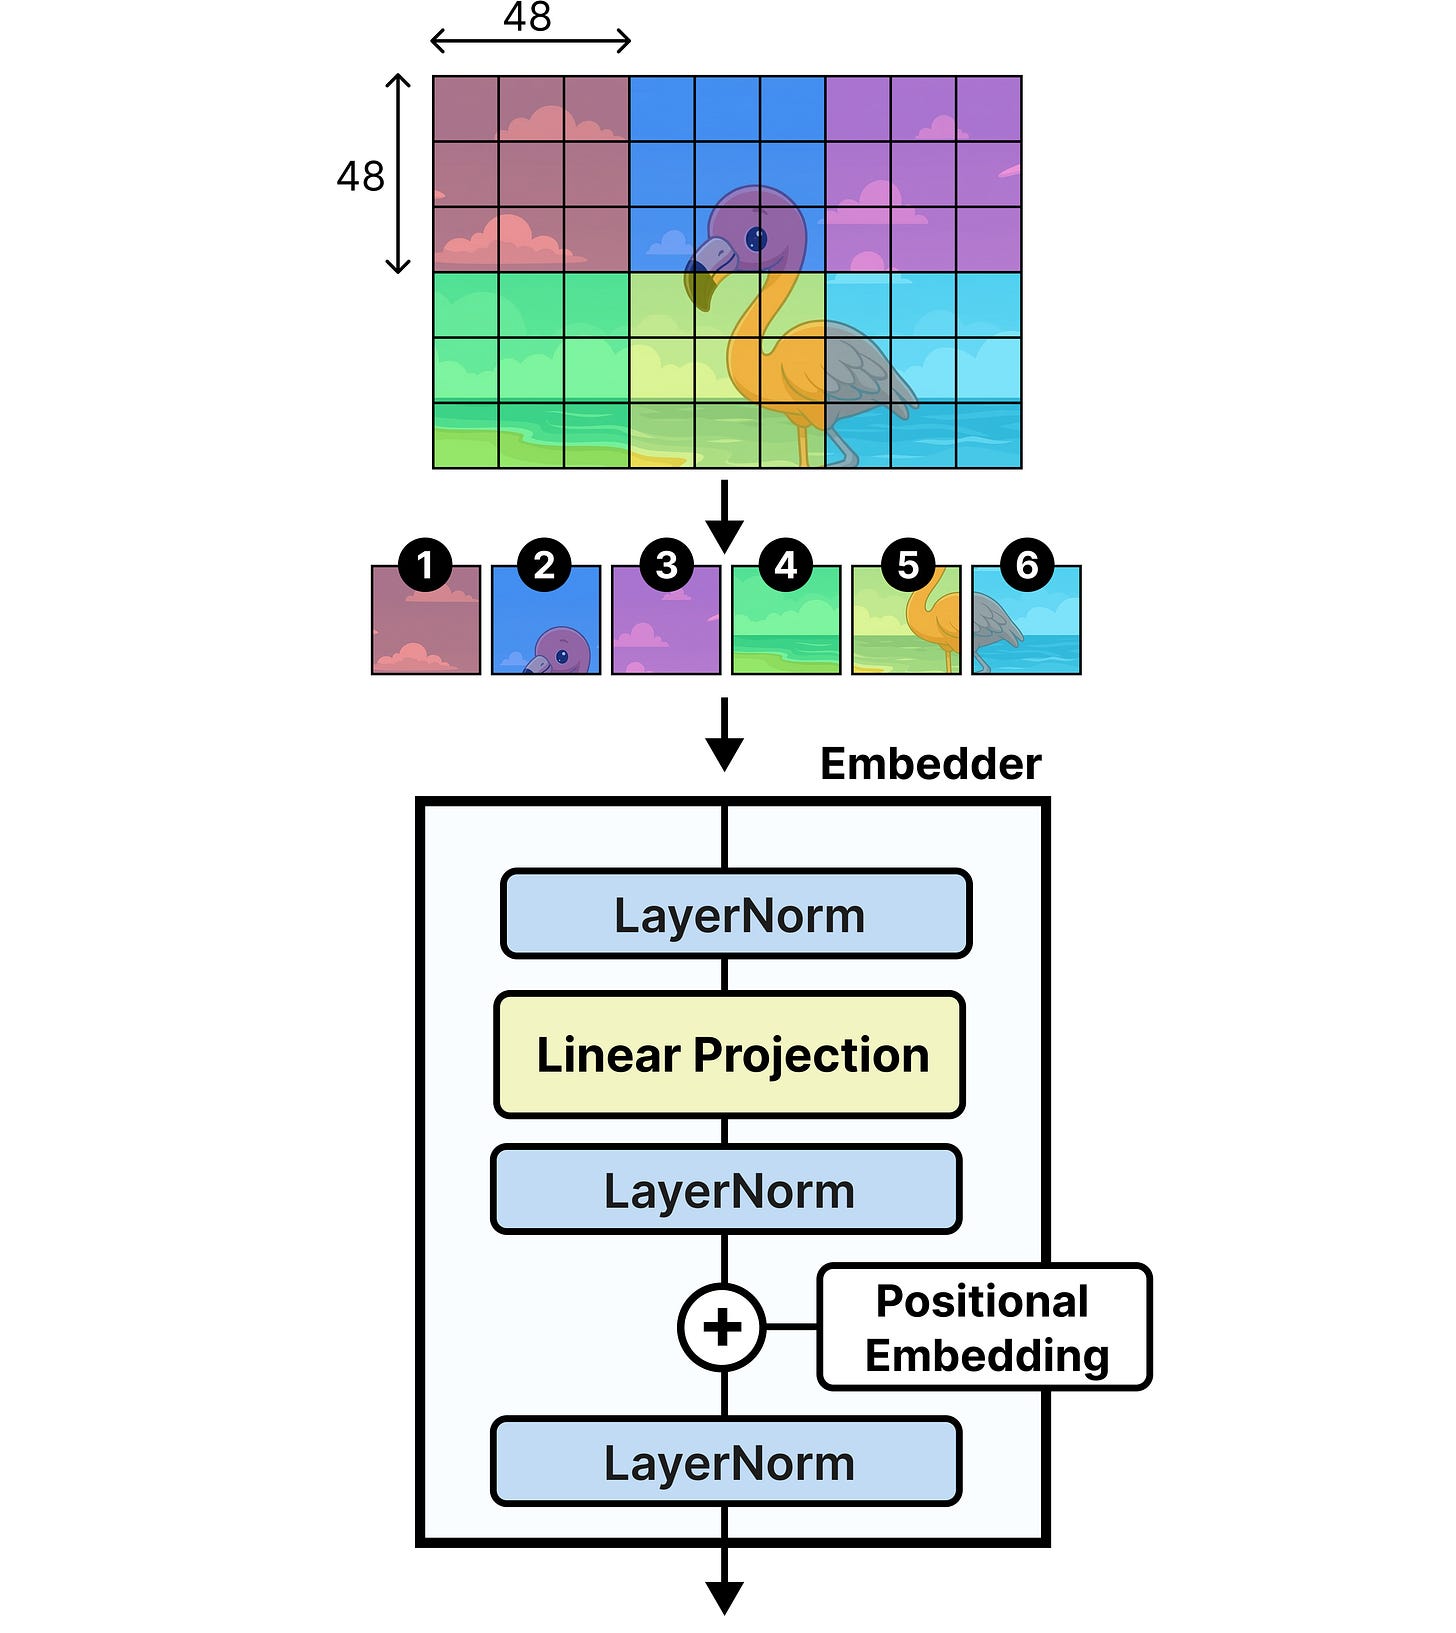
模型直接使用 48x48 圖塊,而非 16x16 圖塊。架構簡化當然是好事,但視覺編碼器本會產生語義豐富的嵌入,嵌入器(embedder)可做不到這點。因此把 16x16 圖塊池化成 48x48 並不會有太大效果。
在處理輸入圖塊時,必須加入位置資訊,讓 LLM 知道這些視覺詞元在原圖中的位置。由於嵌入器沒有注意力,無法使用與視覺編碼器相同的 2D 位置 RoPE。同樣地,也不能用 LLM 的位置編碼,因為 LLM 把輸入視為一維序列。
取而代之的是,在視覺詞元嵌入進入 LLM 之前,先注入空間資訊。這個過程其實相當直接,只需要兩個矩陣:
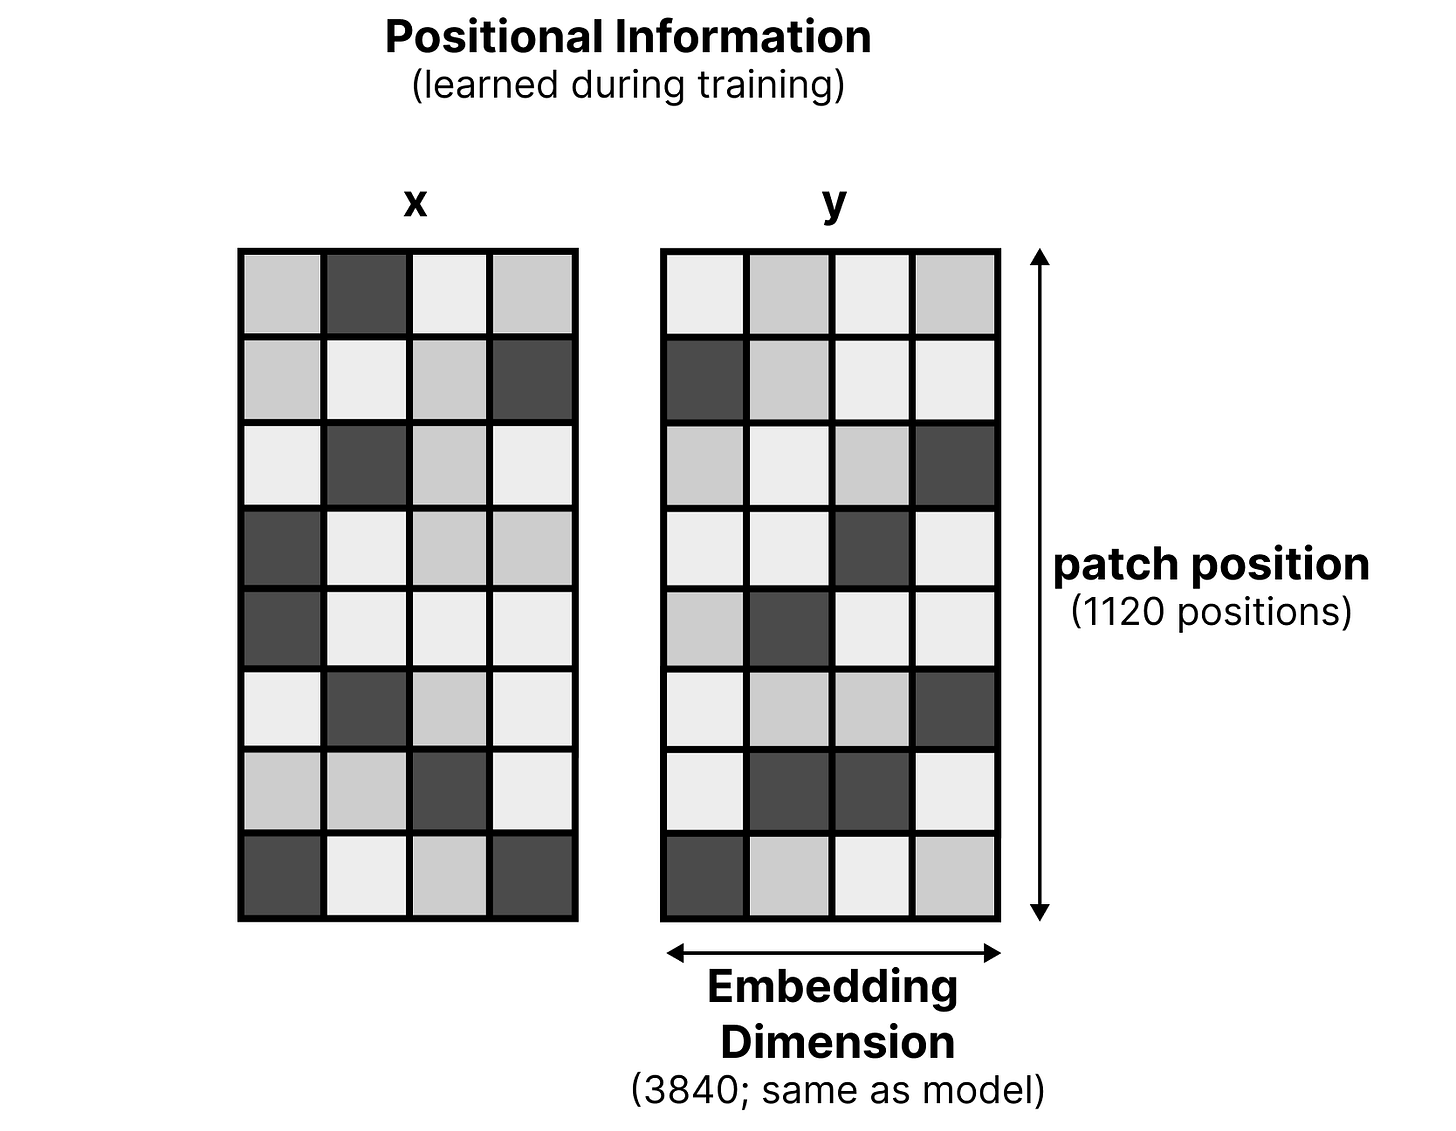
這兩個矩陣代表圖塊的 x 和 y 座標。每個矩陣的維度都是 1120(代表圖塊位置)乘以 3840(與模型的輸入維度相同)。圖塊位置代表輸入圖像的圖塊數量上限。和視覺編碼器一樣,圖塊數量上限可以對應不同的長寬比。
Gemma 4 的視覺編碼器模型允許使用者選擇 70、140、280、560 或 1120 詞元的預算大小(也稱為「圖塊」)。這些預算大小代表把一張圖像切成的最大圖塊數。詞元越多,視角越精細。
每個圖塊會根據其位置加上位置嵌入。舉個例子:假設有個圖塊位於 x=2、y=1。從 x 和 y 矩陣中各選出對應的嵌入,再把它們相加,得到加到每個由嵌入器生成的視覺詞元嵌入上的位置嵌入。
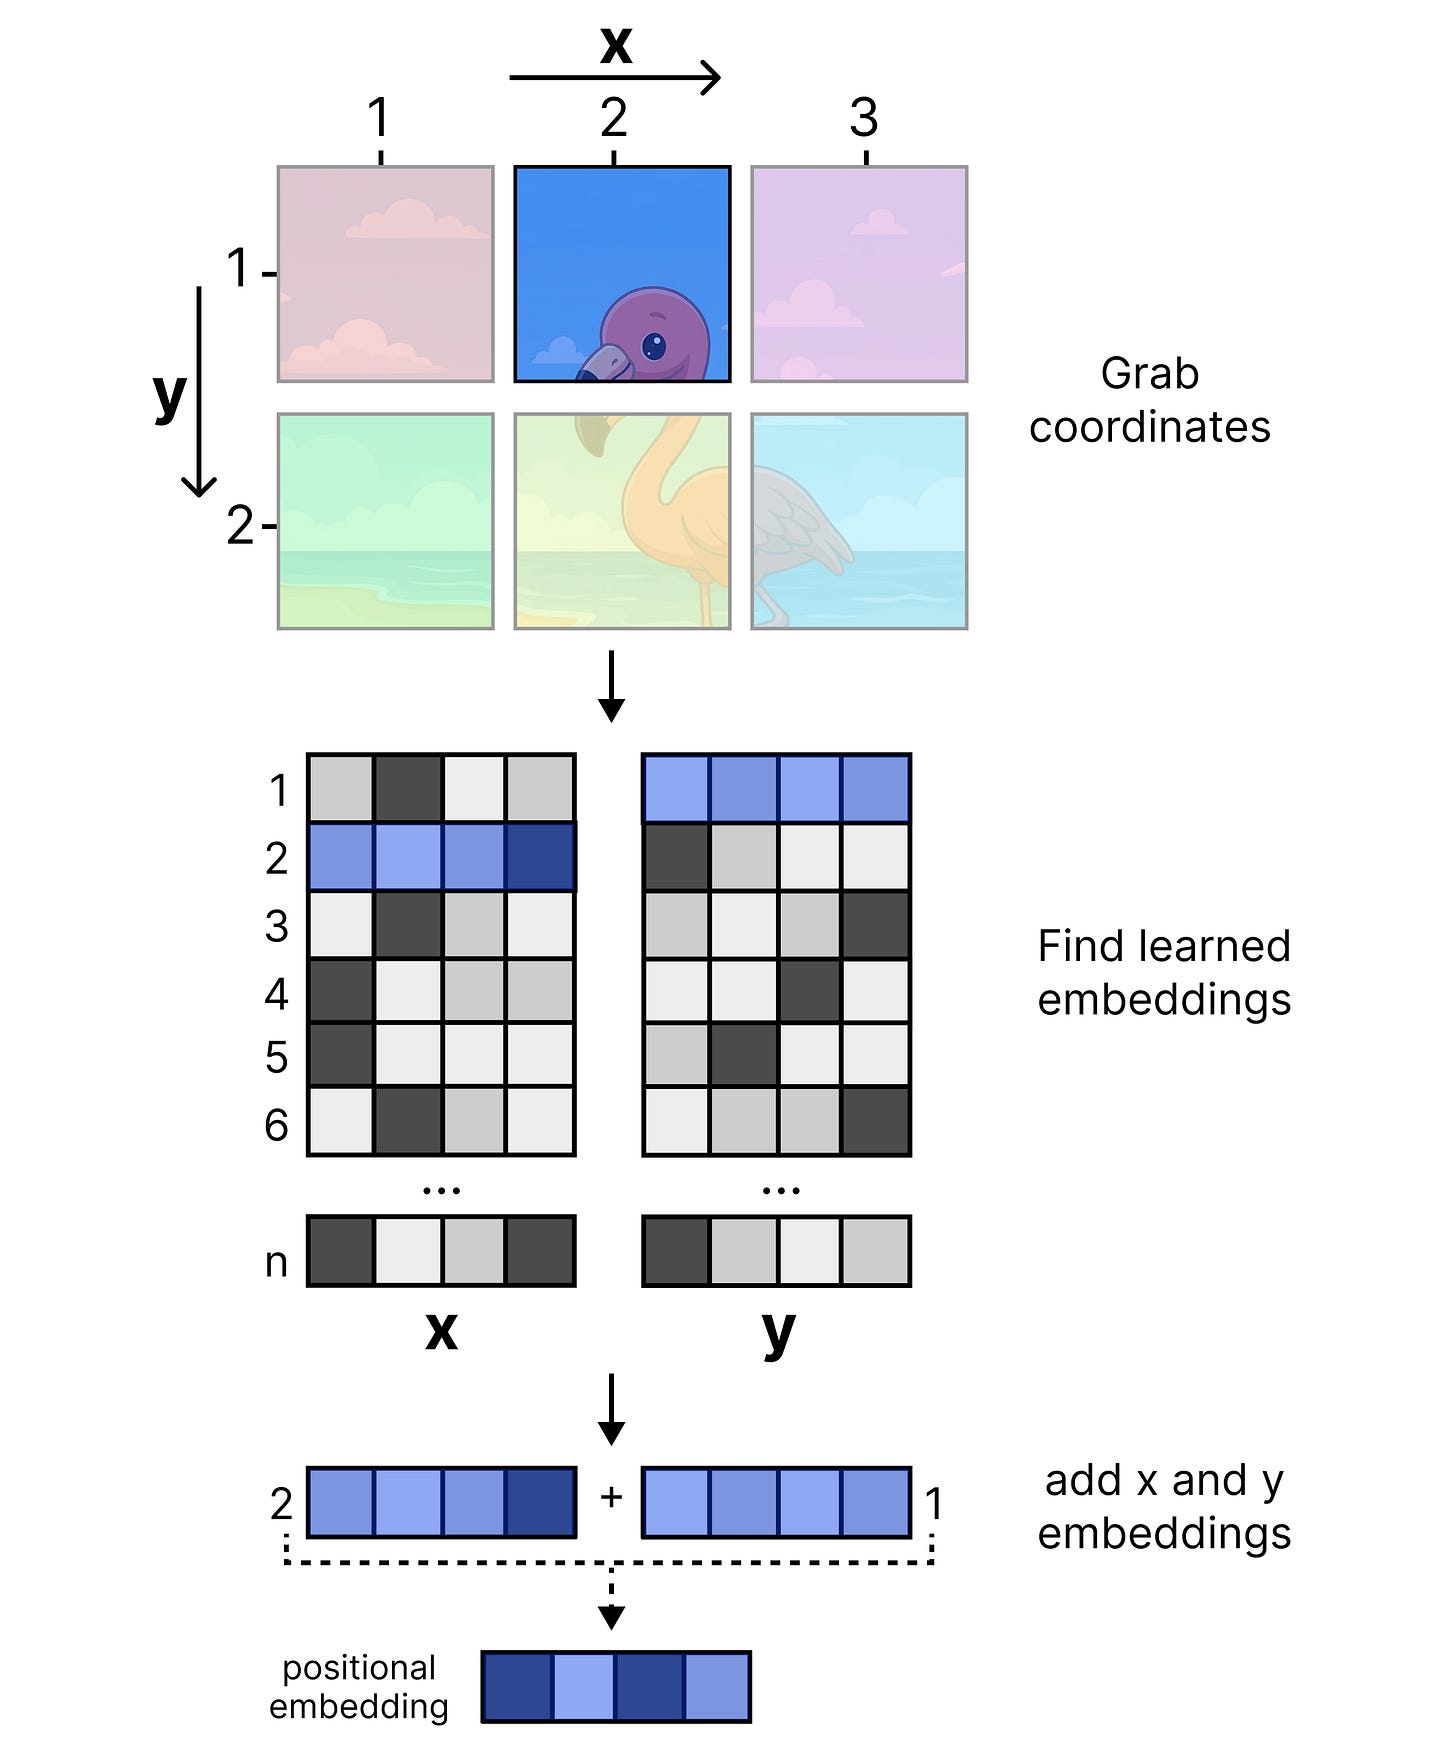
加上位置嵌入後,最後會做一次 LayerNorm 以確保穩定,然後再投影到 Gemma 4 12B 預期的維度。
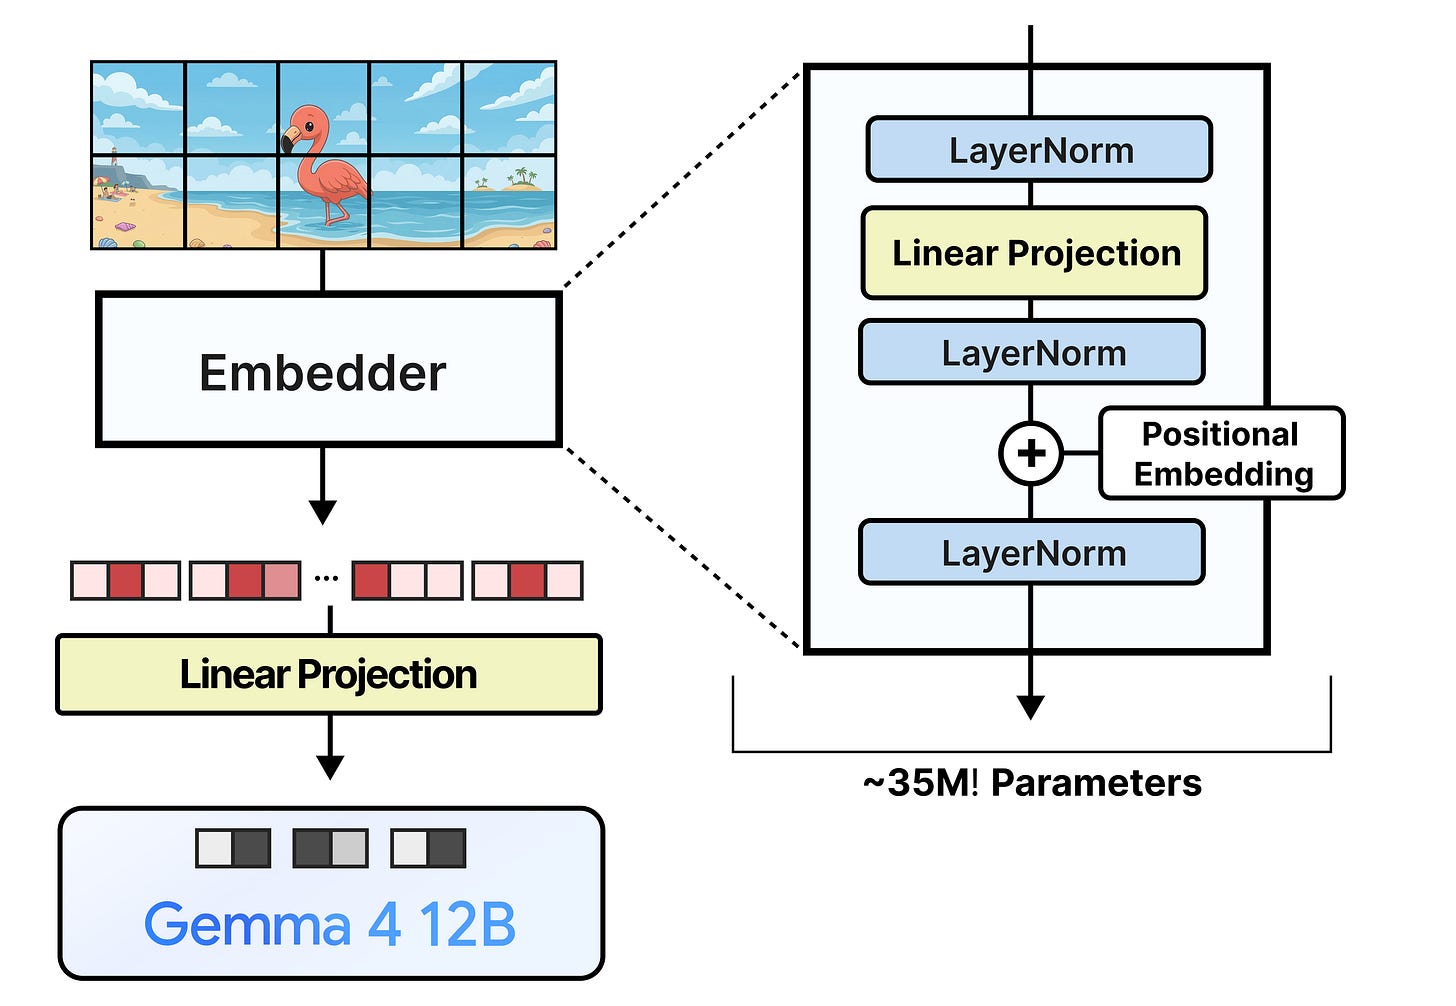
相較於擁有 5.5 億參數視覺編碼器的大型模型,嵌入器只有約 3500 萬參數!不過天下沒有白吃的午餐:原本由視覺編碼器負責的處理和理解工作,現在得由 LLM 接手,而這些是它在訓練中學會的。
你可能會好奇:模型明明是無編碼器的,3500 萬參數是從哪來的?原因主要在於要把圖像圖塊投影到 LLM 的維度。每個圖塊有 48 x 48 x 3 = 6912 個像素,需要投影到 Gemma 4 12B 的維度(3,840)。光是這個投影(6,912 x 3,840 + 3,840)就佔了約 2600 萬參數。
所以,編碼器並沒有縮成 3500 萬參數的注意力與前饋神經網路權重,只是因為有太多像素要投影!
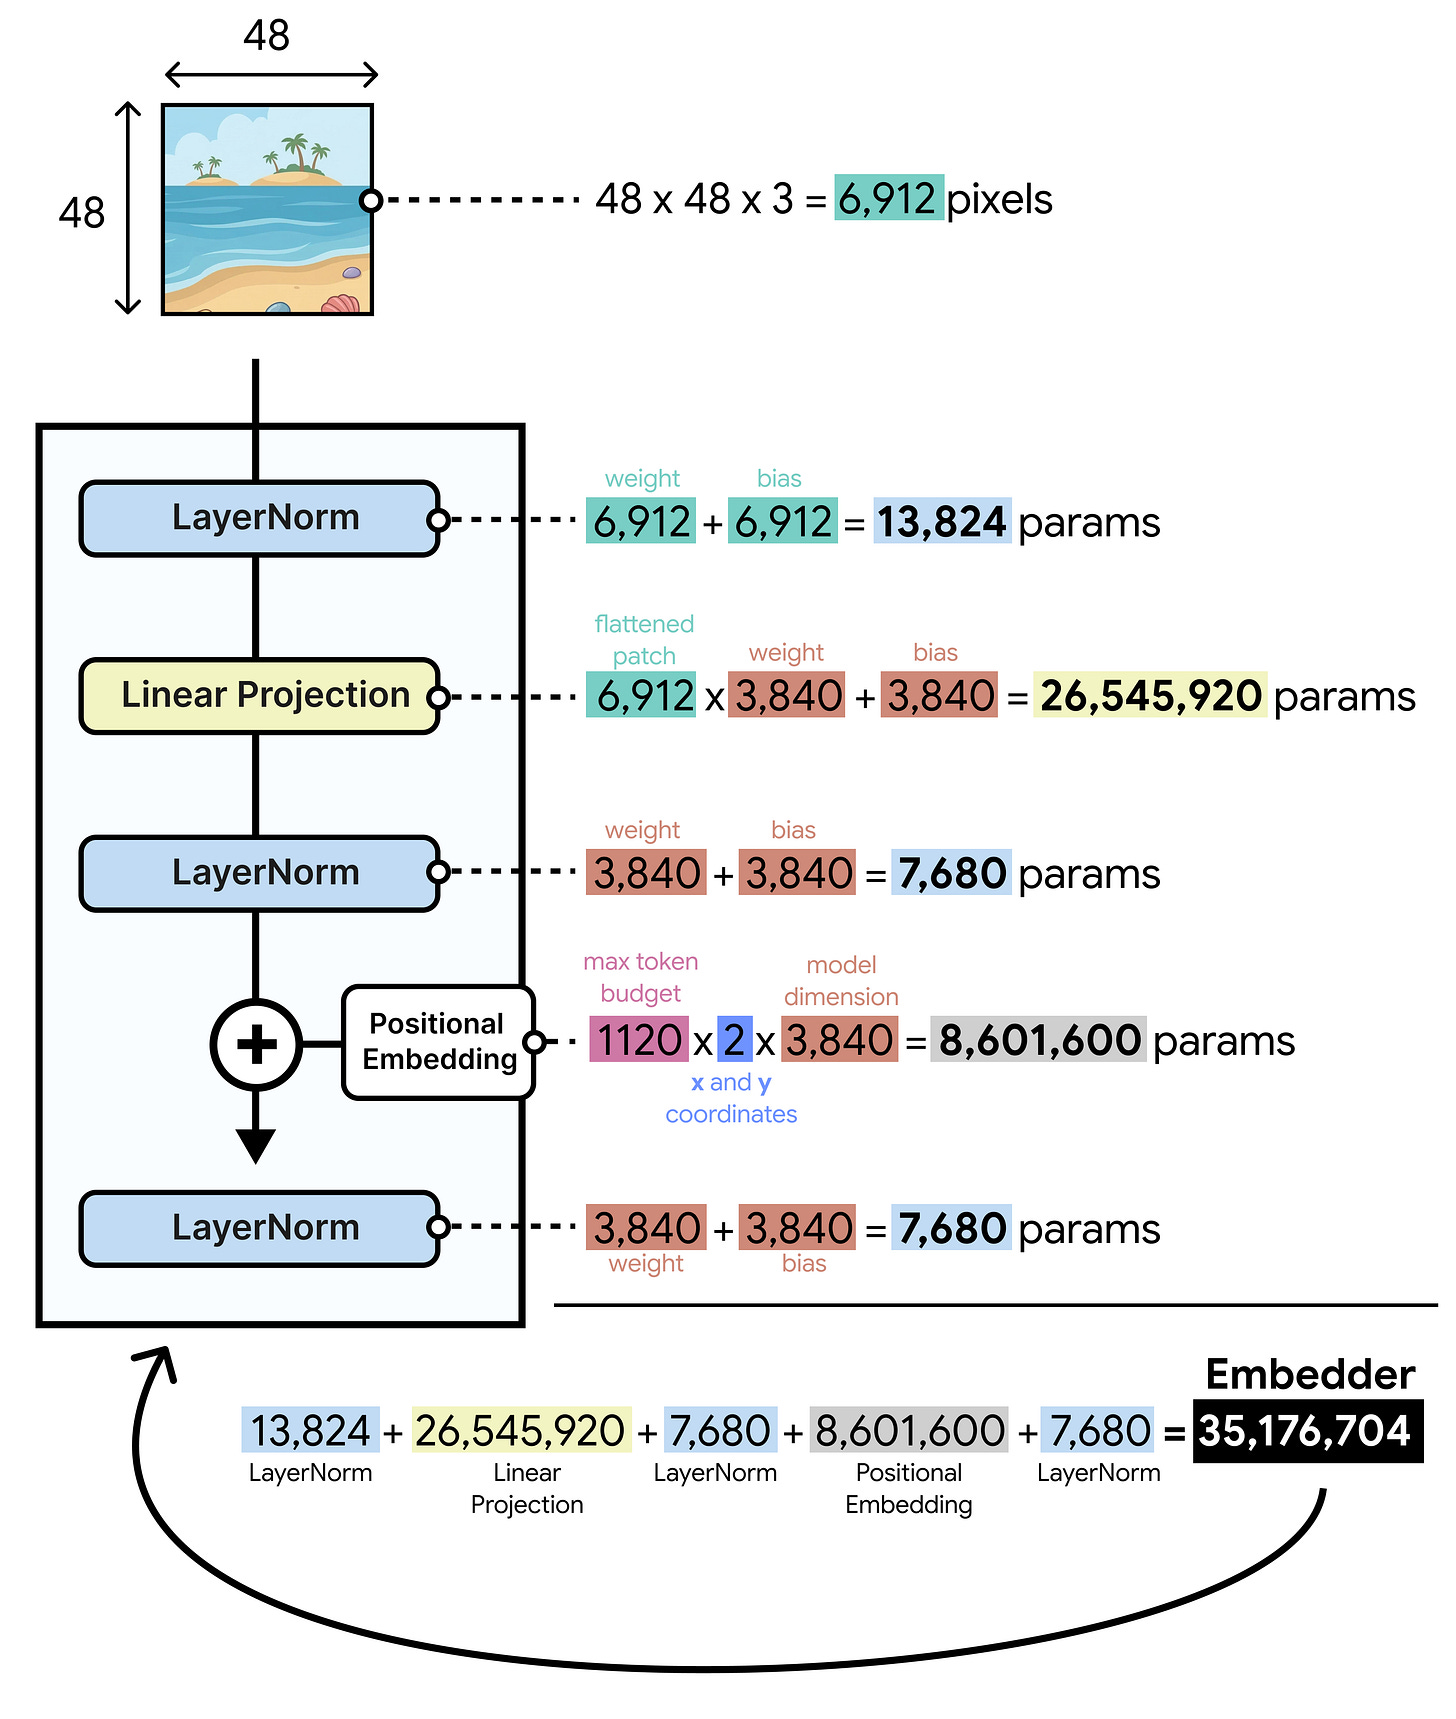
你可能還注意到上圖只用了一個圖塊。由於嵌入器沒有注意力,每個圖塊都是獨立處理的,注意力改由 LLM 處理!
看看下圖,差異相當大。相較於 Gemma 4 31B,嵌入器非常精簡,主要用途是加入位置嵌入。除此之外,嵌入器只有約 3500 萬參數,而視覺編碼器有約 5.5 億!
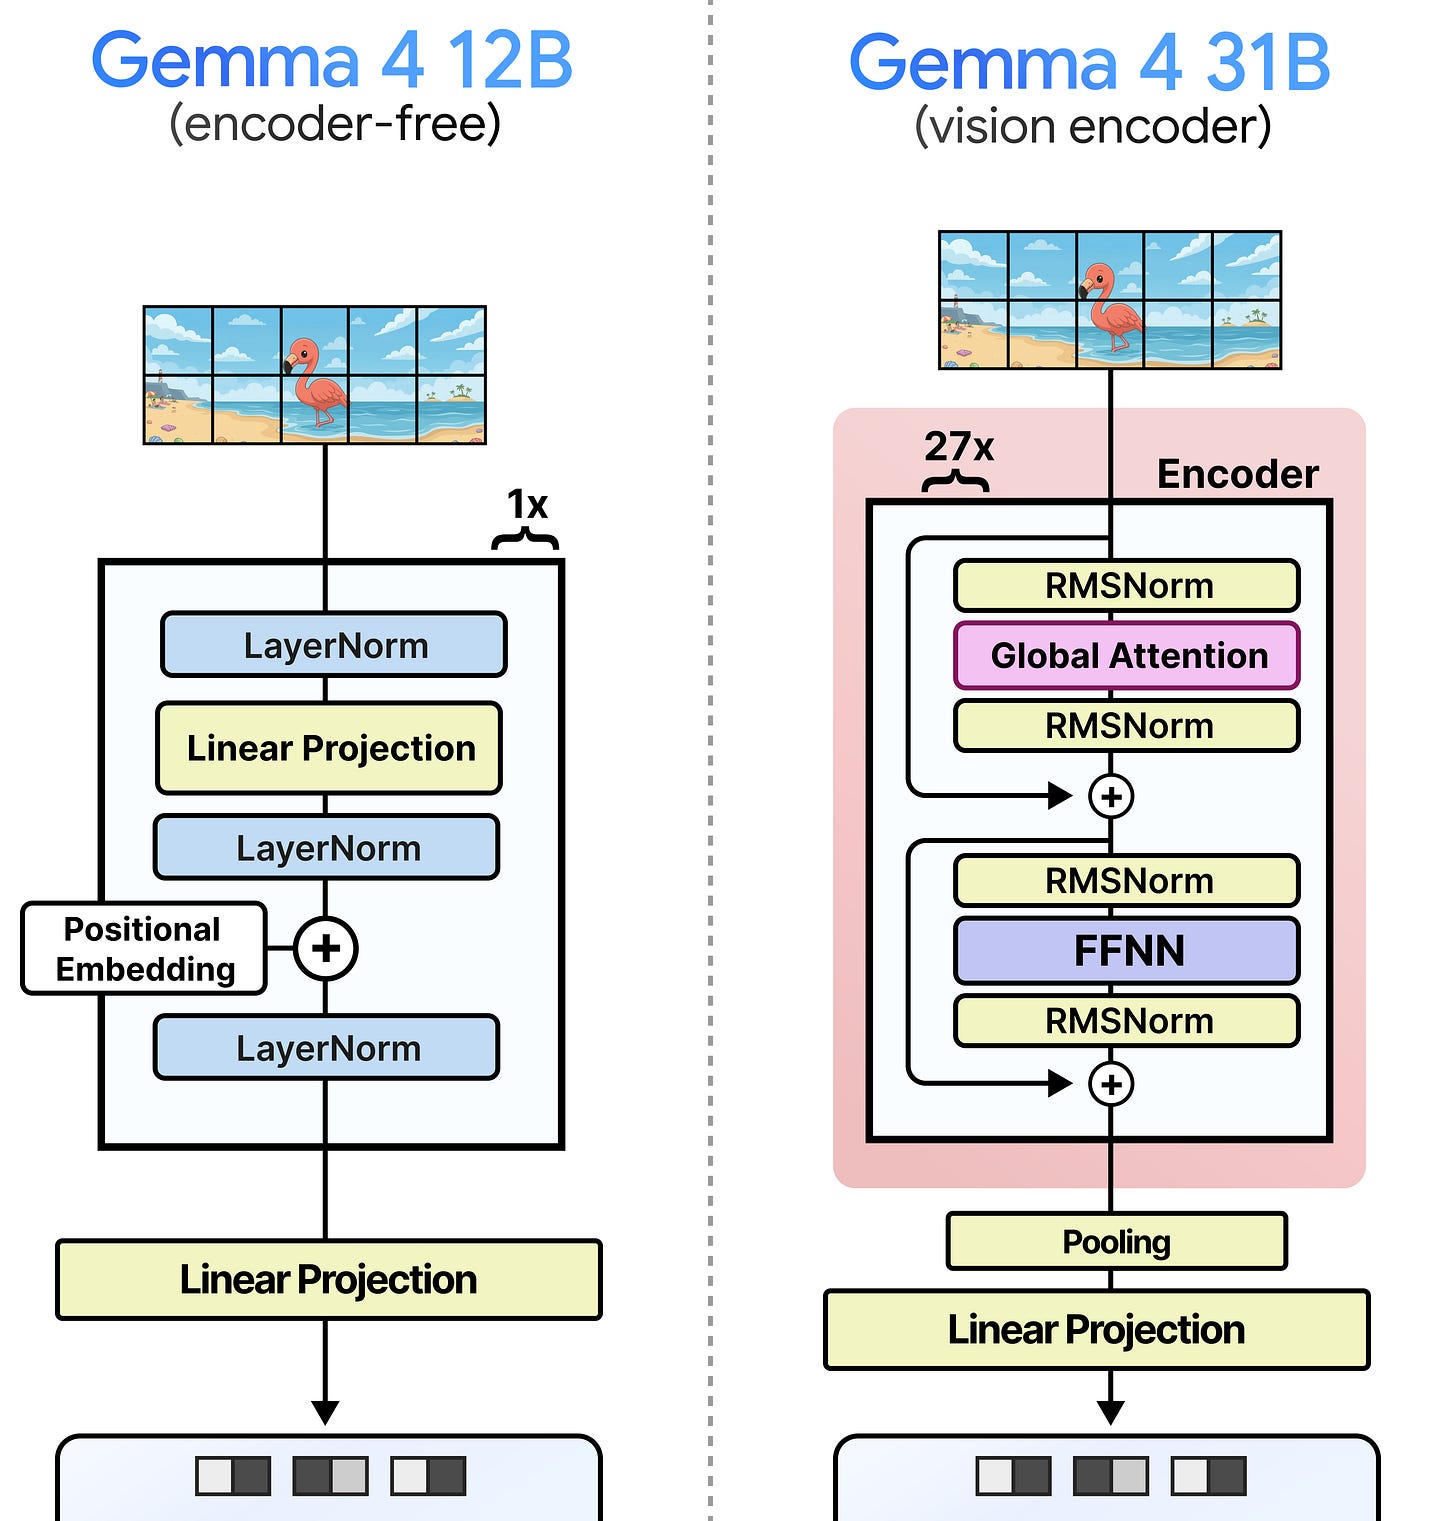
無編碼器模型的一大好處是,視覺詞元比起大型視覺編碼器能更快到達 LLM。因此,LLM 可以更早開始處理輸入、生成輸出!
取代音訊編碼器
取代音訊編碼器的做法與視覺編碼器類似,但更簡單!
不同於編碼器(主要目的是產生處理過的特徵),這裡直接使用原始音訊輸入,就像嵌入器直接使用原始像素一樣。對音訊來說這有個很大的優勢:不需要額外的位置嵌入!因為音訊本來就是一個二維序列,可以像文字序列一樣處理。
我們先把音訊輸入切成 40 毫秒的序列。音訊序列以每秒 16,000 個取樣(16 kHz)錄製,每個序列包含 640 個值。每個值代表聲波的高低。這些 640 個值合在一起就是原始振幅取樣,代表該序列的原始特徵。
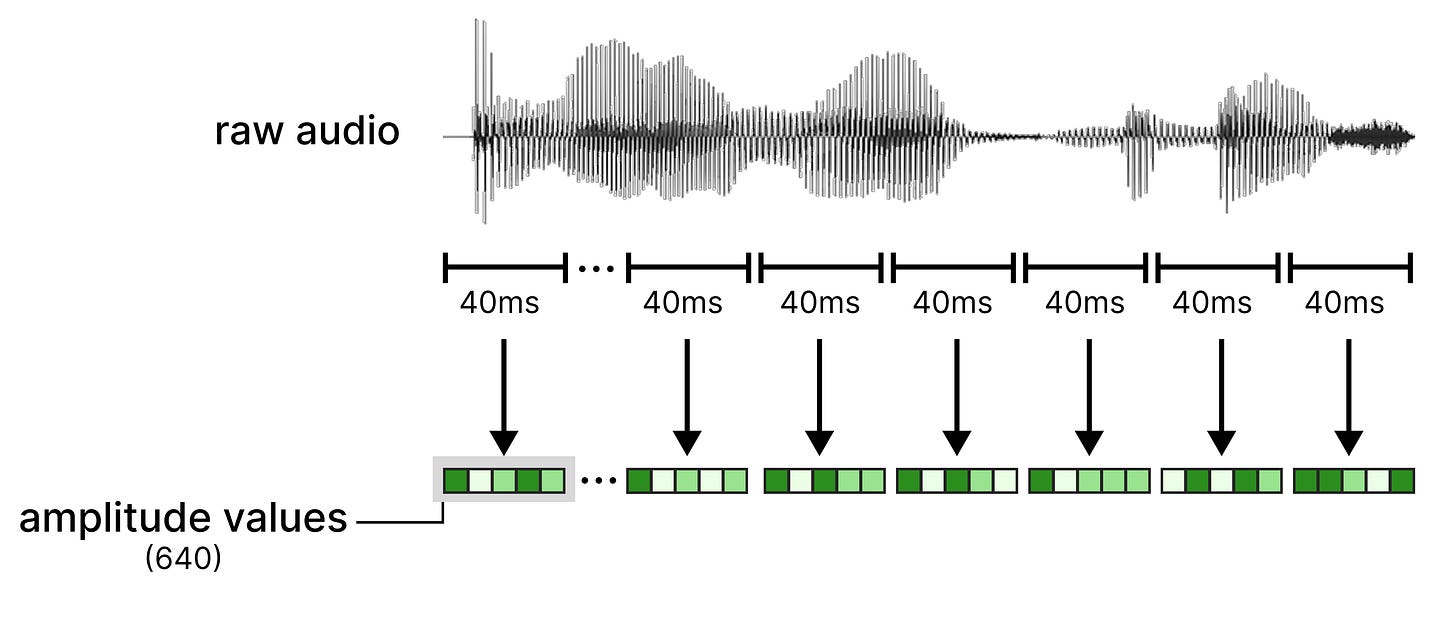
這些原始特徵接著交給一個線性投影層,使其維度與 Gemma 4 12B 預期的一致。
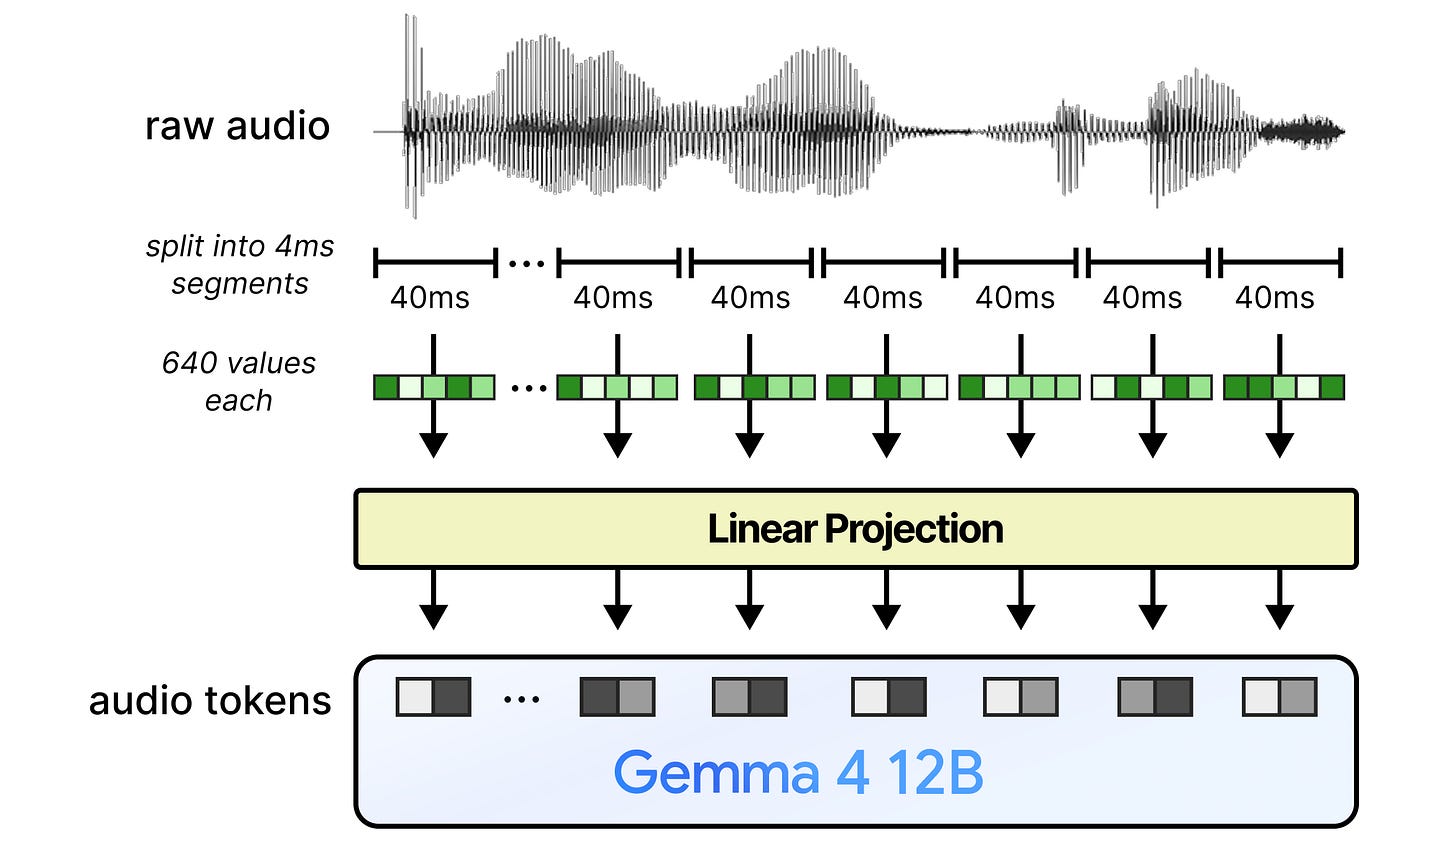
就這樣!真的,就只是移除編碼器、把原始特徵直接投影成與文字詞元相同的格式。
看看下圖,Gemma 4 12B 和 Gemma 4 E4B 在產生音訊詞元上的差異很大。Gemma 4 E4B 需要把音訊輸入詞元化,再經過堆疊的解碼器處理。Gemma 4 12B 則只做切割和投影,就這樣。
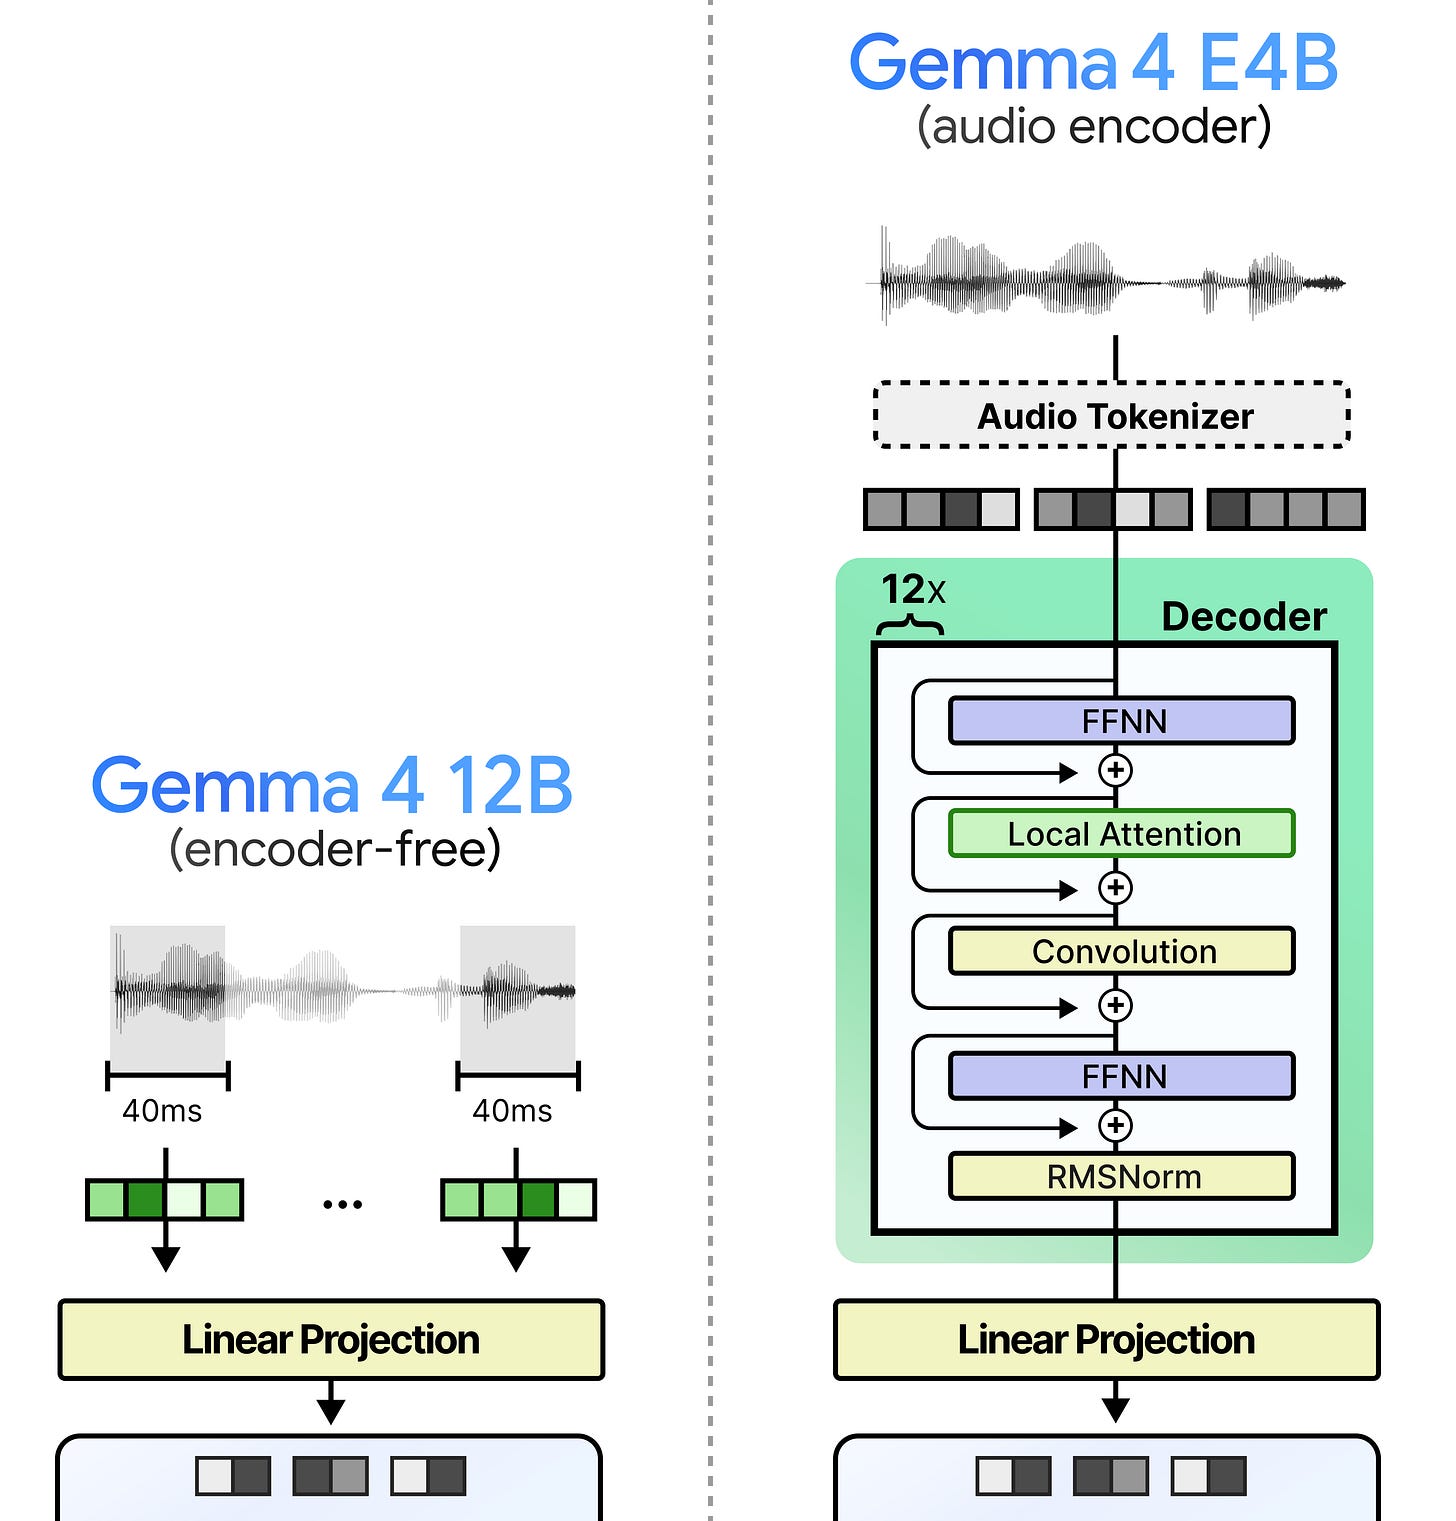
Gemma 4 12B 不只是一款正好落在 E4B 與 26B A4B 之間的模型,它的做法很不一樣,而且背後的原理相當有趣!